机器学习之逻辑回归原理以及Python实现
逻辑回归
逻辑回归和线型回归的比较:
1.都是线型模型
2.线型回归的y是连续型的,而逻辑回归是二分类的
3.他们的参数空间都是一致的,信息都蕴含在了w和b中。
1.逻辑回归的原理
1.1 逻辑回归的背景知识
由于逻辑回归的结果是分布在0-1区间,所以在线型回归的基础上做一个映射fff,即:
f(x11w1+x12w2+x13w3+...+x1jwj+...+x1mwm+b)=y^1f( x_{11} w_1 + x_{12} w_2 + x_{13} w_3 + ... + x_{1j} w_j + ... + x_{1m} w_m + b) = \hat y_1 f(x11w1+x12w2+x13w3+...+x1jwj+...+x1mwm+b)=y^1
f(x21w1+x22w2+x23w3+...+x2jwj+...+x2mwm+b)=y^2f( x_{21} w_1 + x_{22} w_2 + x_{23} w_3 + ... + x_{2j} w_j + ... + x_{2m} w_m + b) = \hat y_2 f(x21w1+x22w2+x23w3+...+x2jwj+...+x2mwm+b)=y^2
f(x31w1+x32w2+x33w3+...+x3jwj+...+x3mwm+b)=y^3f( x_{31} w_1 + x_{32} w_2 + x_{33} w_3 + ... + x_{3j} w_j + ... + x_{3m} w_m + b) = \hat y_3f(x31w1+x32w2+x33w3+...+x3jwj+...+x3mwm+b)=y^3
.........
f(xn1w1+xn2w2+xn3w3+...+xnjwj+...+xnmwm+b)=y^nf( x_{n1} w_1 + x_{n2} w_2 + x_{n3} w_3 + ... + x_{nj} w_j + ... + x_{nm} w_m + b) = \hat y_nf(xn1w1+xn2w2+xn3w3+...+xnjwj+...+xnmwm+b)=y^n
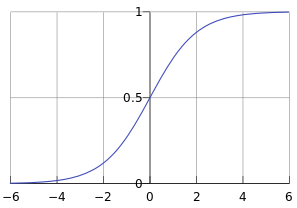
这个映射函数我们一般用sigmoid函数,函数形式如下所示:
f(x)=11+e−x f(x) = \frac{1}{1 + e^{-x}} f(x)=1+e−x1
函数图像:
对这个函数求一阶导数:
f′(x)=(11+e−x)′=−1(1+e−x)2(1+e−x)′=11+e−xe−x1+e−x=f∗(1−f)
\begin{aligned}
f'(x) &= (\frac{1}{1 + e^{-x}})'\\
&=- \frac{1}{{(1+e^{-x}})^2} (1+e^{-x})'\\
&=\frac{1}{1+e^{-x}} \frac{e^{-x}}{1+e^{-x}} \\
&=f*(1-f)
\end{aligned}
f′(x)=(1+e−x1)′=−(1+e−x)21(1+e−x)′=1+e−x11+e−xe−x=f∗(1−f)
方便起见:
xi=[xi1,xi2,xi3,...,xim] x_i = [x_{i1}, x_{i2}, x_{i3}, ..., x_{im}] xi=[xi1,xi2,xi3,...,xim]
w=[w1,w2,w3,...,wm]T w = {[w_1, w_2, w_3, ..., w_m]}^T w=[w1,w2,w3,...,wm]T
则:
y^i=f(xiw+b)=11+e−(xiw+b) \hat y_i = f(x_i w + b) = \frac{1}{1 + e^{-(x_i w +b)}} y^i=f(xiw+b)=1+e−(xiw+b)1
1.2 逻辑回归原理:
当xiw+b→∞x_i w +b \to \infinxiw+b→∞, e−(xiw+b)→0e^{-(x_i w +b)} \to 0e−(xiw+b)→0, 11+e−(xiw+b)→1\frac{1}{1 + e^{-(x_i w +b)}} \to 11+e−(xiw+b)1→1
故有:
p(yi=1∣xi;w,b)=f(xiw+b)=11+e−(xiw+b)(1) p(y_i=1|x_i; w,b) = f(x_i w + b) = \frac{1}{1 + e^{-(x_i w +b)}} \tag 1p(yi=1∣xi;w,b)=f(xiw+b)=1+e−(xiw+b)1(1)
p(yi=0∣xi;w,b)=1−f(xiw+b)=e−(xiw+b)1+e−(xiw+b)(2) p(y_i=0|x_i; w,b) = 1-f(x_i w + b) = \frac{e^{-(x_i w +b)}}{1 + e^{-(x_i w +b)}} \tag2p(yi=0∣xi;w,b)=1−f(xiw+b)=1+e−(xiw+b)e−(xiw+b)(2)
为什么说逻辑回归是线型模型?
决策边界来判断
决策边界p(yi=0)=p(yi=1)p(y_i=0) = p(y_i=1)p(yi=0)=p(yi=1)即:
11+e−(xiw+b)=e−(xiw+b)1+e−(xiw+b) \frac{1}{1 + e^{-(x_i w +b)}} =\frac{e^{-(x_i w +b)}}{1 + e^{-(x_i w +b)}} 1+e−(xiw+b)1=1+e−(xiw+b)e−(xiw+b)
1=e−(xiw+b) 1= e^{-(x_i w +b)} 1=e−(xiw+b)
(xiw+b)=0 (x_i w +b) = 0 (xiw+b)=0
这个决策边界函数是线型函数,所以逻辑回归模型是线型函数。
将(1)和(2)式可合并为:
p(yi∣xi;w,b)=[f(xiw+b)]yi[1−f(xiw+b)](1−yi) p(y_i|x_i; w,b) = [f(x_i w + b)] ^{y_i} [1-f(x_i w + b)]^{(1-y_i)} p(yi∣xi;w,b)=[f(xiw+b)]yi[1−f(xiw+b)](1−yi)
对所有样本求似然函数:
L(w,b)=∏i=1n[f(xiw+b)]yi[1−f(xiw+b)](1−yi) L(w,b) = \prod_{i=1}^{n} [f(x_i w + b)] ^{y_i} [1-f(x_i w + b)]^{(1-y_i)} L(w,b)=i=1∏n[f(xiw+b)]yi[1−f(xiw+b)](1−yi)
对数似然函数
logL(w,b)=log∏i=1n[f(xiw+b)]yi[1−f(xiw+b)](1−yi)\log L(w,b) = \log \prod_{i=1}^{n} [f(x_i w + b)] ^{y_i} [1-f(x_i w + b)]^{(1-y_i)} logL(w,b)=logi=1∏n[f(xiw+b)]yi[1−f(xiw+b)](1−yi)
似然函数求取的是最大值,所以损失函数(代价函数)可以定义为:
J(w,b)=−logL(w,b)=−∑i=1nyilog[f(xiw+b)]+(1−yi)log[1−f(xiw+b)] J(w,b) = -\log L(w, b) = -\sum_{i=1}^n y_i \log [f(x_i w + b)] + (1-y_i) \log [1-f(x_i w + b)] J(w,b)=−logL(w,b)=−i=1∑nyilog[f(xiw+b)]+(1−yi)log[1−f(xiw+b)]
1.3 算法求解
接下来求模型的参数w,bw, bw,b:
∂J(w,b)∂wj=∂∂wj{−∑i=1nyilog[f(xiw+b)]+(1−yi)log[1−f(xiw+b)]}=−∑i=1n{yi1f(xiw+b)−(1−yi)11−f(xiw+b)}∂f(xiw+b)∂wj=−∑i=1n{yi1f(xiw+b)−(1−yi)11−f(xiw+b)}f(xiw+b)[1−f(xiw+b)]∂(xiw+b)∂wj=−∑i=1n{yi[1−f(xiw+b)]−(1−yi)f(xiw+b)}∂(xiw+b)∂wj=−∑i=1n{yi[1−f(xiw+b)]−(1−yi)f(xiw+b)}xij=−∑i=1n{yi−f(xiw+b)}xij=∑i=1n{f(xiw+b)−yi}xij=∑i=1n{y^i−yi}xij
\begin{aligned}
\frac {\partial J(w,b)}{\partial w_j}
&= \frac {\partial}{\partial w_j} \{-\sum_{i=1}^n y_i \log [f(x_i w + b)] + (1-y_i) \log [1-f(x_i w + b)] \} \\
&= -\sum_{i=1}^n \{y_i \frac {1}{f(x_i w + b)} - (1-y_i) \frac {1}{1-f(x_i w + b)} \} \frac {\partial f(x_i w + b)} {\partial w_j} \\
&= -\sum_{i=1}^n \{y_i \frac {1}{f(x_i w + b)} - (1-y_i) \frac {1}{1-f(x_i w + b)} \} f(x_i w + b) [1-f(x_i w + b)] \frac {\partial (x_i w + b)} {\partial w_j} \\
&= -\sum_{i=1}^n \{y_i [1-f(x_i w + b)] - (1-y_i) f(x_i w + b) \} \frac {\partial (x_i w + b)} {\partial w_j} \\
&= -\sum_{i=1}^n \{y_i [1-f(x_i w + b)] - (1-y_i) f(x_i w + b) \} x_{ij} \\
&= -\sum_{i=1}^n \{y_i - f(x_i w + b) \} x_{ij} \\
&= \sum_{i=1}^n \{f(x_i w + b) - y_i \} x_{ij} \\
&= \sum_{i=1}^n \{\hat y_i - y_i \} x_{ij} \\
\end{aligned}
∂wj∂J(w,b)=∂wj∂{−i=1∑nyilog[f(xiw+b)]+(1−yi)log[1−f(xiw+b)]}=−i=1∑n{yif(xiw+b)1−(1−yi)1−f(xiw+b)1}∂wj∂f(xiw+b)=−i=1∑n{yif(xiw+b)1−(1−yi)1−f(xiw+b)1}f(xiw+b)[1−f(xiw+b)]∂wj∂(xiw+b)=−i=1∑n{yi[1−f(xiw+b)]−(1−yi)f(xiw+b)}∂wj∂(xiw+b)=−i=1∑n{yi[1−f(xiw+b)]−(1−yi)f(xiw+b)}xij=−i=1∑n{yi−f(xiw+b)}xij=i=1∑n{f(xiw+b)−yi}xij=i=1∑n{y^i−yi}xij
同理可得:
∂J(w,b)∂b=∑i=1nf(xiw+b)−yi=y^i−yi \frac {\partial J(w,b)}{\partial b} = \sum_{i=1}^n f(x_i w + b) - y_i = \hat y_i - y_i ∂b∂J(w,b)=i=1∑nf(xiw+b)−yi=y^i−yi
可以用梯度下降法进行对www和bbb进行求解:
wj=wj−α∑i=1n(f(xiw+b)−yi)xij w_j = w_j - \alpha \sum_{i=1}^{n} {(f(x_i w + b) - y_i)} x_{ij}wj=wj−αi=1∑n(f(xiw+b)−yi)xij
b=b−α∑i=1n(f(xiw+b)−yi) b = b - \alpha \sum_{i=1}^{n} {(f(x_i w + b) - y_i)} b=b−αi=1∑n(f(xiw+b)−yi)
也可以随机梯度下降法(SGD):
for i=1 to n:
wj=wj−α(f(xiw+b)−yi)xij w_j = w_j - \alpha {(f(x_i w + b) - y_i)} x_{ij}wj=wj−α(f(xiw+b)−yi)xij
b=b−α(f(xiw+b)−yi) b = b -\alpha {(f(x_i w + b) - y_i)} b=b−α(f(xiw+b)−yi)
当然也可以用批量随机梯度下降法,即循环多次,每次从样本中随机取出一部分样本迭代参数。上式中α\alphaα为学习率。
2.逻辑回归Python实现
2.1 逻辑回归模型实现
import numpy as np

class MyLogisticRegression(object):
    def __init__(self, lr=0.01, n_epoch=50):
        """
        逻辑回归模型,通过随机梯度下降法实现
        :param lr: 学习率,默认值0.01
        :param n_epoch: 训练循环次数,默认值50
        """
        self.lr = lr
        self.n_epoch = n_epoch
        self.params = {'w': None, 'b': 0}

    def __init_params(self, m):
        """
        初始化参数,正态分布
        :param m: 特征维度数,和w的个数相对应
        :return: None
        """
        self.params['w'] = np.random.randn(m)

    def fit(self, X, y):
        """
        训练模型,随机梯度下降法训练模型
        w_j = w_j - lr * (f(x_i @ w) - y_i) * x_ij
        b = b - lr * (f(x_i @ w) - y_i)
        :param X: 训练数据X,shape(n, m), n代表训练样本个数,m代表每个样本的特征维度数
        :param y: 训练数据y, shape(n)
        :return: None
        """
        X = np.array(X)
        # n 样本数量, m 一个样本的特征维度数量
        n, m = X.shape
        self.__init_params(m)

        for _ in range(self.n_epoch):
            for x_i, y_i in zip(X, y):
                for j in range(m):
                    self.params['w'][j] = self.params['w'][j] - self.lr * (sigmoid(np.dot(x_i, self.params['w'].T) + self.params['b']) - y_i) * x_i[j]
                self.params['b'] = self.params['b'] - self.lr * (sigmoid(np.dot(x_i, self.params['w'].T)+ self.params['b']) - y_i)

    def predict(self, X):
        """
        预测模型结果
        :param X: 二维数据,shape(n,m),n代表个数,m代表单个样本的维度数
        :return: y shape(n), 预测结果
        """
        return sigmoid(np.dot(X, self.params['w'].T) + self.params['b'])


def sigmoid(x):
    return 1 / (1 + np.exp(-x))
2.2 结果验证
def get_samples(n_ex=100, n_classes=2, n_in=1, seed=0):
    # 生成100个样本,为了能够在二维平面上画出图线表示出来,每个样本的特征维度设置为1
    from sklearn.datasets.samples_generator import make_blobs
    from sklearn.model_selection import train_test_split
    X, y = make_blobs(
        n_samples=n_ex, centers=n_classes, n_features=n_in, random_state=seed
    )
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.3, random_state=seed
    )
    return X_train, y_train, X_test, y_test


def run_my_model():
    from matplotlib import pyplot as plt
    my = MyLogisticRegression()
    X_train, y_train, X_test, y_test = get_samples()
    my.fit(X_train, y_train)

    y_pred = my.predict(X_test)
    print(y_pred, y_test)

    # 画图
    fig, ax = plt.subplots()
    ax.scatter(X_test, y_test, c='red', label='real')
    ax.scatter(X_test, y_pred, label='pred')
    ax.legend()
    plt.show()
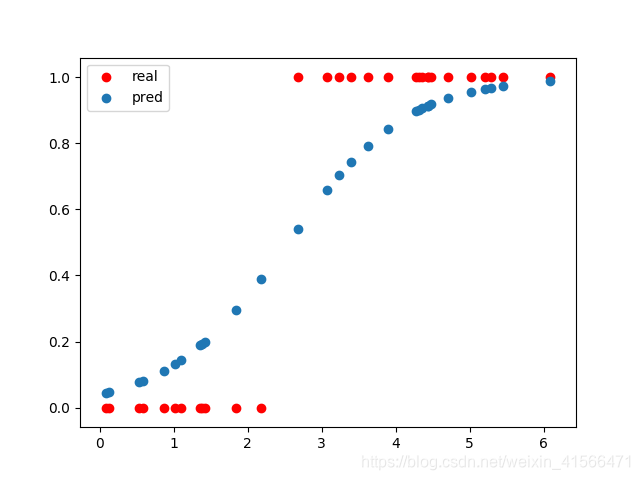
预测结果如下图所示:

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 5
 0
- 0


 已为社区贡献6条内容

所有评论(0)