python3.6实现随机森林算法(可视化)机器学习算法(赵志勇)学习笔记
·
# coding=utf-8
import numpy as np
import random as rd
from math import log
import matplotlib.pyplot as plt
from tree import build_tree, predict
import pickle


def random_forest_training(data_train, trees_num):
    ''' 构建随机森林
    :param data_train:(list)训练数据
    :param trees_num:(int)分类树个数
    :return: trees_result(list)每棵树的最好划分
            trees_feature(list)每棵树中对原始特征的选择
    '''
    trees_result = []
    trees_feature = []
    n = np.shape(data_train)[1]  # 样本的维度,即样本个数是mxn,此处n是列,包含数据和结果,因此其特征值个数是n也就是2

    if n > 2:
        k = int(log(n - 1, 2)) + 1  # 设置特征值个数
    else:
        k = 1
    # 开始构建每一课树,需要分类树的个数
    for i in range(trees_num):
        # 1. 随机选择m个样本,k个特征(打乱数据的数据编号,随机分配index,再将数据组合,返回data_samples)
        data_samples, feature = choose_samples(data_train, k)
        # 2. 构建每一棵分类树(建立tree的class)
        tree = build_tree(data_samples)
        # 3. 保存训练好的分类树
        trees_result.append(tree)
        # 4.保存好该分类树使用到的特征
        trees_feature.append(feature)

    return trees_result, trees_feature


def choose_samples(data, k):
    ''' 从样本中随机选择样本及其特征,随机分配选择数据的index,返回重新组合的数据
    :param data: (list)原始数据集
    :param k: (int)选择特征的个数
    :return: data_samples(list)被选择出来的样本
            feature(list)被选择的特征索引index
    '''
    m, n = np.shape(data)  # 样本的个数和样本特征的个数
    # 1.选择出k个特征的index
    feature = []
    for j in range(k):
        feature.append(rd.randint(0, n - 2))  # n-1列是标签
    # 2.选择出m个样本的index
    index = []
    for i in range(m):
        index.append(rd.randint(0, m - 1))
    # 3.从data中选择出m个样本的k个特征,组成数据集data_samples
    data_samples = []
    for i in range(m):
        data_tmp = []
        for fea in feature:
            data_tmp.append(data[index[i]][fea])
        data_tmp.append(data[index[i]][-1])
        data_samples.append(data_tmp)
    return data_samples, feature


def load_data(file_name):
    data_train = []
    f = open(file_name)
    for line in f.readlines():
        lines = line.strip().split('\t')
        data_tmp = []
        for x in lines:
            data_tmp.append(float(x))
        data_train.append(data_tmp)
    f.close()
    return data_train


def get_predict(trees_result, trees_feature, data_train):
    '''利用训练好的随机森林模型对样本进行预测
    :param trees_result:
    :param trees_feature:
    :param data_train:
    :return:
    '''
    m_tree = len(trees_result)     # 手动设置的50个树节点
    m = np.shape(data_train)[0]
    result = []
    for i in range(m_tree):
        clf = trees_result[i]
        feature = trees_feature[i]
        data = split_data(data_train, feature)
        result_i = []
        for j in range(m):
            # 查看每个样本与计算出来的树比较,判断数据是左、右子树
            result_i.append(list(predict(data[j][0:-1], clf).keys())[0])
        result.append(result_i)
    final_predict = np.sum(result, axis=0)
    return final_predict


def split_data(data_train, feature):
    m = np.shape(data_train)[0]
    data = []
    for i in range(m):
        data_x_tmp = []
        for x in feature:
            data_x_tmp.append(data_train[i][x])
        data_x_tmp.append(data_train[i][-1])
        data.append(data_x_tmp)
    return data


def cal_correct_rate(data_train, final_predict):
    ''' 计算模型的预测准确性
    :param data_train:
    :param result:
    :return:
    '''
    m = len(final_predict)
    corr = 0.0
    for i in range(m):
        if data_train[i][-1] * final_predict[i] > 0:
            corr += 1
    return corr / m


def save_model(trees_result, trees_feature, result_file, feature_file):
    m = len(trees_feature)
    f_fea = open(feature_file, 'w')
    for i in range(m):
        fea_tmp = []
        for x in trees_feature[i]:
            fea_tmp.append(str(x))
        f_fea.writelines('\t'.join(fea_tmp))
        f_fea.write('\n')
    f_fea.close()

    with open(result_file, 'wb') as f:
        pickle.dump(trees_result, f)


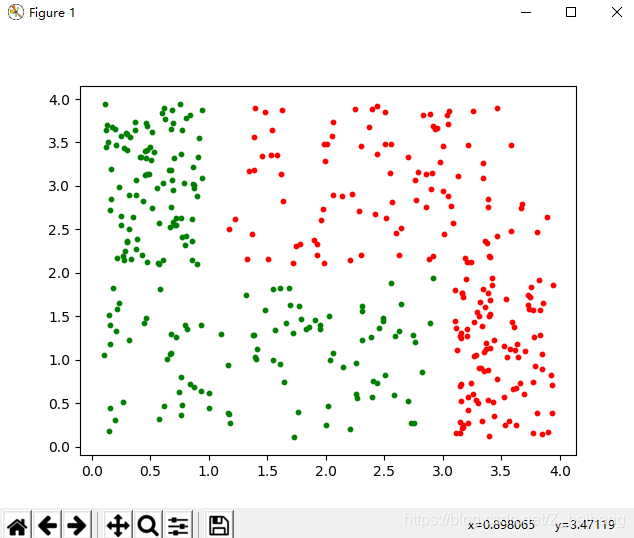
def draw(file_name):
    x0List = []
    y0List = []
    x1List = []
    y1List = []

    f = open(file_name, 'r')
    for line in f.readlines():
        lines = line.strip().split()
        if lines[2] == '1':
            x0List.append(float(lines[0]))
            y0List.append(float(lines[1]))
        else:
            x1List.append(float(lines[0]))
            y1List.append(float(lines[1]))

    fig = plt.figure()
    ax = fig.add_subplot(111)
    ax.scatter(x0List, y0List, s=10, c='red')
    ax.scatter(x1List, y1List, s=10, c='green')
    plt.show()


if __name__ == '__main__':
    # 1.导入训练数据
    print('------1. load data-----')
    data_train = load_data('data.txt')
    # print(feature)
    # 2.训练随机森林模型
    print('-----2. random forest training-----')
    trees_result, trees_feature = random_forest_training(data_train, 50)
    # 3.保存最终的模型
    print('----3.get prediction correct rate----')
    result = get_predict(trees_result, trees_feature, data_train)
    corr_rate = cal_correct_rate(data_train, result)
    print('\t---correct rate:{}----'.format(corr_rate))
    # 4.保存模型
    print('-----4. save model------')
    save_model(trees_result, trees_feature, 'result_file', 'feature_file')
    draw('data.txt')
结果如图:

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)