吴恩达机器学习——强化学习理论知识,个人学习笔记
引言:强化学习部分的内容很杂,为此从头到尾梳理了一遍。
本篇文章仅用于梳理,适合复习。
涉及的知识点不会详细讲述(可以看参考资料中的视频),请见谅。
目录
1. 从哪里开始?—— 马尔可夫决策(MDP)
强化学习是机器学习的一个重要分支,
对于强化学习,我们从两大特点入手:
- 奖惩措施(自设)
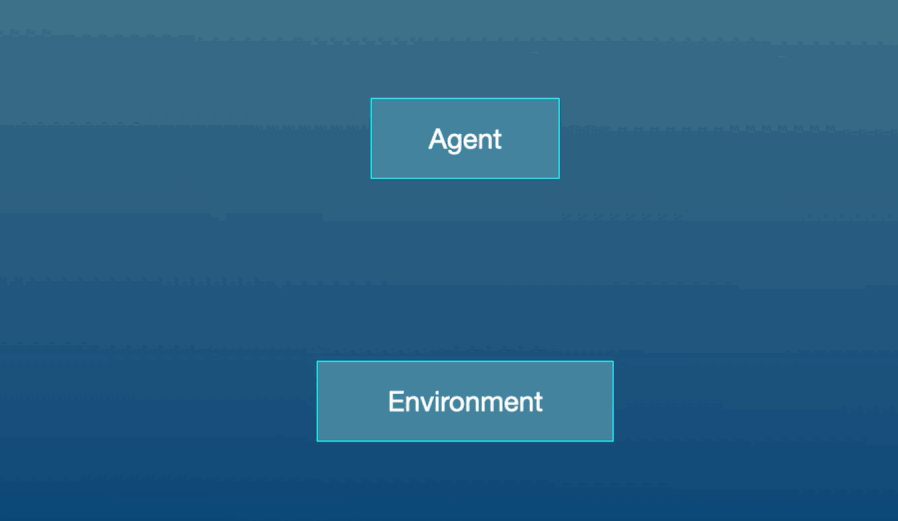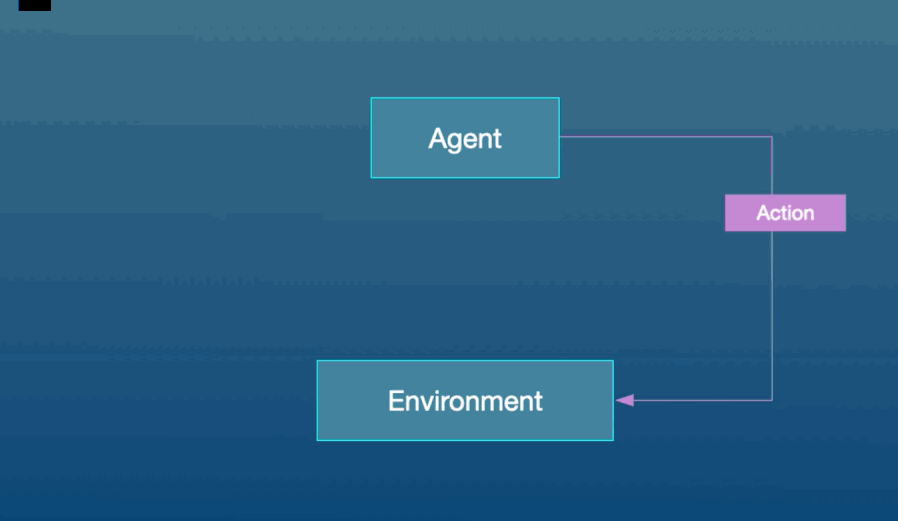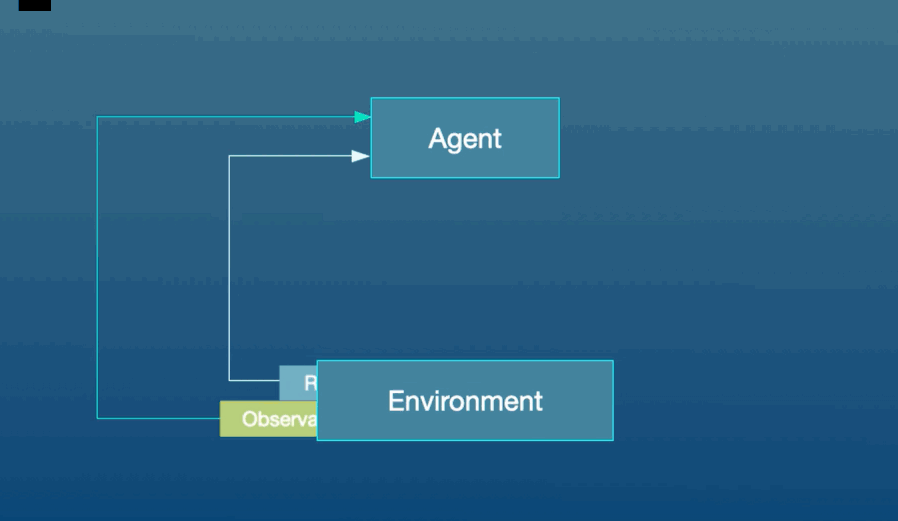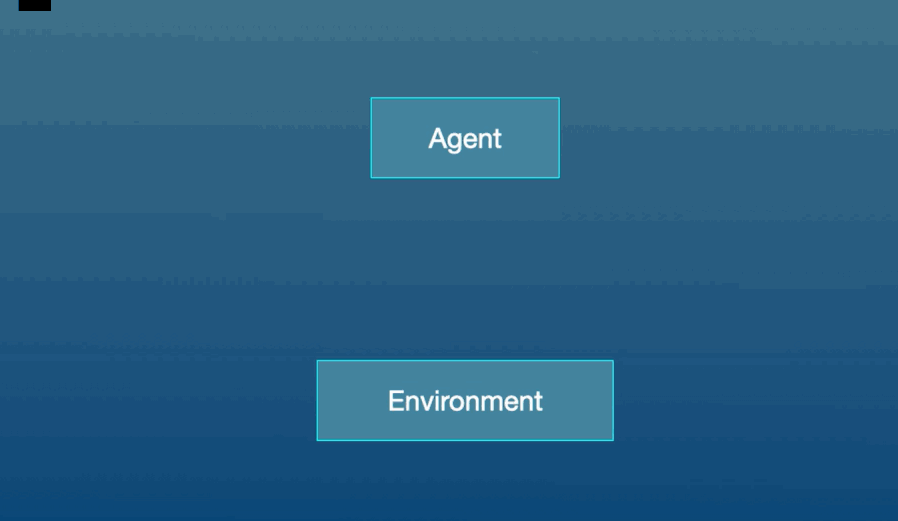
- 智能体(Agent)与环境(Environment)之间的交互关系
其中智能体与环境之间的交互,遵循这样的数学模型,即马尔可夫决策(MDP):
MDP假设智能体未来的状态 仅取决于 当前的状态(state)和采取的行动(action),而与历史状态无关。在整个决策过程,智能体和环境不断进行以下交互:智能体执行动作,环境则返回立即奖励(reward)和下一个状态,从而形成一个状态-动作-奖励的循环。
这种学习方式使得智能体能够在不确定的环境中通过试错学习最优策略,逐步提升性能并逼近最优解。
MDP是强化学习的理论基石,要牢记!!!之后的所有知识都是建立在这个基础上的。
警告:后方大量知识点来袭!
2. 解决关键要素,即搞定强化学习:
MDP包含以下组成要素,而这也是强化学习的关键要素,分别为:
- 状态(state)
- 动作(action)
- 奖惩措施(rewards)
- 折扣因子γ(discount factor)
- 回报(return)
- 策略π(policy)
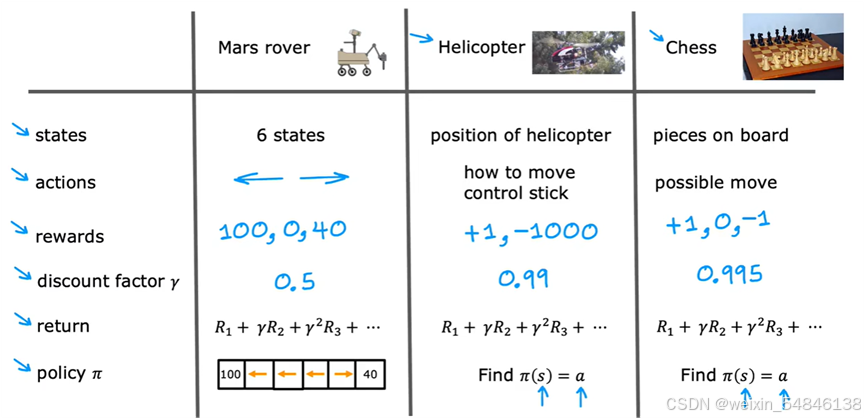
其他的很容易理解,只有折扣因子γ、回报和策略π需要进一步解释:
2.1 为什么要引入折扣因子?
我们希望智能体以 尽可能少的步骤 获得 更多的奖励,因此引入了折扣因子γ。其取值范围为(0, 1)。
- 接近0时,智能体更加重视短期奖励;
- 接近1时,智能体更加重视长期累计奖励。
2.2 引入折扣因子γ后,总回报的计算公式为:
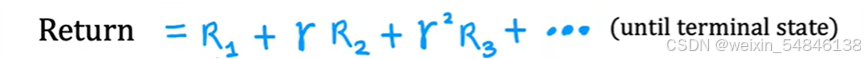
随着时间的推移,有了折扣因子的存在,智能体未来得到的奖励将大打折扣。
2.3 什么是策略π?
其实就是动作到状态之间的映射关系。大白话讲,我们想知道采取这个动作会导致怎样的结果。如果能获取这个信息,那么每次就可以选取能获得最大回报的动作执行,即最优策略。
3. 如何找到最优策略?
问题来了,策略是个好东西,但策略长啥样?不清楚。
所以我们需要借助工具状态-动作 价值函数(习惯上称为Q函数。以下都称为Q函数)用以辅助我们做出决策。
3.1 状态-动作 价值函数的定义如下:
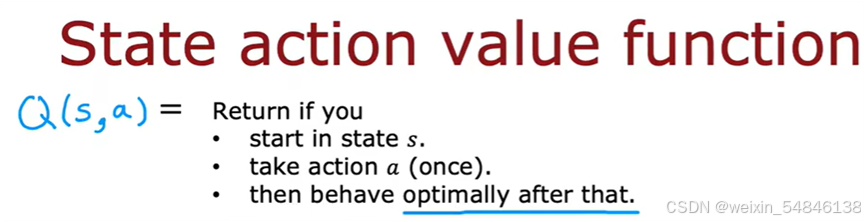
显然,这是一个关于 状态 和 动作 的函数,其结果为我们在整个决策过程中所获得的价值。 这是一个递归的定义。以离散模型进行举例说明Q值的作用:
共有6个状态,其中1、6为最终状态。根据回报公式 和 Q函数的定义,可以计算出Q(s, a)值:
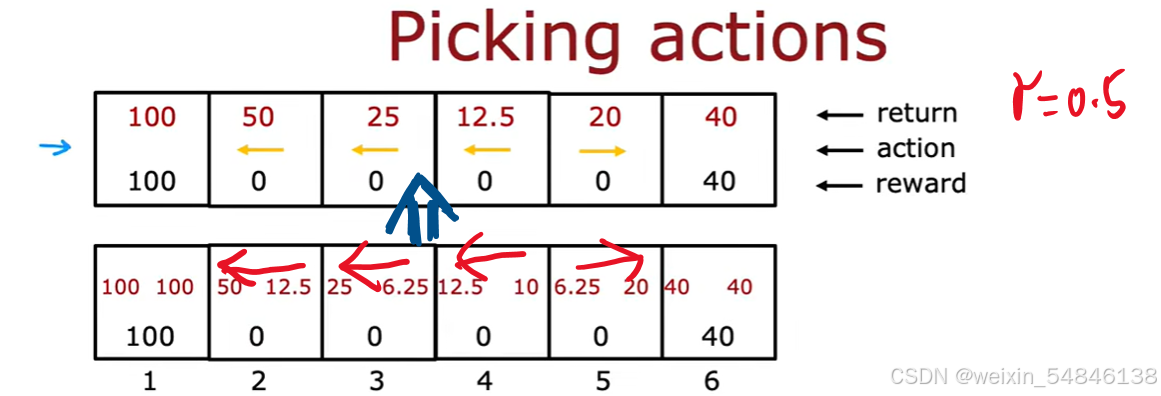
从上面的例子中,我们发现,计算出每个状态所有可能的Q值,挑选最大的Q值的动作a,则能获得最优策略。
3.2 为了计算Q值,我们需要用到贝尔曼方程:
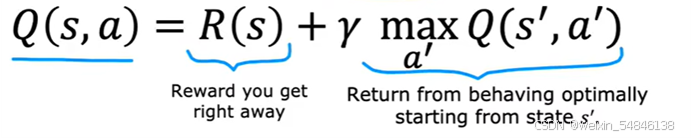
贝尔曼期望方程用于计算在给定策略π下,状态s采取动作a时的期望回报。它将Q函数表示为 当前奖励 和 未来期望回报的期望值。
但不一定每次执行动作就能到达预期状态,考虑到失误的可能性,对贝尔曼方程做一些改进:
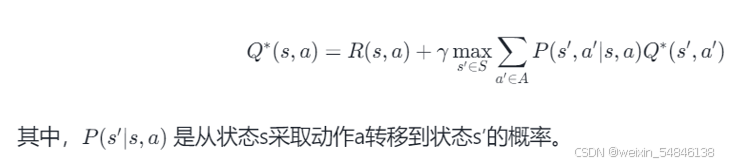
4. 小结:
在强化学习中,我们要做的事情有:
1、基于MDP,我们首先需要明确几个关键要素:状态、可采取的行动、奖惩措施、折扣因子。这些都是我们自己可以指定的。
2、之后,为了找到最优策略π(使我们的总回报最大化),需要计算每个状态的最优Q值,这可以用贝尔曼方程来计算。
但是——Q值我们不能直接拿贝尔曼方程来计算。
因为在强化学习中,状态空间和动作空间一般都非常大或非常复杂。在这种情况下,直接存储和计算所有状态-动作对的Q值是不可行的,因为需要大量的内存和计算资源。为了解决这个问题,我们可以使用函数近似器(如神经网络)来近似Q函数。
函数近似器的作用是学习一个函数,该函数能够为每个状态-动作对提供近似的Q值。
为了用神经网络近似Q函数,我们要设计一个算法,即DQN(Deep Q-Learning)算法。
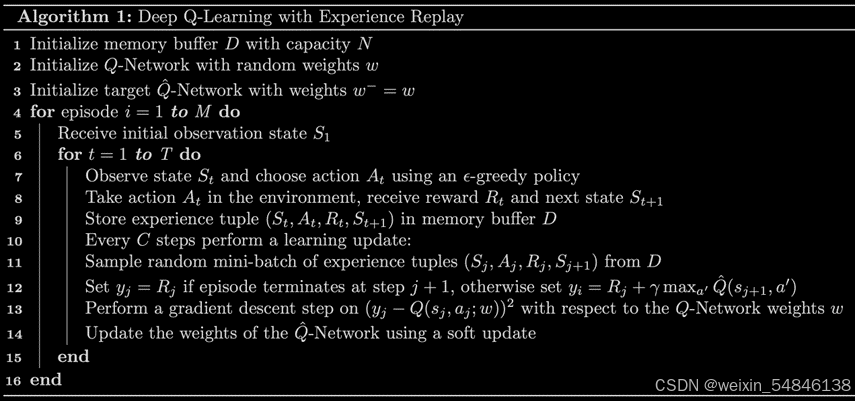
具体DQN算法的细节,这里先不展开,到时候在另一篇文章进行整理。
参考资料:

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 27
 0
- 0


 已为社区贡献1条内容

所有评论(0)