Neural Network(神经网络)基本概念
Neural Network(神经网络)基本概念
1、Regression(回归)
输出数值
2、Classification(分类)
在不同选项中进行选择
3、Model(模型)
简单的线性模型示例:y=b+wx1y = b + wx_1y=b+wx1
x为输入,y为输出(预测),w为权重,b为偏置
4、Loss函数
Loss是关于模型函数中未知参数的函数,用来体现w与b在模型中好与不好,用L(w,b)L(w,b)L(w,b)表示。
在训练集数据中, 通过将xix_ixi输入进模型函数得到输出yiy_iyi与真实数据lable做差,得到ei=∣y−lable∣e_i=|y-lable|ei=∣y−lable∣,然后累加求平均得到
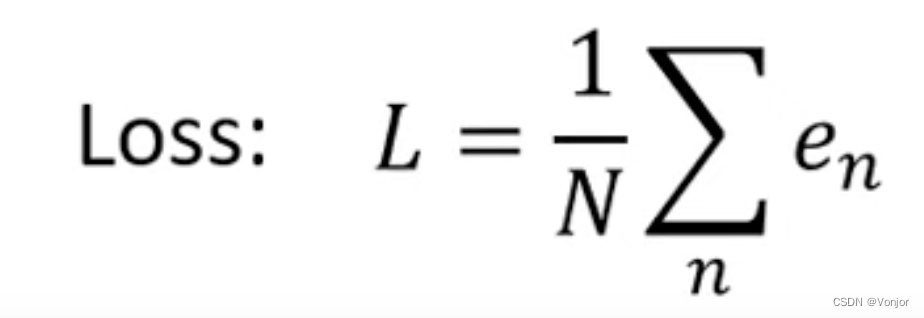
误差e的求法有多种,上述求法为MAE(mean absolute error),即绝对误差平均值。另一种比较常见的是MSE(Mean Squared Error)的缩写,即均方误差,MSE的算式为e=(y−lable)2e=(y-lable)^2e=(y−lable)2。
交叉熵损失函数
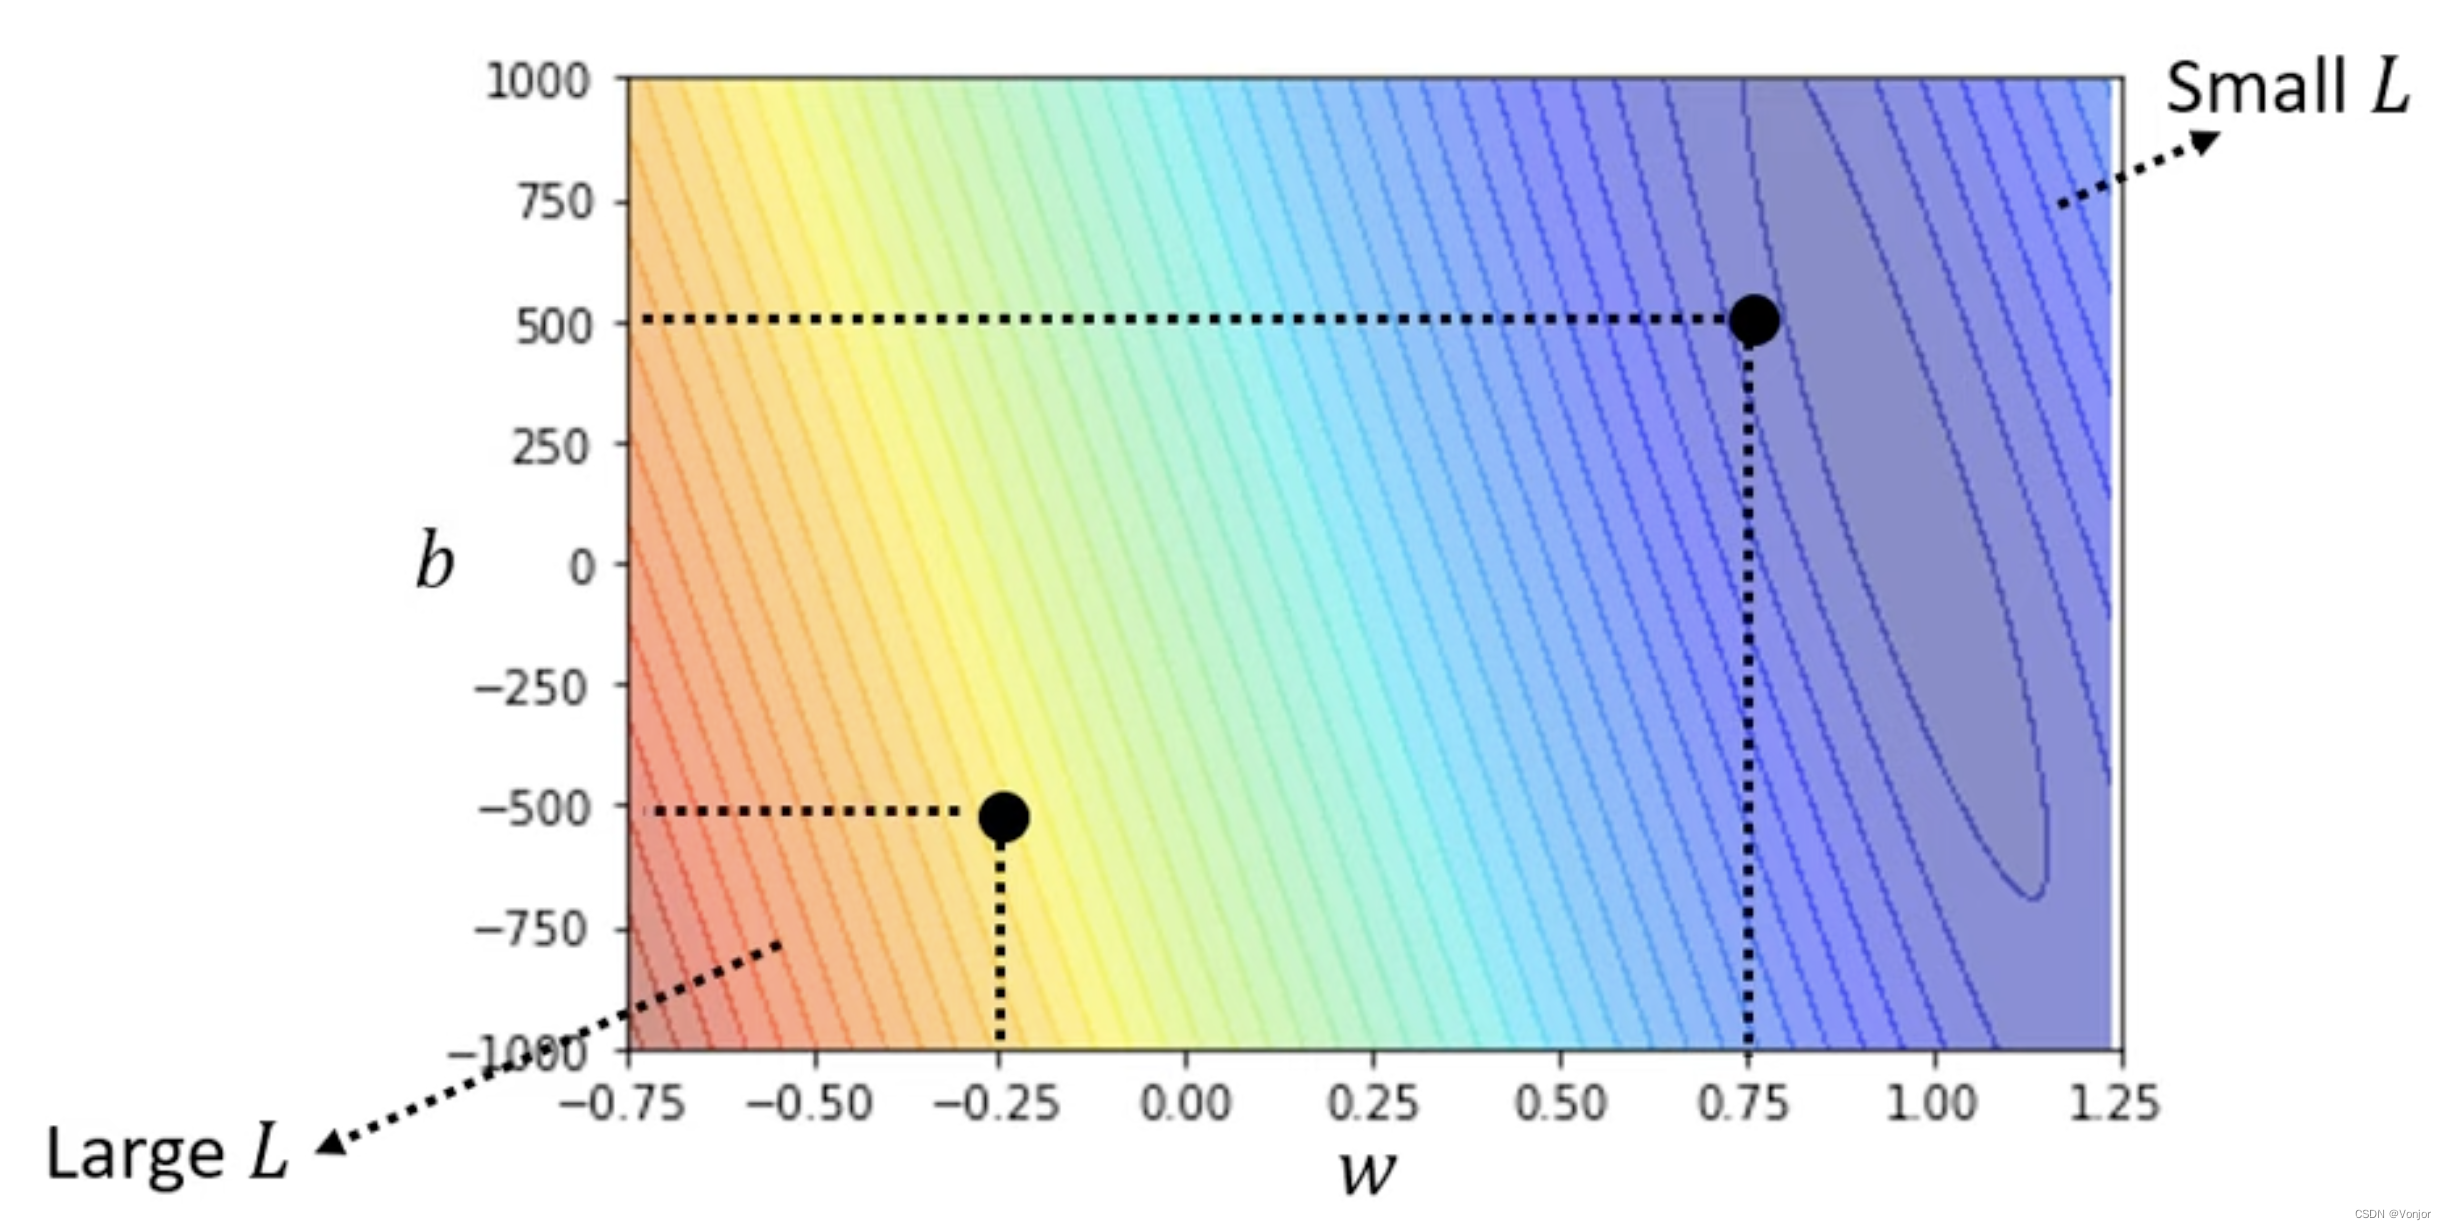
上图为一个error surface的举例
5、Optimization(优化)
即找到使Loss值最小的w与b得方法,使用gradient descent(梯度下降)方法来进行这个优化过程。
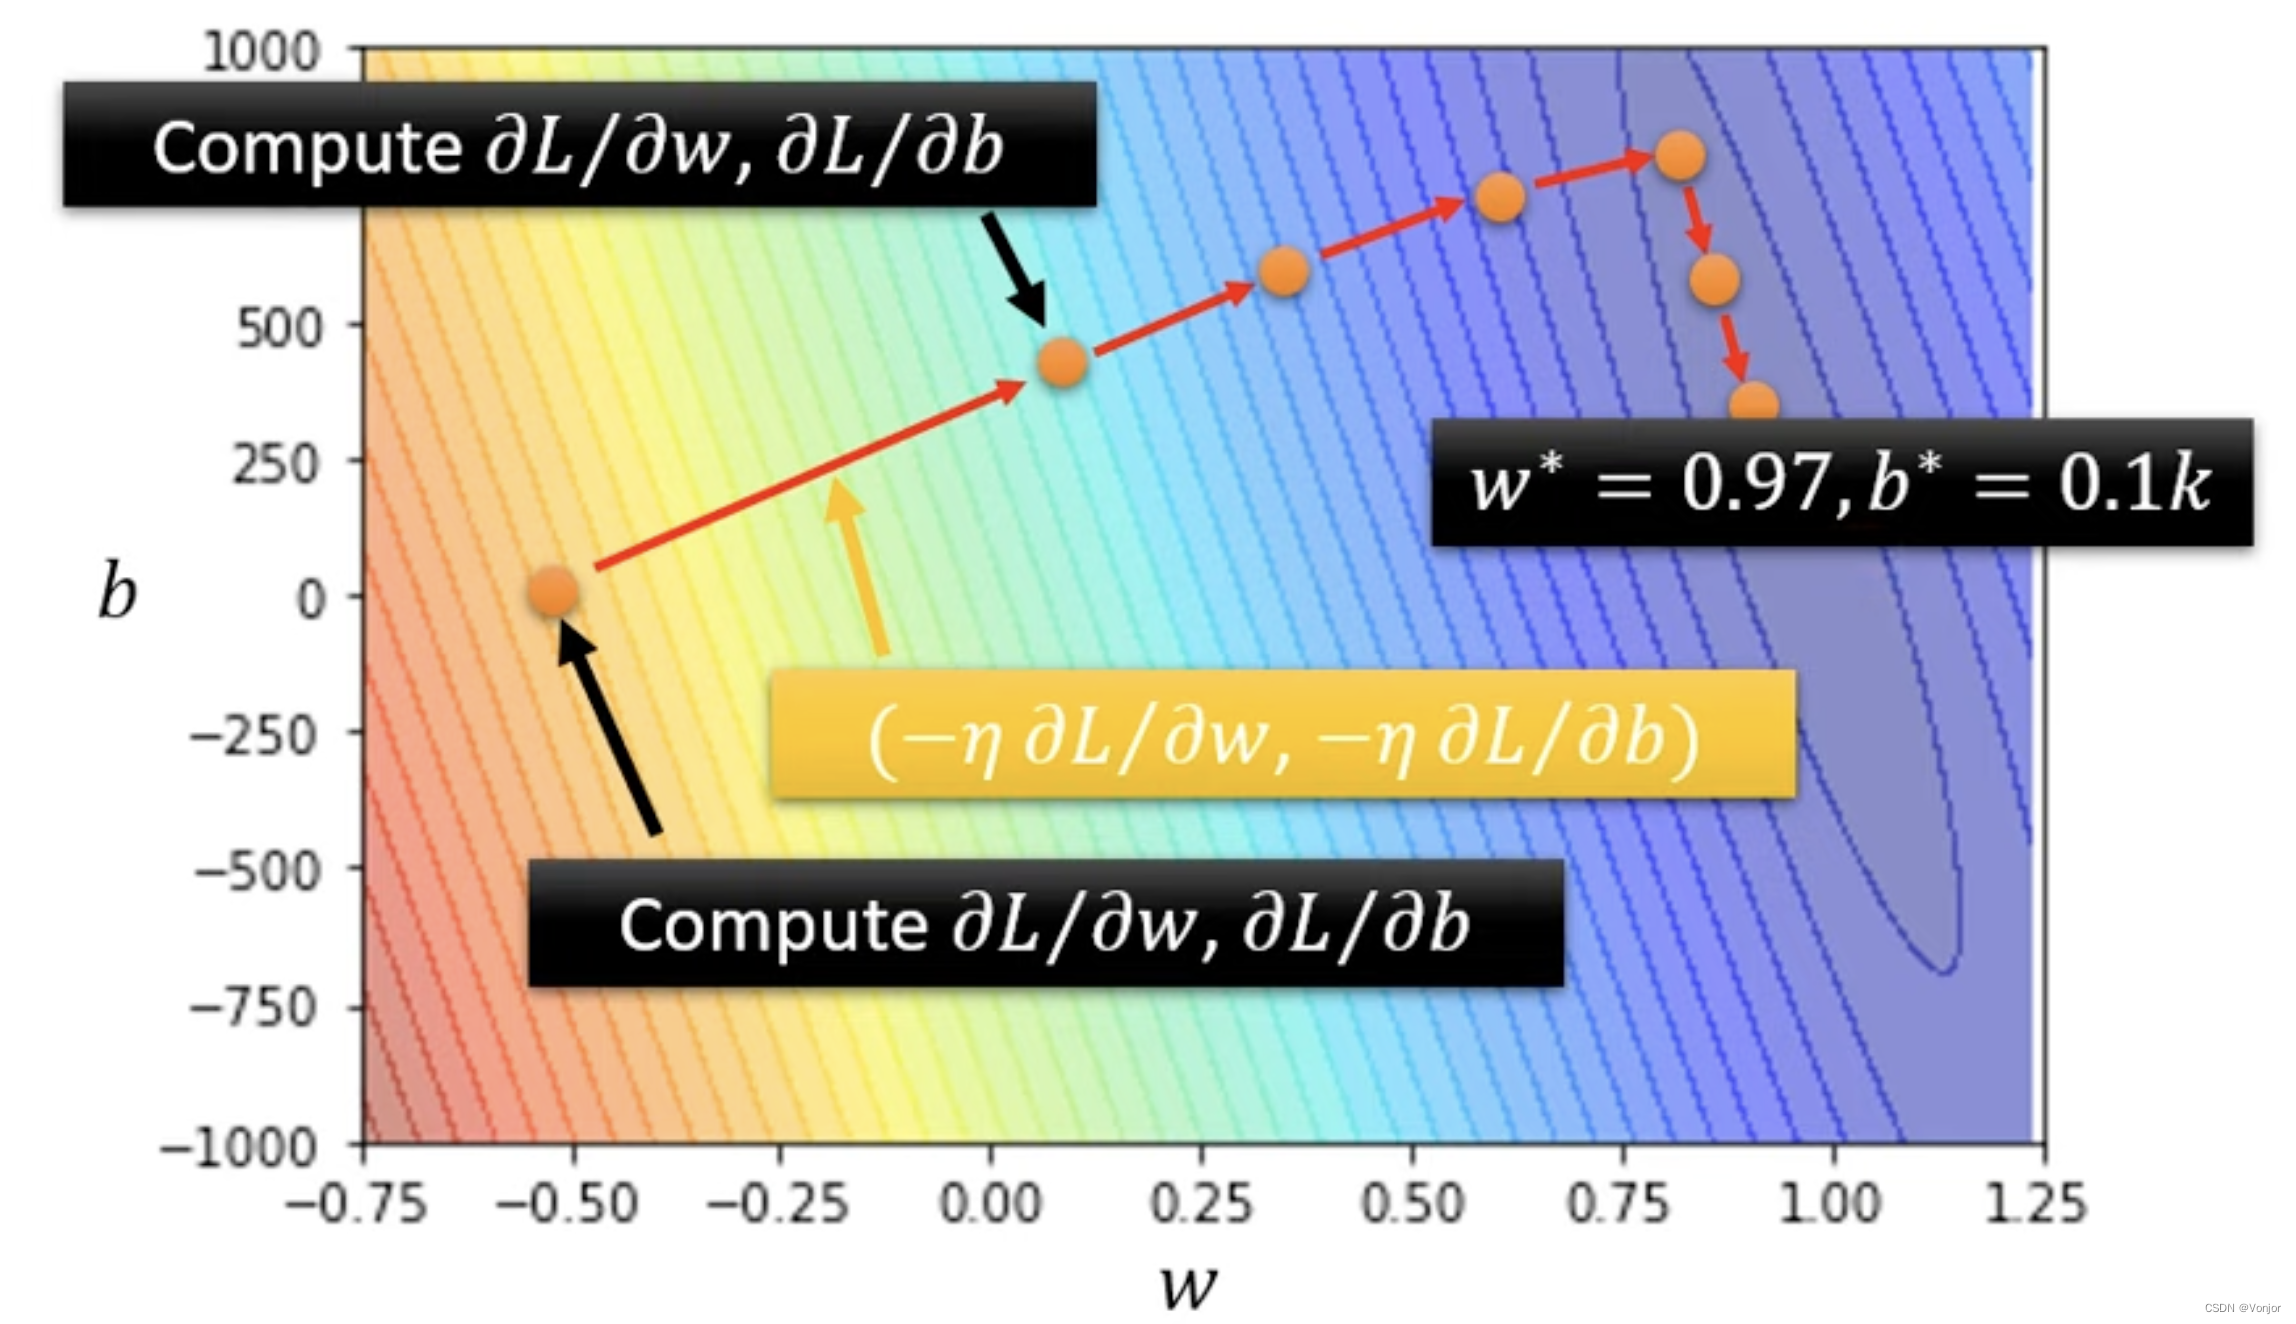
由于L(w,b)L(w,b)L(w,b)有两个自变量w与b,所以分别求关于w的偏导数与关于b的偏导数。
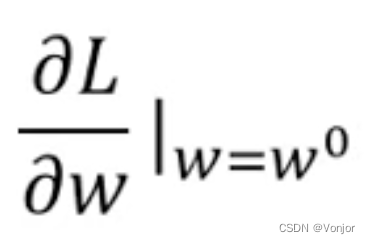
对于w与b随机赋一个初始值,以w为例,见下图
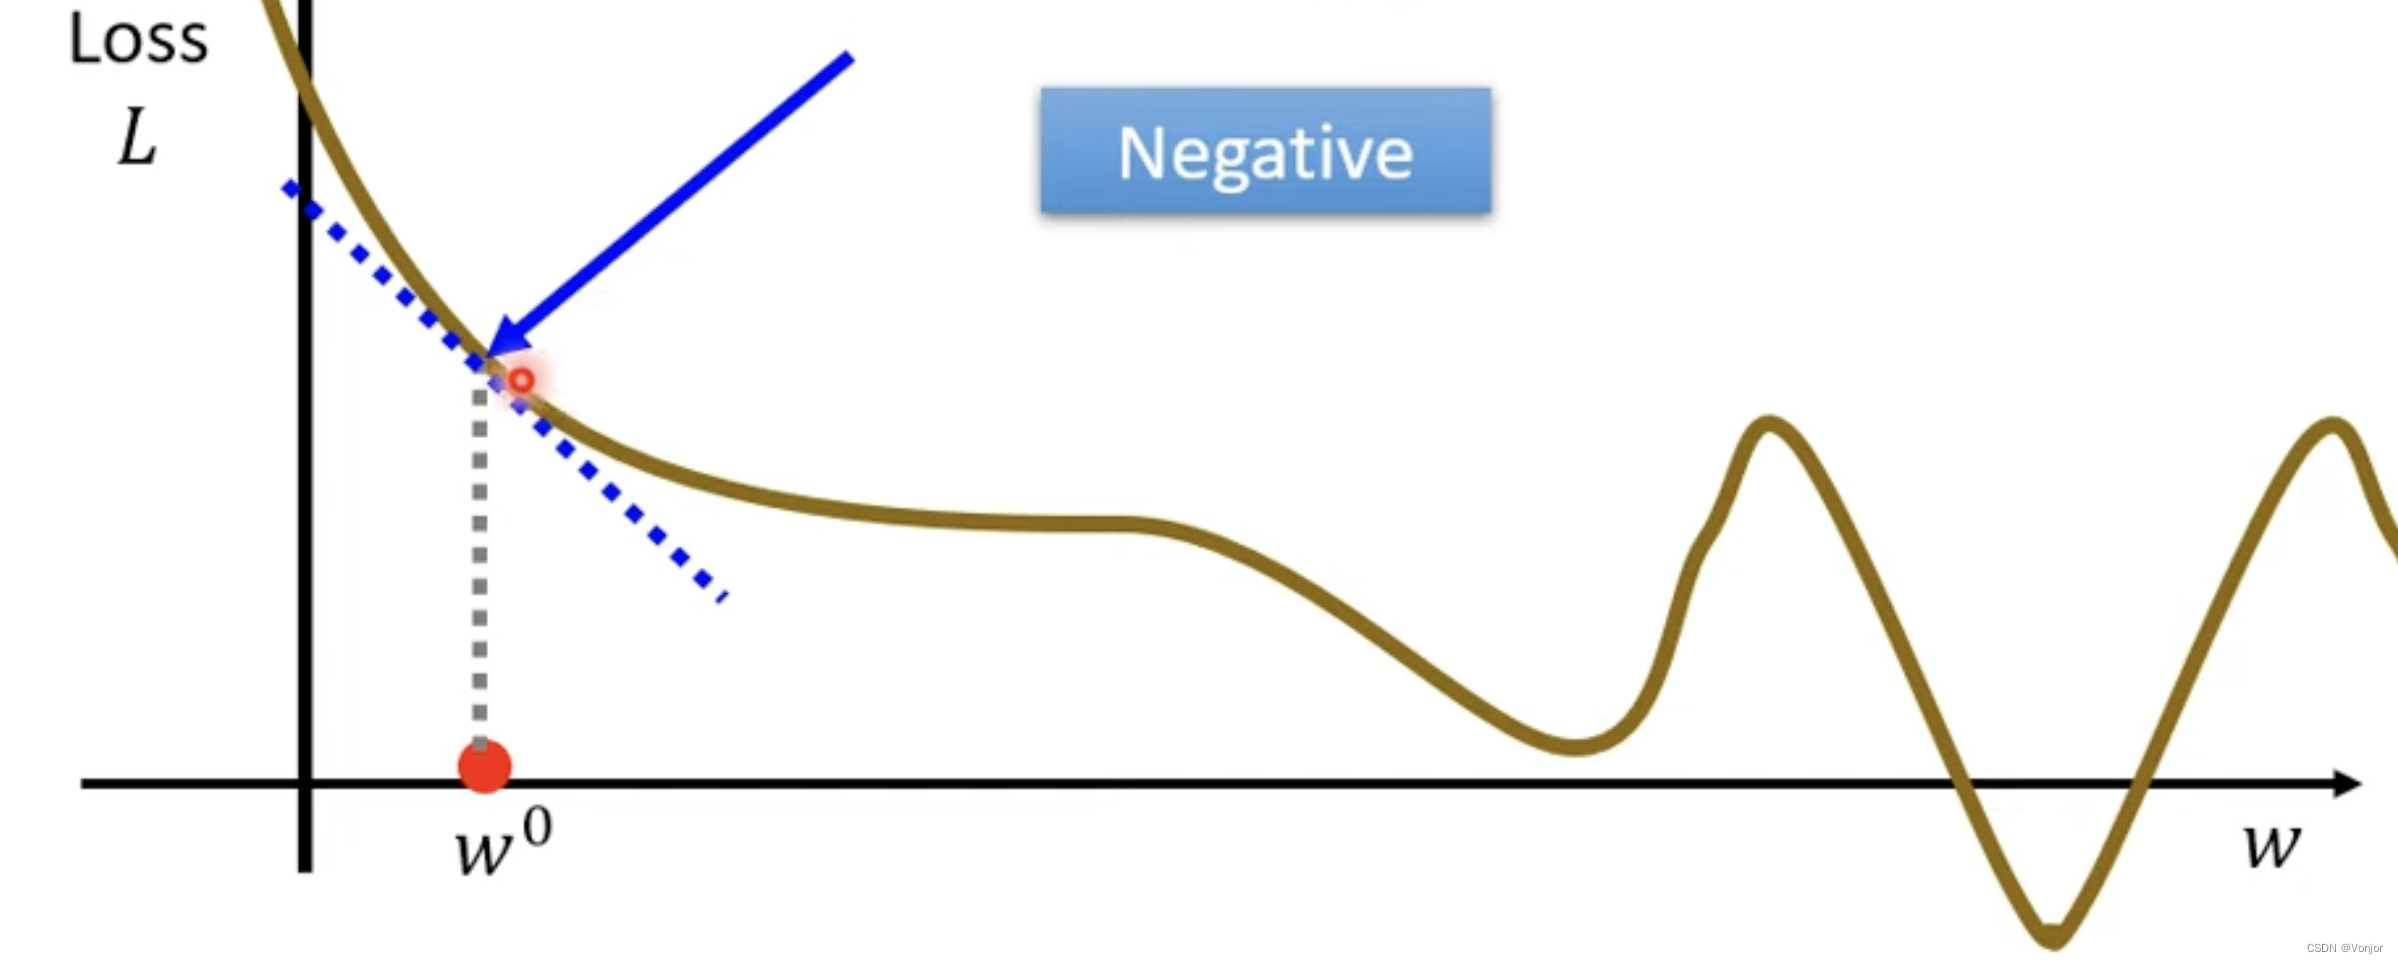
在w0w^0w0点的切线斜率也就是error surface在该点的切线斜率。若斜率为负数,则说明Loss值在有限范围内,随着w的增大而减小,因此增大w;
若斜率为正值,则说明Loss值在有限范围内,随着w的增大而增大,因此减小w;
因此w的迭代算式为:
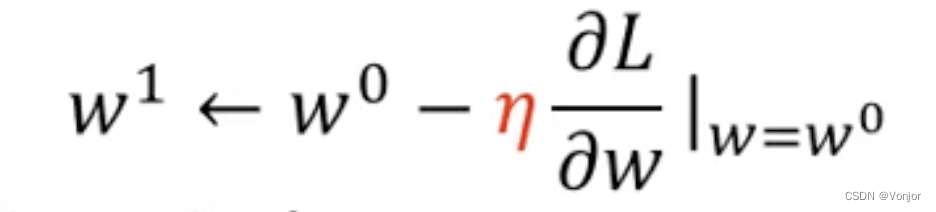
此处η\etaη为学习率,是自定的Hyperparameters(超参数),
即迭代值=原值-学习率*原值处的偏导数,然后不断迭代。
在error surface上的演示如下:
6、模型的改进
任何连续的曲线可以由多段直线来近似拟合,如下图所示:
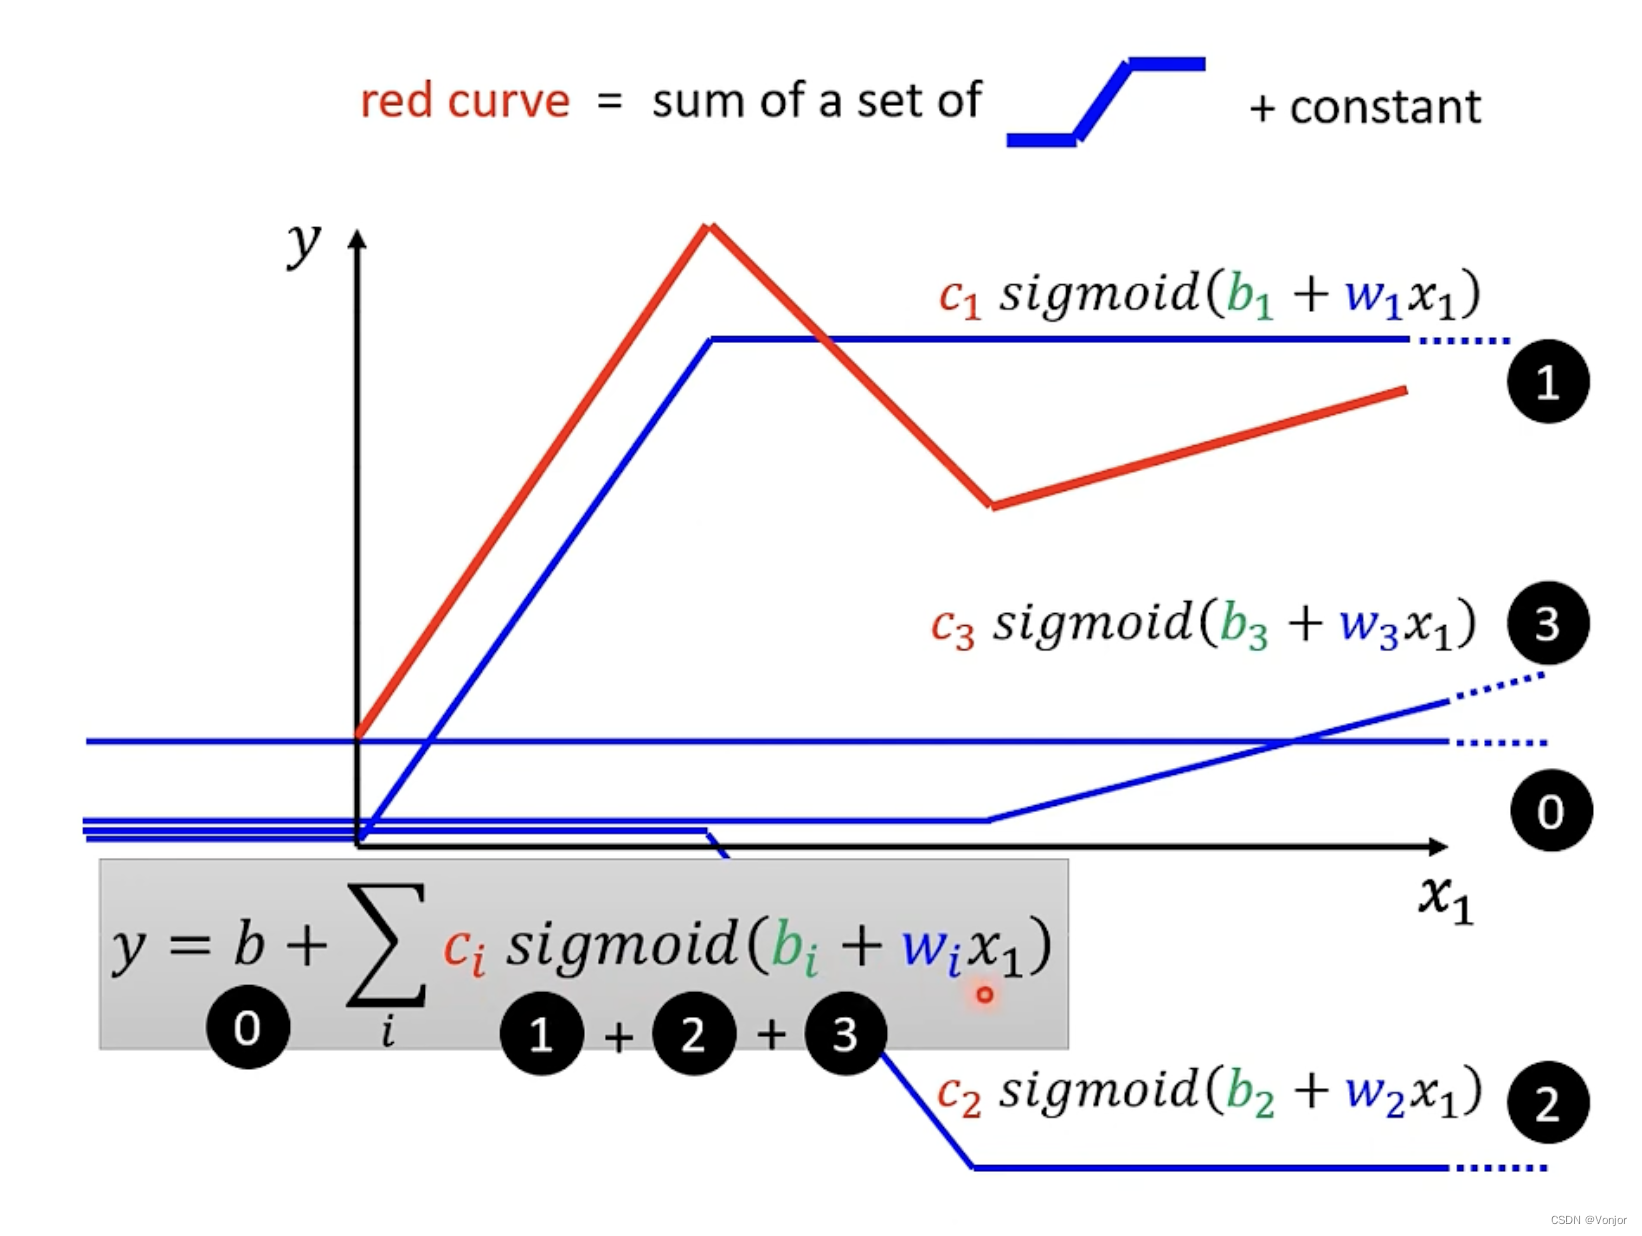
红色折线可由蓝色折现的4个变种相加得到,而蓝色折现可由一条曲线来表示,即sigmoid函数,如下图所示:
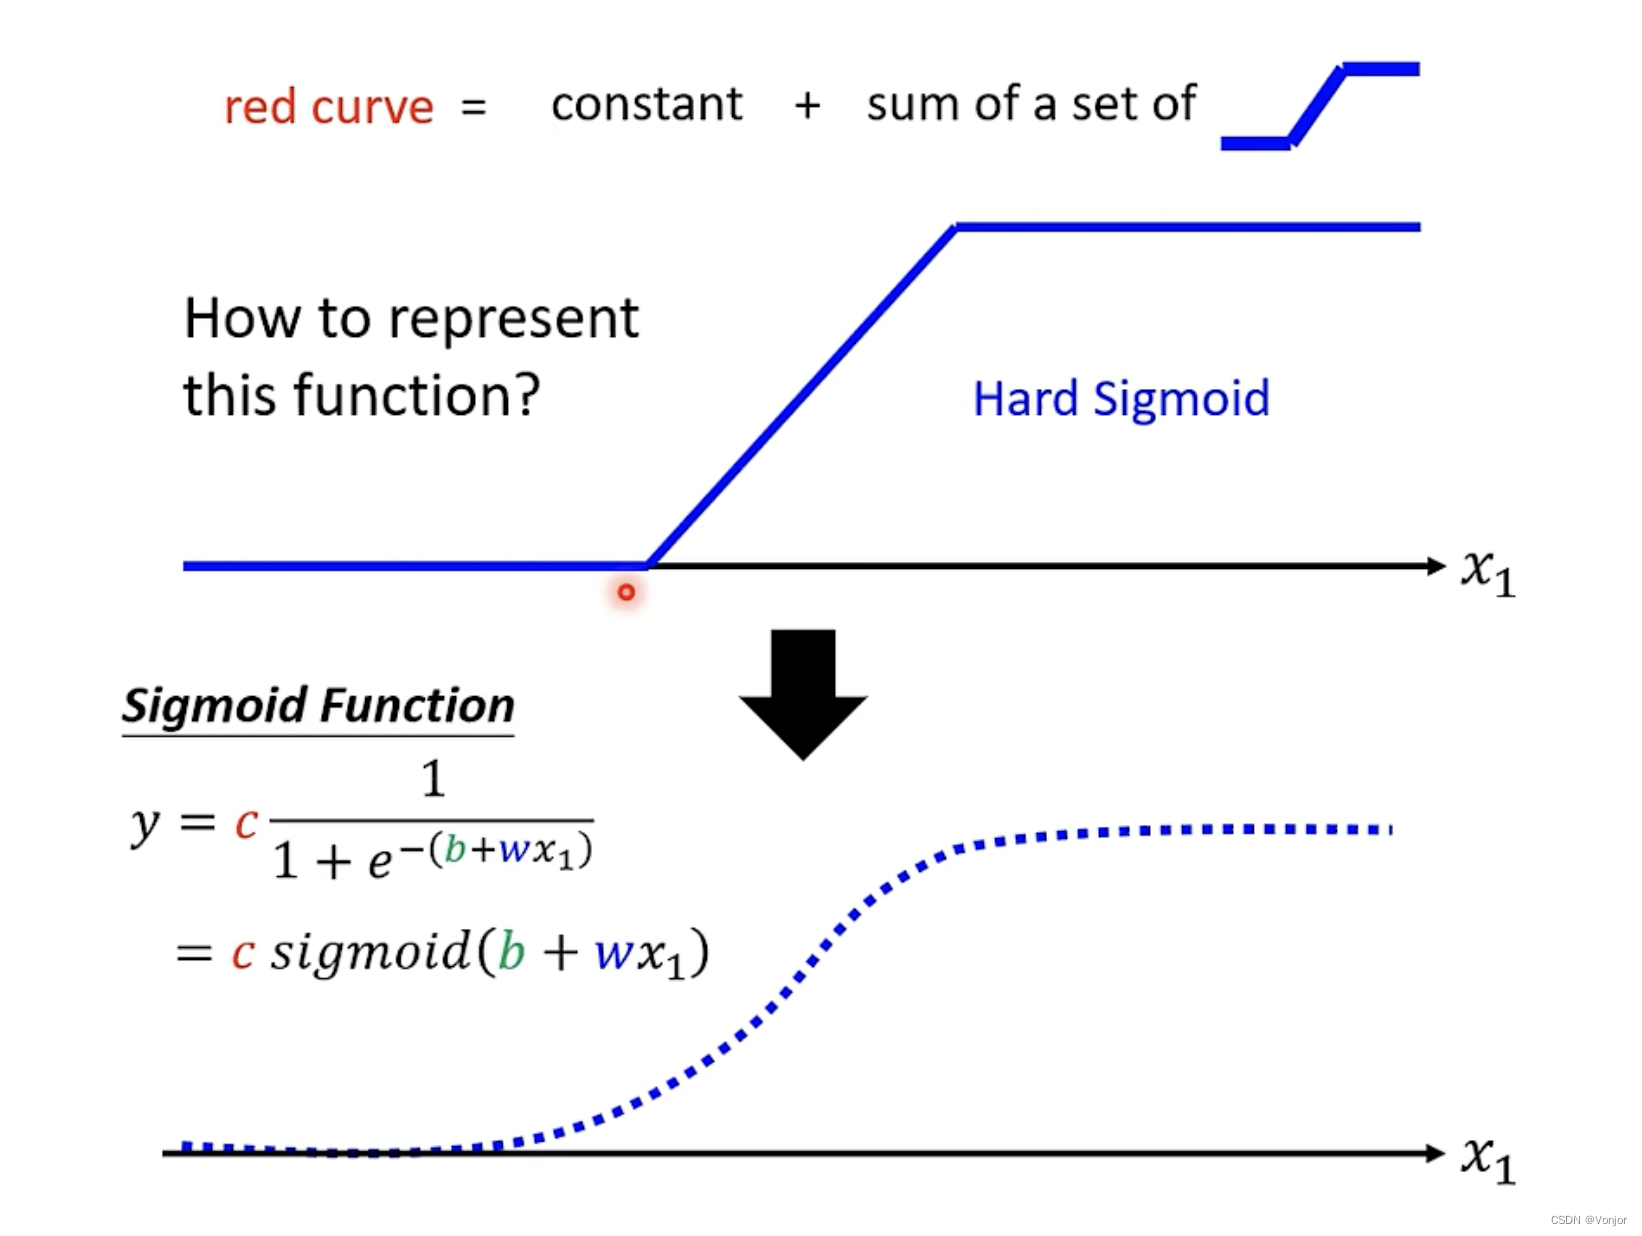
为了能使sigmoid函数能拟合各种曲线段,只需修改c、b、w三个参数即可:
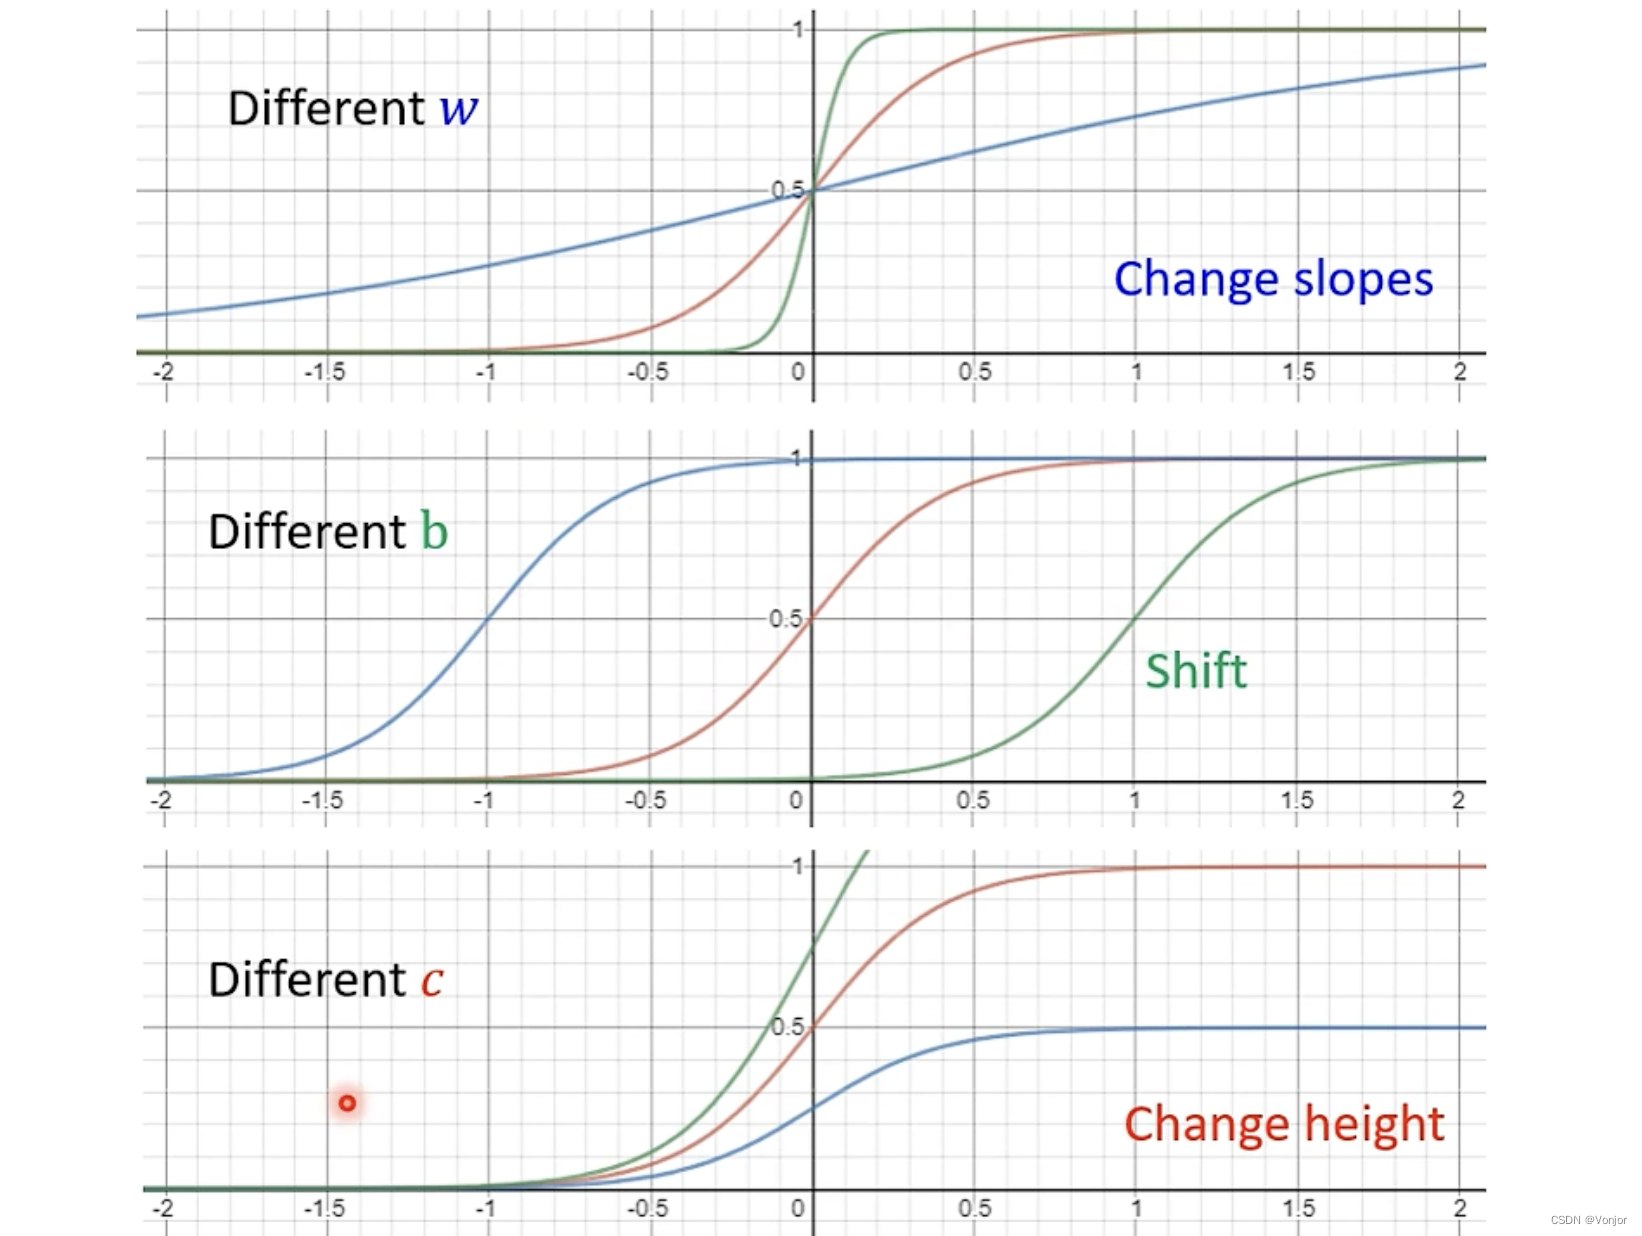
因此使用sigmoi来构建模型可以使模型拥有更多参数,相较简单的线性模型,拥有更好的泛化性。
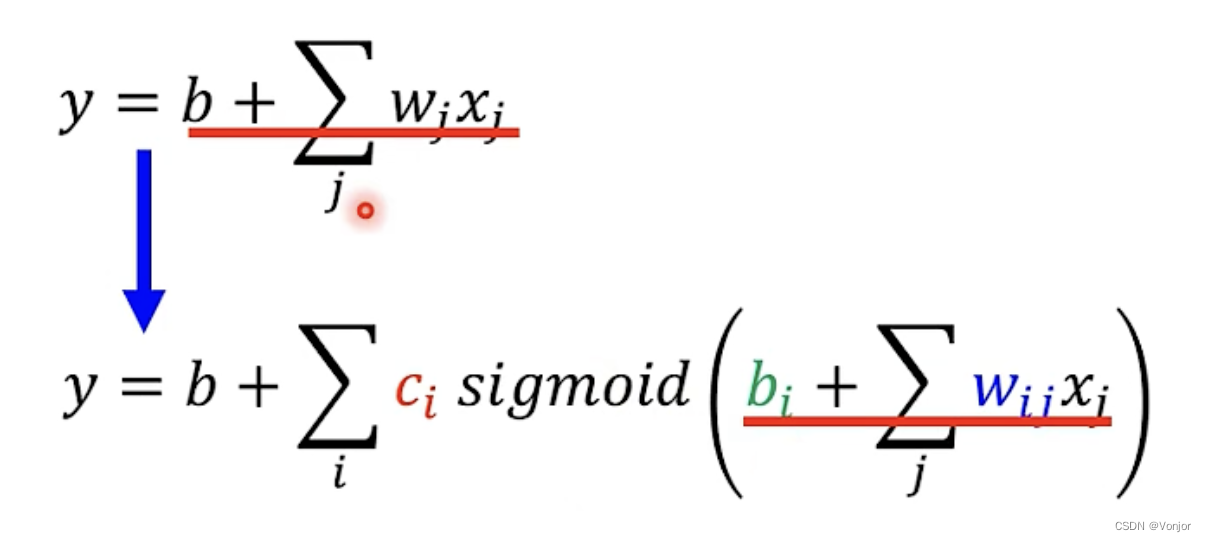
那么这个方程的意义是什么呢,见下图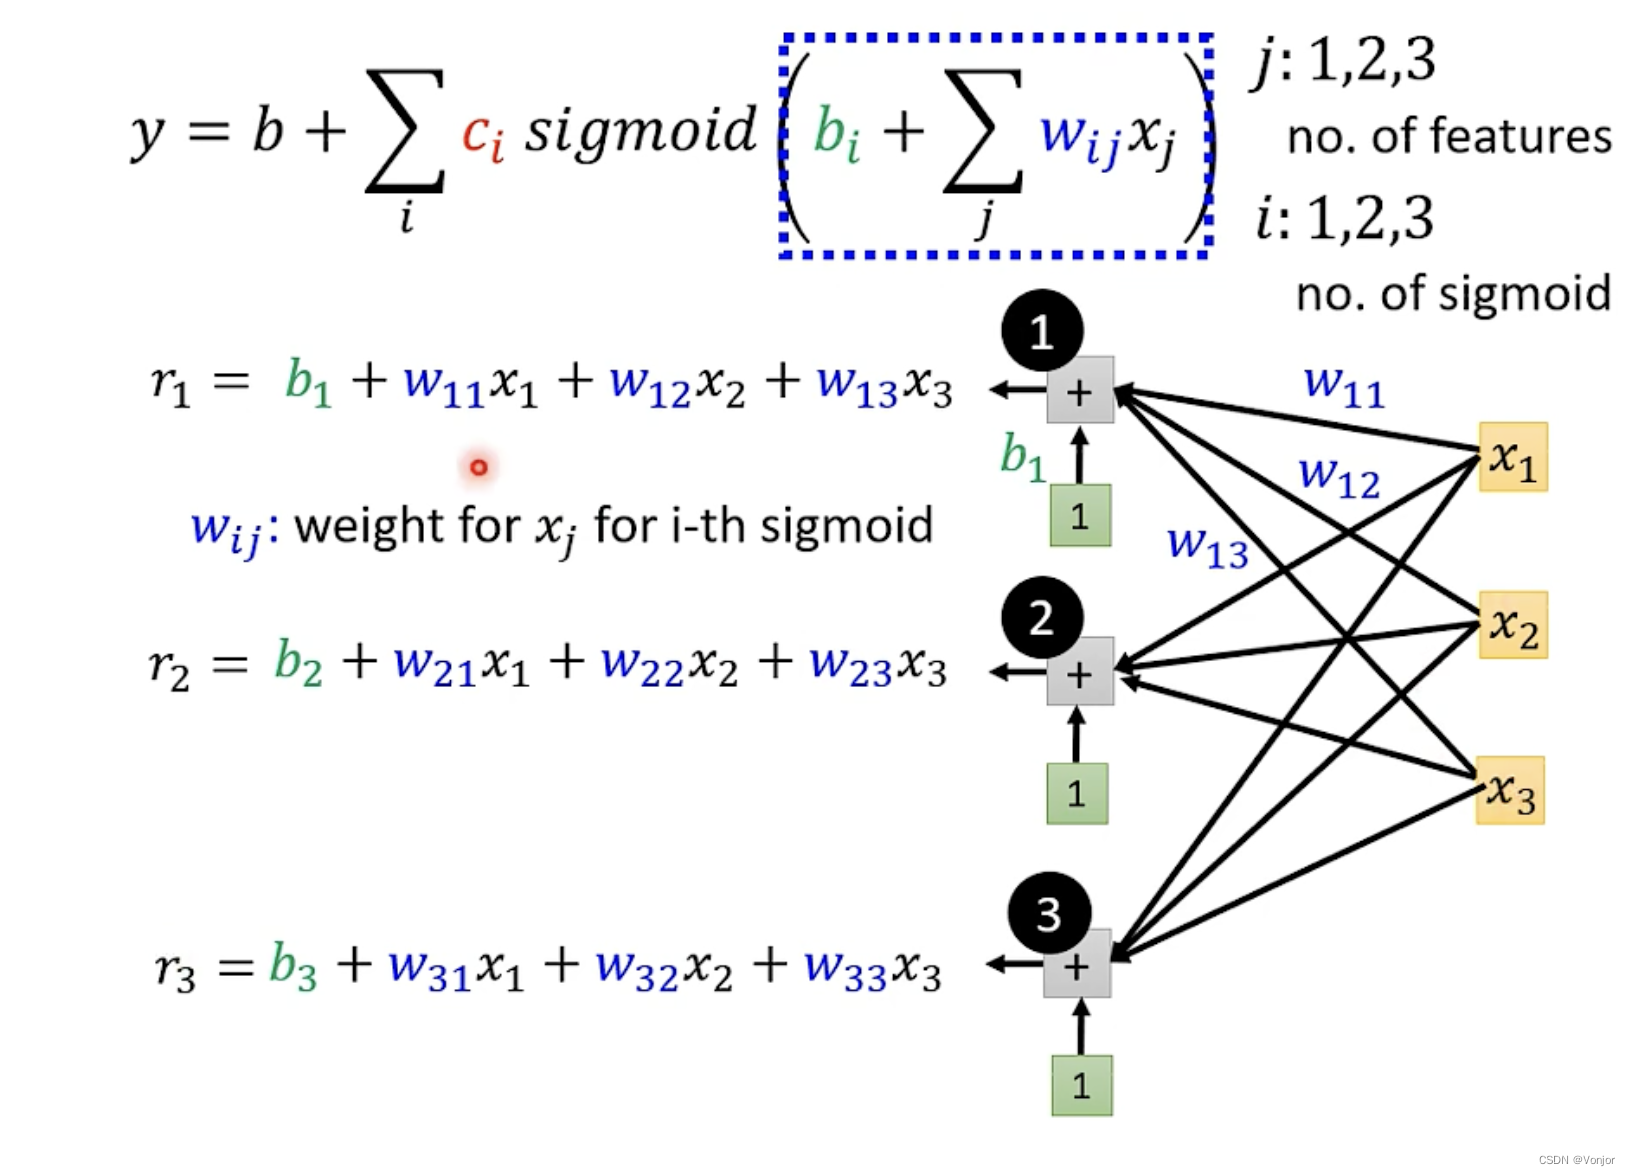
输入是x1、x2、x3,有三条sigmoid函数,rir_iri表示的是每一条sigmoid函数的输入:
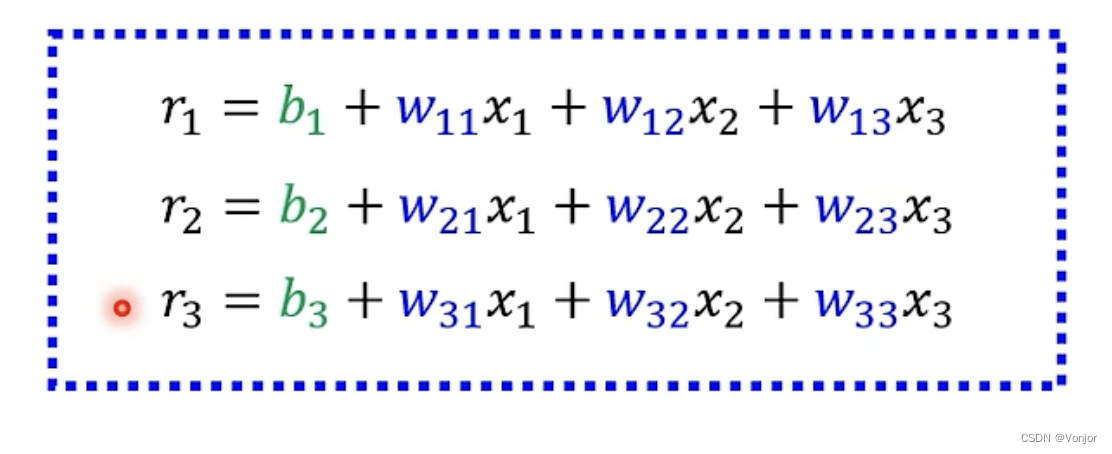
学过线性代数就会知道,wijxjw_{ij}x_jwijxj可以写成矩阵与向量的相乘:
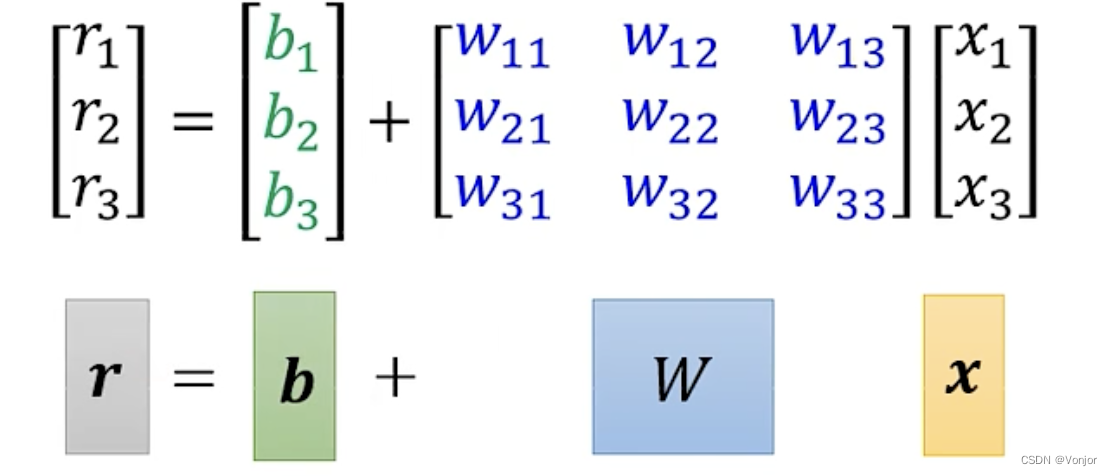
在求出rir_iri后,就可以求三个sigmoid的值:
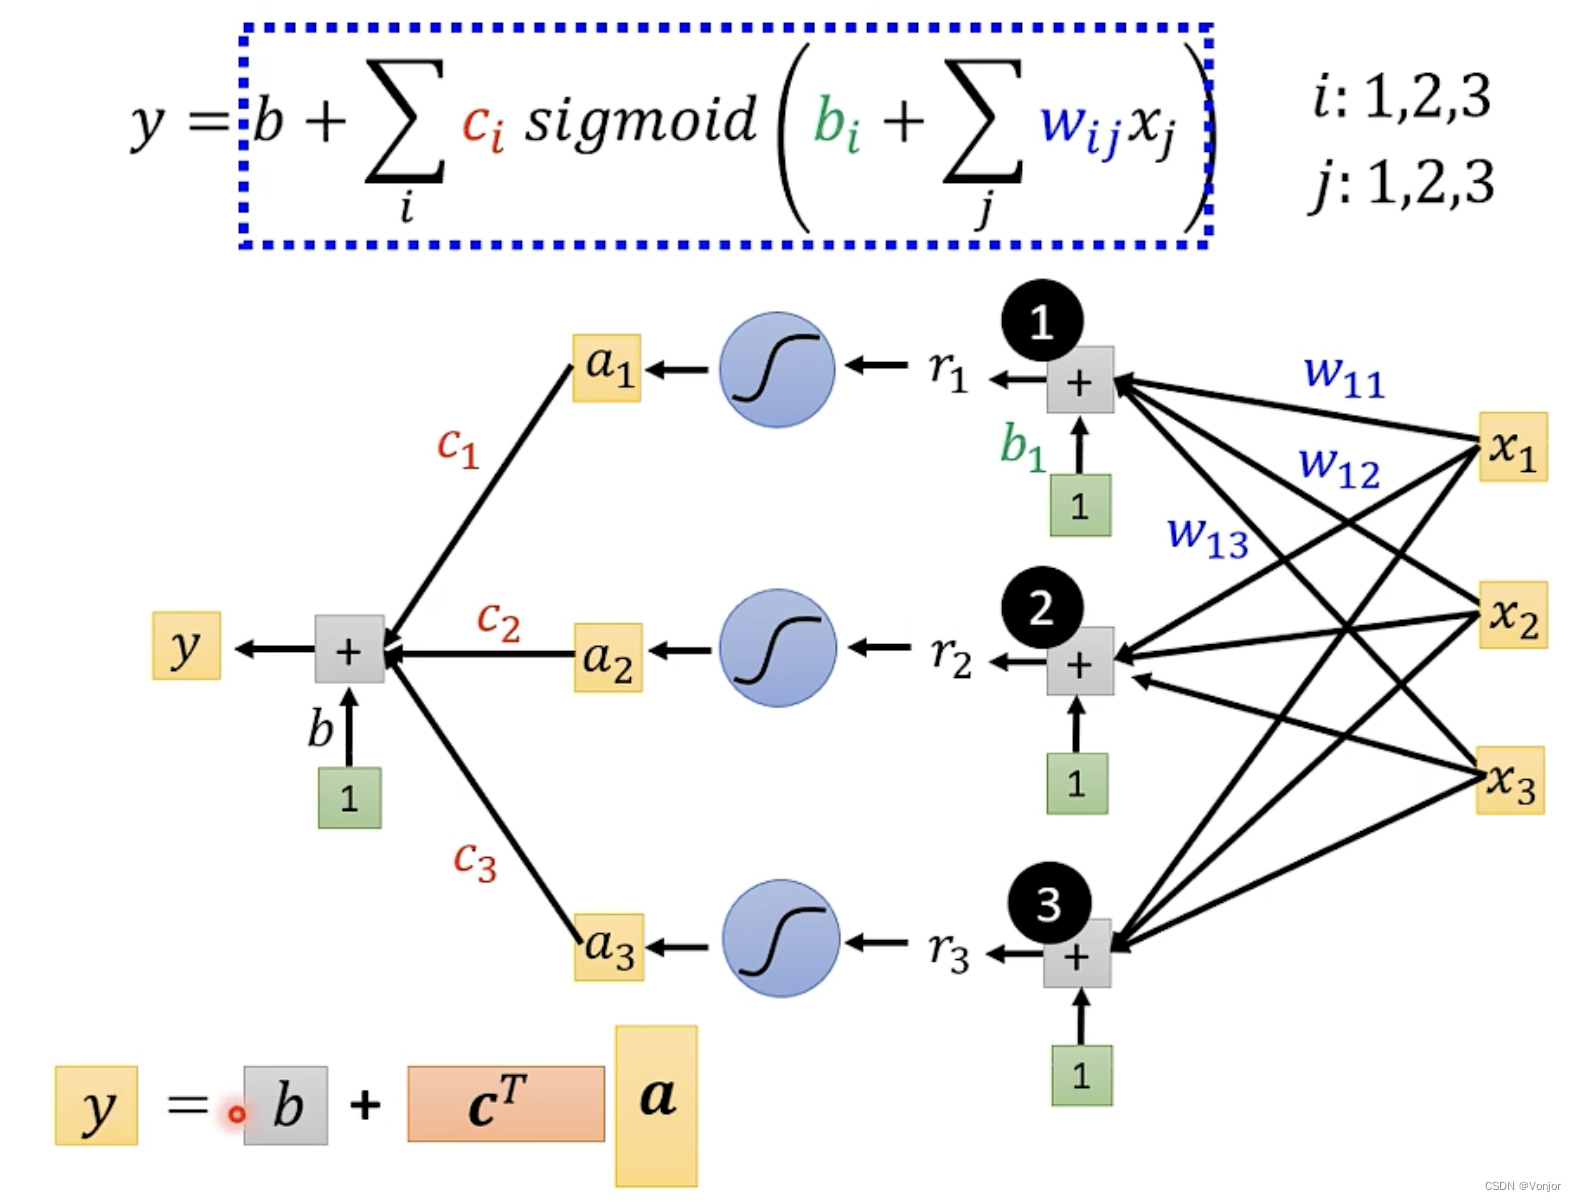
整个过程的方程可以写为:
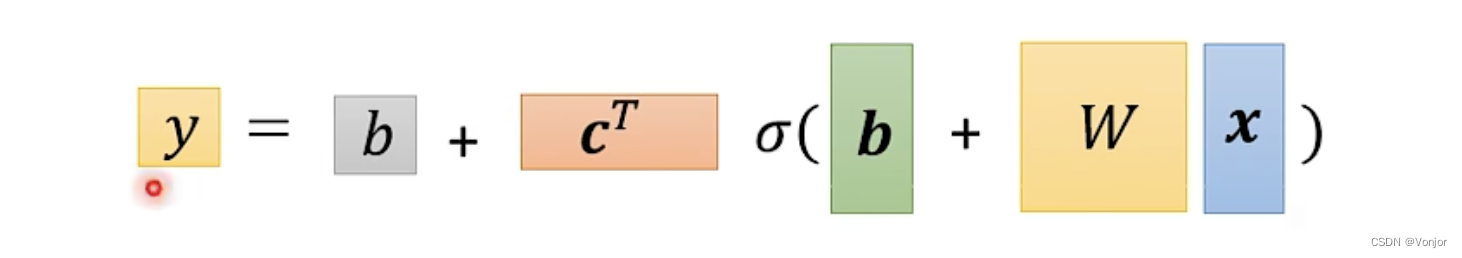
在这个函数中,4个参数可以统称为θ\thetaθ:
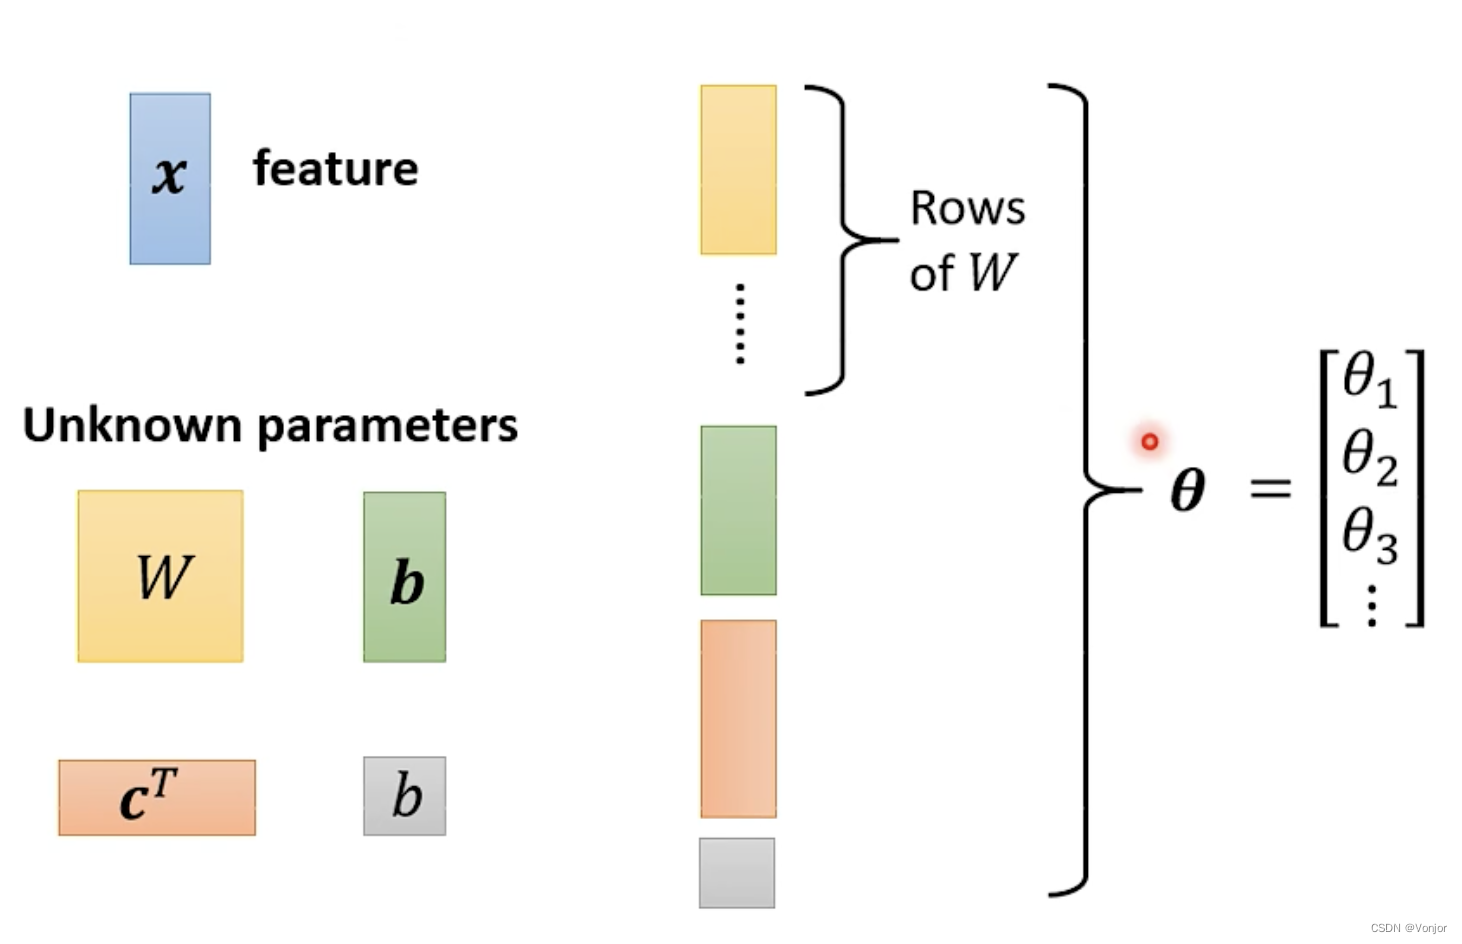
对于此模型函数,损失函数改写为L(θ)L(\theta)L(θ),迭代过程与前文相同,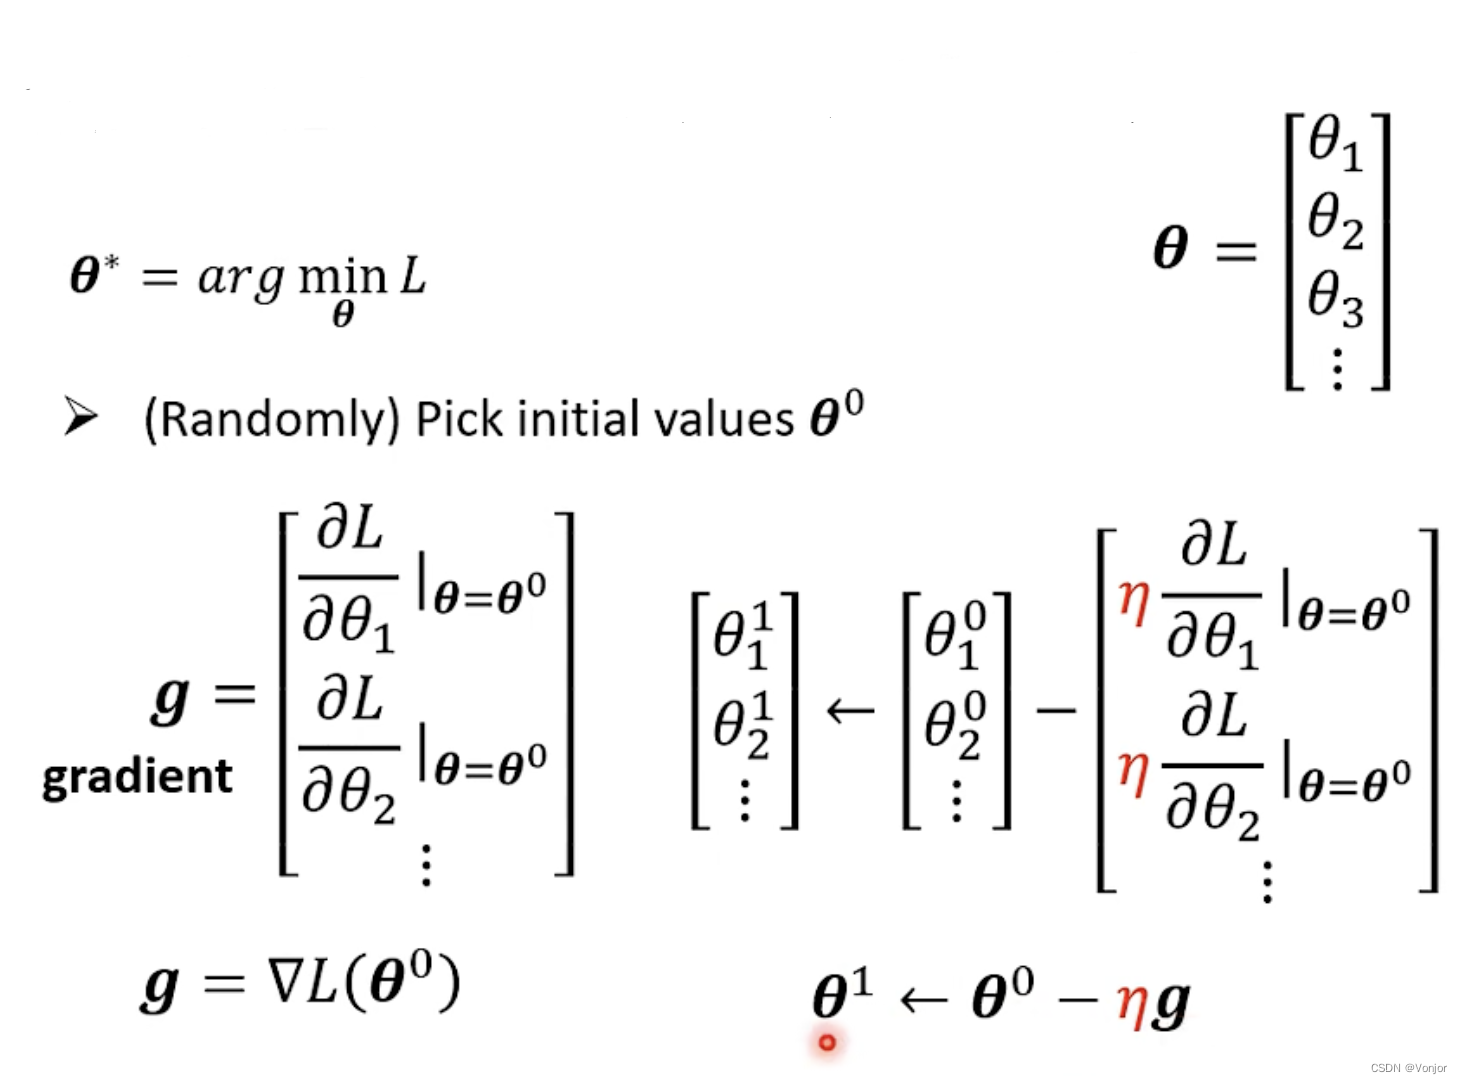
Batch Size:将训练数据均匀分为N批,先将第一个Batch的数据用于训练,且一个Batch迭代一次参数(一次update),再到下一个Batch,直到所有N批Batch训练完一次,叫做一个epoch。
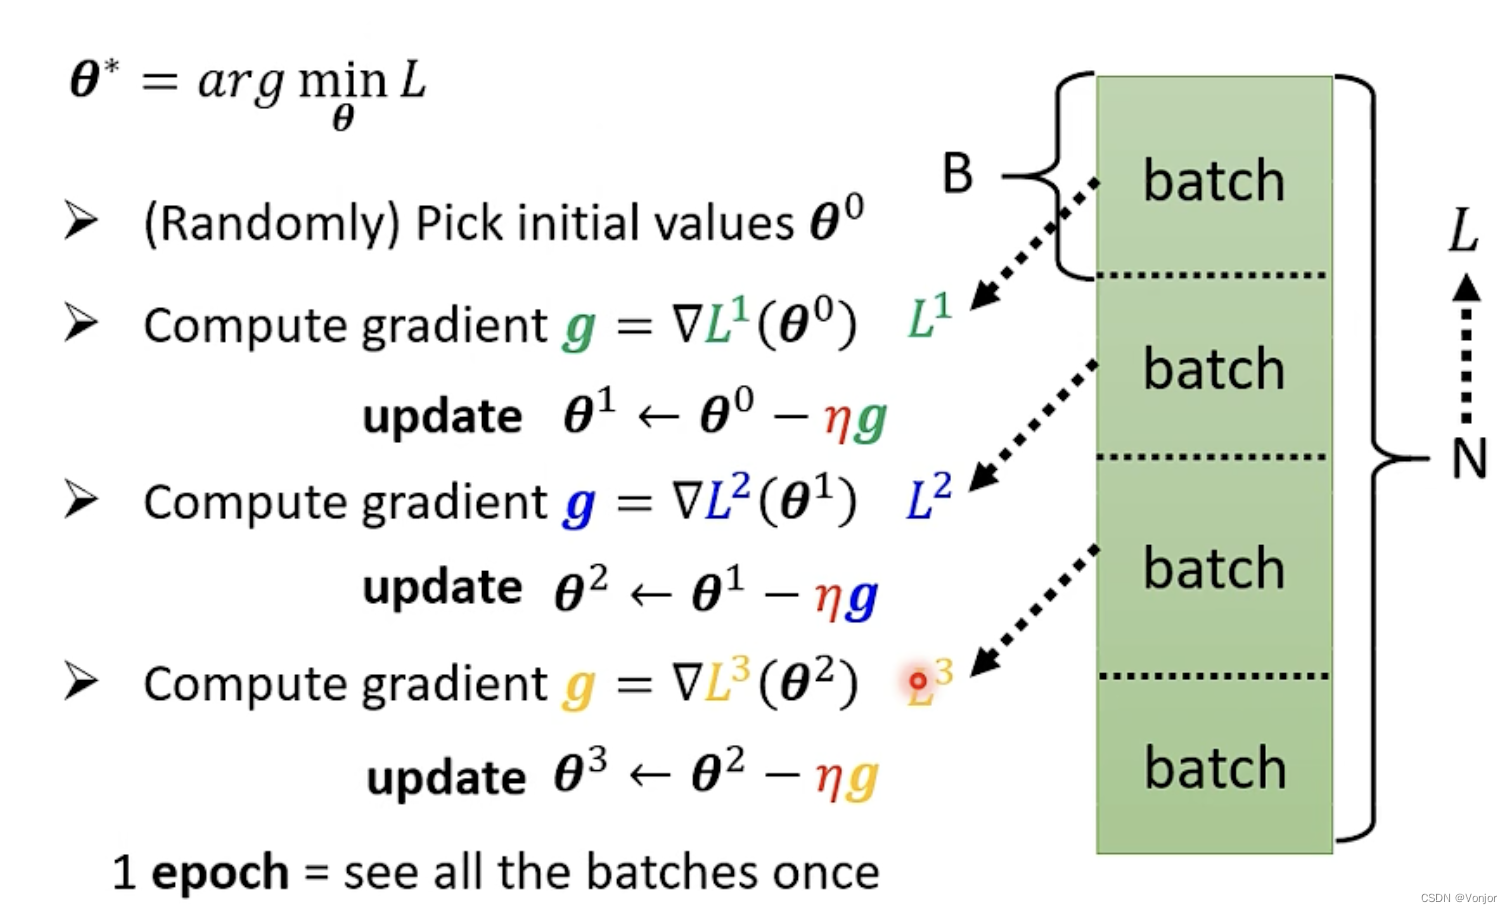
例如,数据有10000条,BatchSize=10,在一个epoch中,θ\thetaθ更新了1000次。
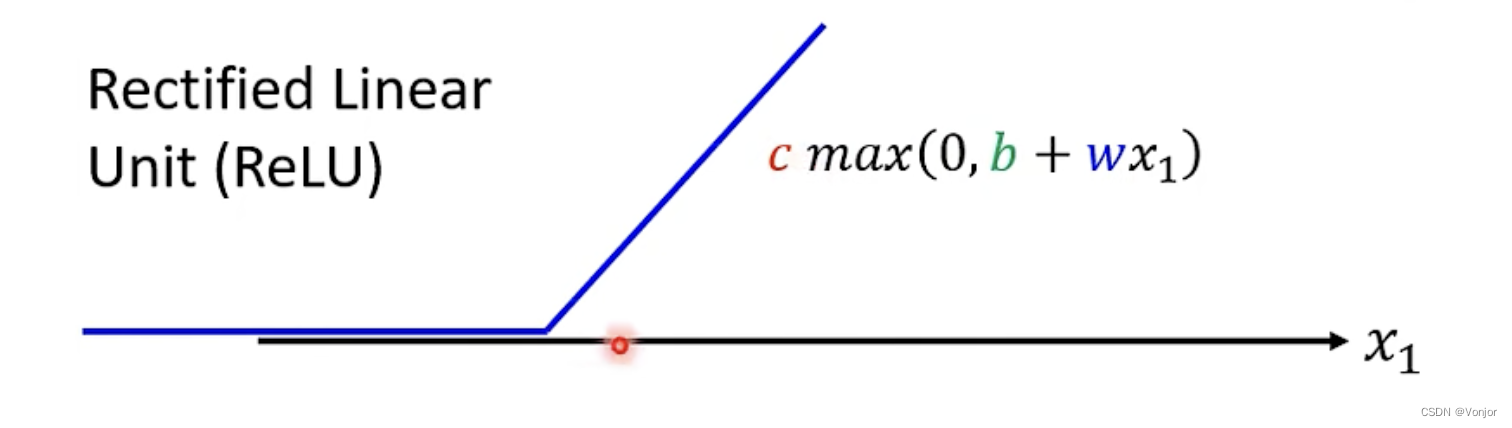
sigmoid函数也可以换为Relu函数
在经过一轮sigmoid或者Relu函数计算后,若是效果还是不理想,可以选择增加一轮继续计算来得到结果
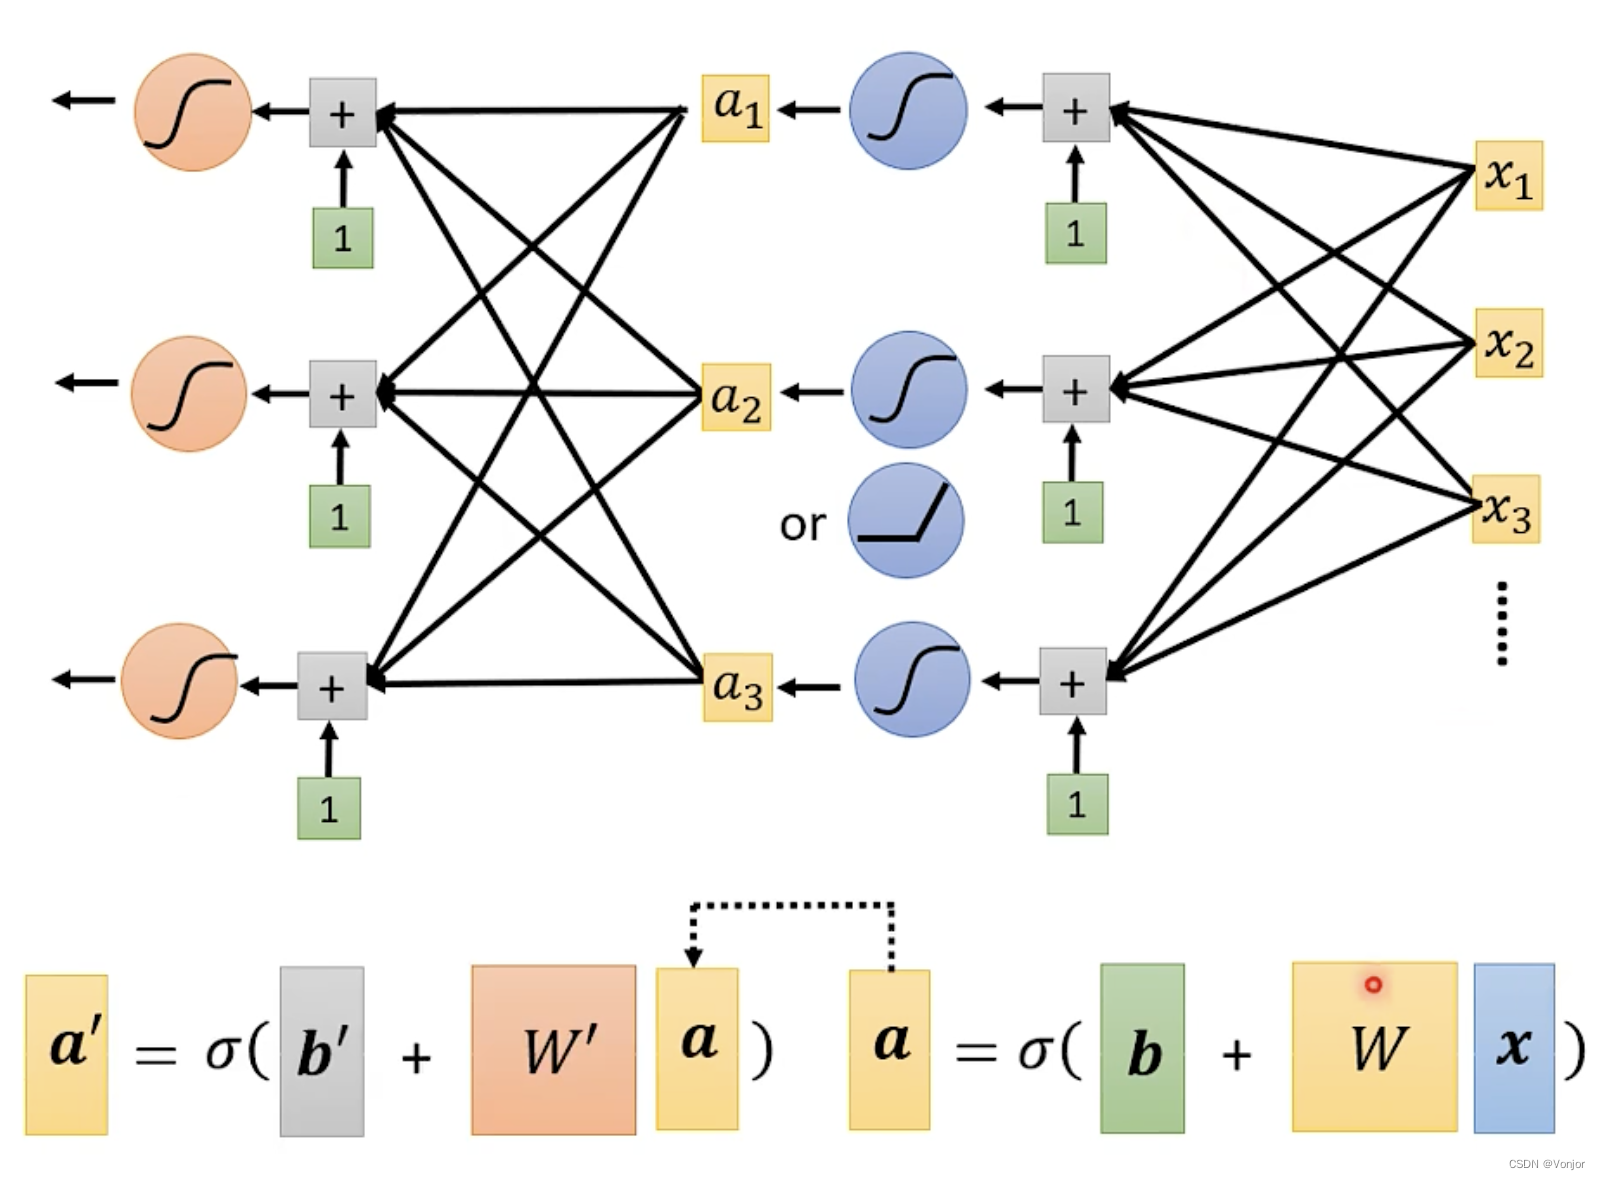
在继续不断的增加一轮一轮的sigmoid或Relu等函数后,这种模型结构就被叫做Neural Network(神经网络),每一轮的计算就叫做一层Layer。

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)