Hive数据仓库(一) 介绍
·
文章目录
一.项目背景:电商
离线数仓演进过程当中遇到的问题&解决方案/思路
数据库&数据仓库 范式建模  维度建模
维度表设计
事实表设计
kylin
mysql  hive kylin 展示
二.离线数仓演进过程
1.第一个阶段
统计需求  mysql
业务系统:CRM系统、ERP系统、交易系统、商品系统、供应商系统....
随着发展 数据去决策
交易系统  order库
商品系统  item库
mysql  --> hive --> excel给到业务方
问题:1.烟囱式开发/重复开发 取数
需求:建立数仓  --> 数仓架构设计/表名规范/分层的设计 搭建各个主题域的中间层
2.第二个阶段
问题:
1.数据量上来之后 数据抽取的操作十分耗费时间 ===> 如何去选择最优的一个数据抽取/存储策略
2.ETL任务 脚本跑在服务器上面
每天凌晨 定时在服务器 pull   push
如果修改代码  忘记提交了  ==> 凌晨任务跑不来
平台化 ETL开发平台  发布ETL任务
3.调度问题 crontab 遇到上下游任务有依赖 a任务依赖b b任务依赖c
c  1
b  2 ==》 4
a  3
依赖调度 azkaban airflow
3.第三个阶段
问题:
1.随着业务发展  业务系统需要进行一定程度的改造
父子订单  购物车  a b c三个商品==>order_id   子订单
	      购物车  trade_id  父订单
	      退款只是支持到trade维度
数仓当中有一张order表 下游
批次 有批次  一品多商
     无批次  一品一商
数据血缘

2.业务方质疑你的数据不准 数据口径不统一  我真的取错数据了(sql写错了)
gmv 下单金额+优惠券金额
     下单金额
指标中心
数据抽取挂了 分表64张  60张 ==> 数据质量中心(DQC) 监控每天数据条数变化  对应指标
3.任务跑的慢 sql写的不规范
hive分区表
a 365分区
b 365分区
     需求:多维分析  ==> kylin+BI系统
     数据血缘 + 指标中心 + 数仓表(数据字典) ==> 元数据中心
     BI多了起来 取数 desc xx hue
4.第四个阶段
 问题:集群稳定性 cdh
       采集各个系统(数据团队)的关键数据 ==> 图表 离线任务运行时长

 枚举 trade_type 10 11 12...
      0:xxx  1:yyy 2:zzz ....
      case when
      枚举中心  预警、界面 k-v ==> 码表
三.如何去做数仓架构设计
0.整体架构图

1.数据抽取 sqoop/datax
2.数仓分层
参考链接:
离线数仓分层结构图
https://app.liuchengtu.com/#Rb734cafbf09d4651caadd74e5a3d304d

数据仓库--通用的数据仓库分层方法
https://www.cnblogs.com/itboys/p/10592871.html

 		ODS operational data store
 			最接近数据源当中的一层 尽量保持和源端的数据格式一样
 		DW
 			DWD  该层保持和ODS层一样的数据粒度  数据清洗(过滤、日期格式转换 时间戳-->yyyy-MM-dd等)的操作
 	        DWM  数据中间层 提升数仓公共指标的复用性 减少重复加工
 	             交易域 商品域 CRM域 门店域 流量域...
 	             下单商品  下单金额 下单时间  支付状态 ...
 	        DWS  生成字段比较多的宽表 提供给后续的业务查询
 	             select xxx from tbl where dayid='xxx' group by xx
 	    APP 数据应用层
 	       	report(报表)  严禁读取ods dwd层 中间层建设不完善
 	        kylin数据
 	        数据加工st_xxx
 	    DIM维表
 	    	数仓通用的维表  时间/地区/类目/商品....
3.数据回流
sync_xxxx脚本 mysql提供给业务系统
4.数仓表名、字段名 命名规范
 		数仓里的表在天上飞
 		数仓表名和ETL任务名 保持一致 hive -v -e "insert xxxx select xxxx"
 		ods_t_item_d  ods_t_item_d.sh
 		st_itm_gmv_d  st_itm_gmv_d.sh
 		sync_st_itm_gmv_d.sh select xxx   sqoop命令

 		_d天更新
 		_m月更新
 		_h按小时更新

 		_i增量表 数据是增量
 		_s拉链表
 		ODS层    层级_业务库_mysql表名_d
 		         ods_trade_pay_xxx_d/i
 		中间层   层级_主题域_业务过程_[/d/h/m...]
 		         dws层 _1d 统计日当天的汇总数据
 		               _nd 统计近n天的汇总数据
 		               _mtd 统计当月累计到统计日的汇总数据
 		               _td  统计的就是历史全量数据
 		               _dth
 		维表     dim_维度名称_d 每日全量表
 		         dim_维度名称   全量表
 		         dim_维度名称_ds 拉链表 极限存储表
5.技术选型
 		数据抽取  sqoop/datax
 		数仓      Hive    impala Greenplum
 		传统数仓  oracle
 		数据回流  sqoop/datax
四.数据库&数据仓库的区别
1.范式
第零范式  无重复数据
第一范式  满足属性不可分
第二范式  在第一范式的基础上更进一步,确保数据库的表当中每一个字段都只和主键相关
第三范式  (不存在传递依赖,确保每列都和主键列直接相关,而不是间接相关)确保数据表中的每一列数据都和主键直接相关,而不能间接相关,在第二范式的基础上 属性只直接依赖主键
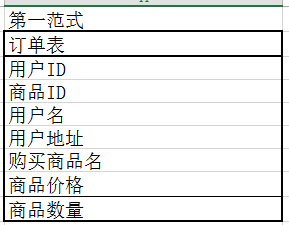
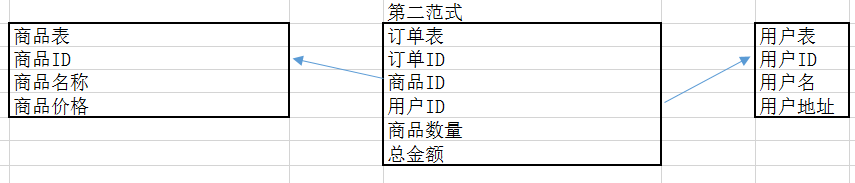
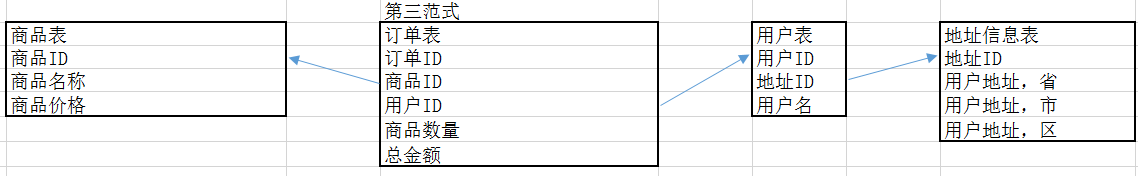
2.数据仓库和范式之间存在着一种什么样的关系
(1)维度建模中的星型模型  在范式理论上是符合第二范式

(2)雪花模型  星型模型和雪花模型最大区别在于  维度表是否和事实表直接相连

(3)有冗余的事实表
	将一些维度信息,比如说用户信息、商品信息 冗余到订单事实表中
	在范式理论上是符合第一范式

(4)数据库和数据仓库各自的侧重点
   a.对于绝大多数的数据仓库设计来说,一般情况下都不会去考虑是否满足第几范式
   b.数据库 设计 联机事务处理  OLTP(on-line transaction processing) 各种的增删改查操作
   c.数据仓库    联机分析处理  OLAP  面向日常数据分析  数据插入和查询,基本上不会去涉及数据的删除和修改操作

   d.数据库面向事务的设计  数仓面向主题的设计
        业务系统              分系系统
        order_id              历史数据
        尽量避免冗余          刻意的去引入冗余操作
—本项目笔记版权归若泽数据所有,其他机构切勿抄袭!—

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)