【机器学习】logistic回归
一、logistic回归概述
logistic回归是一种二分类或多分类的概率型非线性回归模型,用于研究因变量与影响因素之间的关系。
其主要思想是根据现有数据对分类边界线建立回归公式,从而进行分类。与线性回归不同的是,logistics回归的目标是找到最佳拟合参数,以便对不同特征赋予不同的权重。
二、预备知识
尽管Logistic回归的名字中含有“回归”二字,但其目的和线性回归有本质的不同。
| 特性 | 线性回归 | 逻辑回归 |
|---|---|---|
| 任务类型 | 回归(预测连续值) | 分类(预测离散类别) |
| 输出范围 | 无界实数(−∞,+∞) | 概率值([0,1][0,1]) |
| 本质 | 拟合最佳线性关系 | 估计类别概率并划分决策边界 |
其最根本的区别就是线性回归输出的是具体的预测值,而逻辑回归输出的是概率值(属于哪个分别的概率) 。
2.1线性模型与回归
线性模型的一般形式为:
向量化表示为:
其中x为d维属性描述样本为:
目的:
学习一个线性模型以尽可能准确预测实值输出
即
2.2最小二乘法与参数求解
线性回归目标:回归预测值与真实值的误差最小。公式表示为:

分别对w和b求偏导得到

易得

2.3Sigmoid函数
Sigmoid函数是一种阶跃函数。在数学中,如果实数域上的某个函数可以用半开区间上的指示函数的有限次线性组合来表示,那么这个函数就是阶跃函数。而数学中指示函数是定义在某集合X上的函数,表示其中有哪些元素属于某一子集A。
为了实现Logistic回归分类器,我们在每个特征上都乘以一个回归系数,然后把所有的结果值相加,将这个总和代人Sigmoid函数中,进而得到一个范围在0~1之间的数值。任何大于0.5的数据被分入1类,小于0.5即被归入0类。所以,Logistic回归也可以被看成是一种概率估计。
函数如下:

-
判断标准
- 回归的结果输入到sigmoid函数当中
- 输出结果:[0, 1]区间中的一个概率值,默认为0.5为阈值

逻辑回归最终的分类是通过属于某个类别的概率值来判断是否属于某个类别,并且这个类别默认标记为1(正例),另外的一个类别会标记为0(反例)。(方便损失计算)
2.4梯度上升法
要找到某函数的最大值,最好的方法是沿着该函数的梯度方向探寻。
梯度上升算法到达每个点后都会重新估计移动方向。从P0开始,计算完该点的梯度,函数就根据梯度移动到P2。如此循环直到满足停止条件。

三、实例
3.1数据预处理
数据集如下所示:
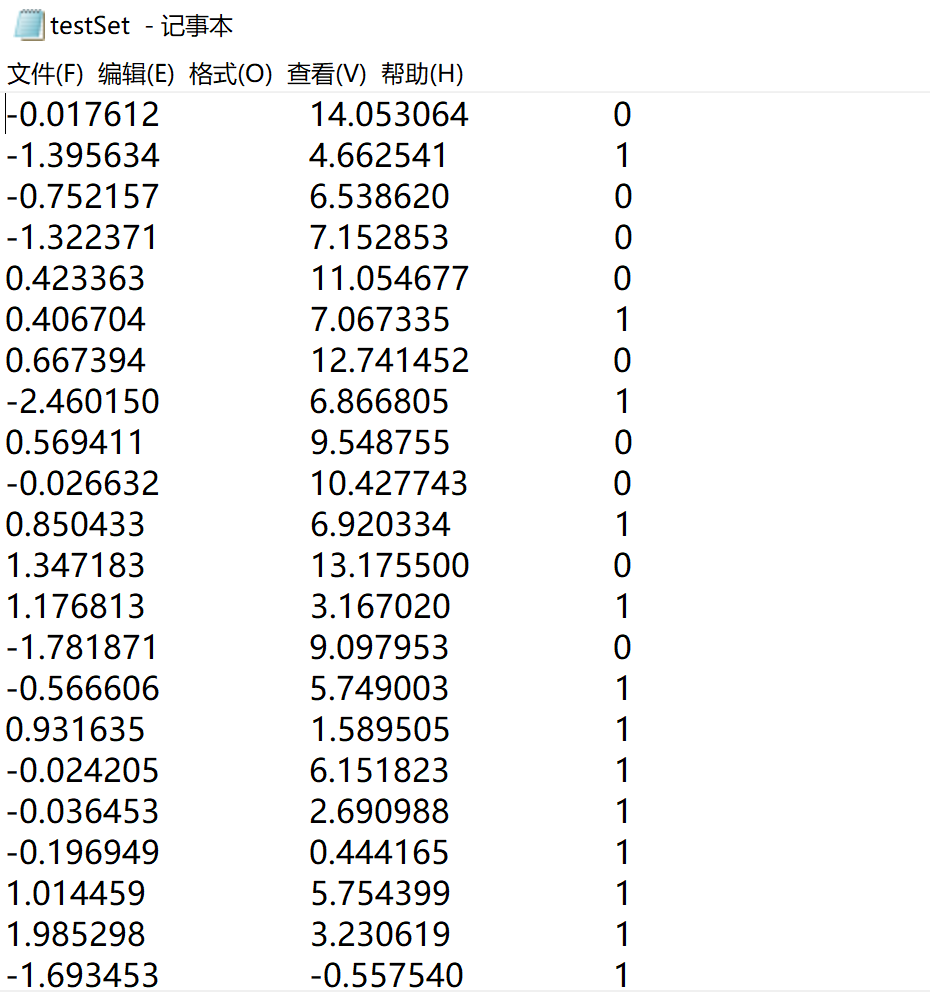
这个数据有两维特征,因此可以将数据在一个二维平面上展示出来。我们可以将第一列数据(X1)看作x轴上的值,第二列数据(X2)看作y轴上的值。而最后一列数据即为分类标签。根据标签的不同,对这些点进行分类。
那么,先让我们编写代码,看下数据集的分布情况:
import matplotlib.pyplot as plt
import numpy as np

'''
函数说明:加载数据

Parameters:
    无
Returns:
    dataMat - 数据列表
    labelMat - 标签列表
Modify:
    2021-02-05
'''
def loadDataSet():
    dataMat = []             #创建数据列表
    labelMat = []            #创建标签列表
    fr = open('testSet.txt')   #打开文件
    for line in  fr.readlines():
        lineArr = line.strip().split()
        dataMat.append([1.0,float(lineArr[0]),float(lineArr[1])])
        labelMat.append(int(lineArr[-1]))
    fr.close()
    return dataMat,labelMat


'''
函数说明:绘制数据集

Parameters:
    无
Returns:
    无
Modify:
    2021-02-05
'''
def plotDataSet():
    dataMat,labelMat = loadDataSet()     #加载数据集
    dataArr = np.array(dataMat)         #将数据由列表转为数组类型
#     print(dataArr)
    n = np.shape(dataMat)[0]            #数据个数
    xcord1 = [];ycord1 = []          #正样本
    xcord2 = [];ycord2 = []          #负样本
    for i in range(n):
        if int(labelMat[i]) == 1:
            xcord1.append(dataArr[i,1]);ycord1.append(dataArr[i,2])
        else:
            xcord2.append(dataArr[i,1]);ycord2.append(dataArr[i,2])
    fig = plt.figure()
    ax = fig.add_subplot(111)
    ax.scatter(xcord1,ycord1,s = 20,c='red',marker='s',alpha=.5)
    ax.scatter(xcord2,ycord2,s = 20,c='green',marker='s',alpha=.5)
    plt.title('DataSet')
    plt.xlabel('x');plt.ylabel('y')
    plt.show()

if __name__ == '__main__':
    plotDataSet()
运行结果如下:

从上图可以看出数据的分布情况。假设Sigmoid函数的输入记为z,那么z=w0x0 + w1x1 + w2x2,即可将数据分割开。其中,x0为全是1的向量,x1为数据集的第一列数据,x2为数据集的第二列数据。另z=0,则0=w0 + w1x1 + w2x2。横坐标为x1,纵坐标为x2。这个方程未知的参数为w0,w1,w2,也就是我们需要求的回归系数(最优参数)。
3.2 梯度上升算法
根据矢量化的公式,编写代码如下:
import matplotlib.pyplot as plt
import numpy as np

'''
函数说明:加载数据

Parameters:
    无
Returns:
    dataMat - 数据列表
    labelMat - 标签列表
Modify:
    2021-02-05
'''
def loadDataSet():
    dataMat = []             #创建数据列表
    labelMat = []            #创建标签列表
    fr = open('testSet.txt')   #打开文件
    for line in  fr.readlines():
        lineArr = line.strip().split()
        dataMat.append([1.0,float(lineArr[0]),float(lineArr[1])])
        labelMat.append(int(lineArr[-1]))
    fr.close()
    return dataMat,labelMat

'''
函数说明:sigmoid函数

Parameters:
    inX - 数据
Returns:
    sigmoid函数
Modify:
    2021-02-05
'''
def sigmoid(inX):
    return 1.0/(1+np.exp(-inX))

'''
函数说明:梯度上升算法

Parameters:
    dataMatIn - 数据集
    classLabels - 数据标签
Returns:
    weights.getA() - 求得的权重数组(最优参数)
Modify:
    2021-02-05
'''
def gradAscent(dataMatIn,classLabels):
    dataMatrix = np.mat(dataMatIn)           #将数据转换成mat格式
    labelMat = np.mat(classLabels).transpose()  #将标签转换成mat,并进行转置
    m, n = np.shape(dataMatrix)           #返回dataMatrix的大小
    alpha = 0.001                   #步长
    maxCycles = 500              #最大迭代次数
    weights = np.ones((n,1))
    for k in range(maxCycles):
        h = sigmoid(np.dot(dataMatrix,weights))
        error = labelMat - h
        weights = weights + alpha * dataMatrix.transpose() * error
    print()
    return weights.getA()

'''
函数说明:绘制数据集

Parameters:
    weights - 权重参数数组
Returns:
    无
Modify:
    2021-02-05
'''
def plotBestFit(weights):
    dataMat,labelMat = loadDataSet()     #加载数据集
    dataArr = np.array(dataMat)         #将数据由列表转为数组类型
#     print(dataArr)
    n = np.shape(dataMat)[0]            #数据个数
    xcord1 = [];ycord1 = []          #正样本
    xcord2 = [];ycord2 = []          #负样本
    for i in range(n):
        if int(labelMat[i]) == 1:
            xcord1.append(dataArr[i,1]);ycord1.append(dataArr[i,2])
        else:
            xcord2.append(dataArr[i,1]);ycord2.append(dataArr[i,2])
    fig = plt.figure()
    ax = fig.add_subplot(111)
    ax.scatter(xcord1,ycord1,s = 20,c='red',marker='s',alpha=.5)
    ax.scatter(xcord2,ycord2,s = 20,c='green',marker='s',alpha=.5)
    x = np.arange(-3.0,3.0,0.1)
    y = (-weights[0] - weights[1] * x)/weights[2]
    ax.plot(x,y)
    plt.title('BestFit')
    plt.xlabel('x');plt.ylabel('y')
    plt.show()

if __name__ == '__main__':
    dataMat,labelMat = loadDataSet()
    weights = gradAscent(dataMat,labelMat)
    plotBestFit(weights)
运行结果如下:

这个分类结果相当不错,从上图可以看出,只分错了几个点而已。但是,尽管例子简单切数据集很小,但是这个方法却需要大量的计算(300次乘法)。因此下面将对改算法稍作改进,从而减少计算量,使其可以应用于大数据集上。
四、总结
4.1 优点
- 实现简单,容易理解和实现
- 计算代价不高,速度快,存储资源低
4.2 缺点
- 容易欠拟合
- 分类精度可能不高

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 19
 0
- 0


 已为社区贡献2条内容

所有评论(0)