python实现均值-方差模型
·
# 求解资产配置比例以期待在达到目标期望收益率时将风险最小化
# 投资者的资产配置问题最终可以转化为一个二次规划问题来表达
# 构建一个MeanVariance类,该类可以根据输入的收益率序列,求解上述的二次规划问题,计算出最优资产比例,并绘制最小方差前缘曲线。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy.linalg import solve
from scipy.optimize import minimize
from scipy import linalg


class MeanVariance:
    # 定义构造器,传入收益率数据
    def __init__(self, returns):
        self.returns = returns

    # 定义最小化方差的函数,即求解二次规划(不允许做空)
    def minVar(self, goalRet):
        covs = np.array(self.returns.cov())
        means = np.array(self.returns.mean())
        n = len(means)

        # 使用scipy.optimize.minimize来求解带约束的二次规划问题
        # 目标函数:最小化方差 w^T * Cov * w
        def objective(w):
            return np.dot(w.T, np.dot(covs, w))

        # 约束条件
        constraints = [
            # 期望收益率约束:w^T * means = goalRet
            {'type': 'eq', 'fun': lambda w: np.dot(w, means) - goalRet},
            # 权重和为1约束:sum(w) = 1
            {'type': 'eq', 'fun': lambda w: np.sum(w) - 1}
        ]

        # 边界条件:不允许做空,权重在0到1之间
        bounds = [(0, 1) for _ in range(n)]

        # 初始猜测(等权重)
        x0 = np.ones(n) / n

        # 求解优化问题
        result = minimize(objective, x0, method='SLSQP', bounds=bounds, constraints=constraints)

        if result.success:
            return np.array([list(self.returns.columns), result.x])
        else:
            raise ValueError("优化失败: " + result.message)


# 读取数据(注意使用制表符分隔)
data = pd.read_csv('industry2.csv', sep='\t', index_col=0)
print("原始数据形状:", data.shape)
print("\n前5行数据:")
print(data.head())

# 计算各资产的统计信息
print("\n各资产的平均收益率:")
mean_returns = data.mean()
print(mean_returns)

print("\n各资产的标准差:")
print(data.std())

# 创建MeanVariance实例
mv = MeanVariance(data)

# 设置目标收益率(取平均收益率的平均值)
target_return = mean_returns.mean()
print(f"\n目标收益率: {target_return:.6f}")

# 求解最优权重
result = mv.minVar(target_return)
print("\n二次规划输出结果:")
print(result)

# 解析和格式化结果
print("\n=== 最优资产配置权重 ===")
asset_names = result[0]
weights = result[1].astype(float)

for i, (asset, weight) in enumerate(zip(asset_names, weights)):
    print(f"{i + 1}. {asset}: {weight:.6f} ({weight * 100:.4f}%)")

# 验证权重和为1
print(f"\n权重总和: {weights.sum():.10f}")

# 计算实际收益率和风险
actual_return = np.dot(weights, mean_returns)
cov_matrix = data.cov()
portfolio_variance = np.dot(weights.T, np.dot(cov_matrix, weights))
portfolio_std = np.sqrt(portfolio_variance)

print(f"\n实际获得的收益率: {actual_return:.6f}")
print(f"投资组合标准差(风险): {portfolio_std:.6f}")

# 计算夏普比率(假设无风险收益率为0)
sharpe_ratio = actual_return / portfolio_std if portfolio_std > 0 else 0
print(f"夏普比率: {sharpe_ratio:.6f}")

# 显示各资产的详细统计信息
print("\n=== 各资产详细统计 ===")
stats_df = pd.DataFrame({
    '平均收益率': mean_returns,
    '标准差': data.std(),
    '最终权重': weights
})
print(stats_df)

# 创建时间段的标识(使用数据的时间范围)
start_date = data.index.min()
end_date = data.index.max()
time_period = f"{start_date}-{end_date}"

# 创建权重数据框,格式为:时间段作为行,资产作为列
weights_dict = {}
for asset, weight in zip(asset_names, weights):
    weights_dict[asset] = weight

# 创建DataFrame,时间段作为索引,资产权重作为值
weights_df = pd.DataFrame([weights_dict], index=[time_period])

print("\n=== 权重数据框 ===")
print(weights_df)

# 保存为CSV文件
output_filename = 'portfolio_weights_by_period.csv'
weights_df.to_csv(output_filename, encoding='utf-8-sig')
print(f"\n权重数据已保存到: {output_filename}")
输出结果:
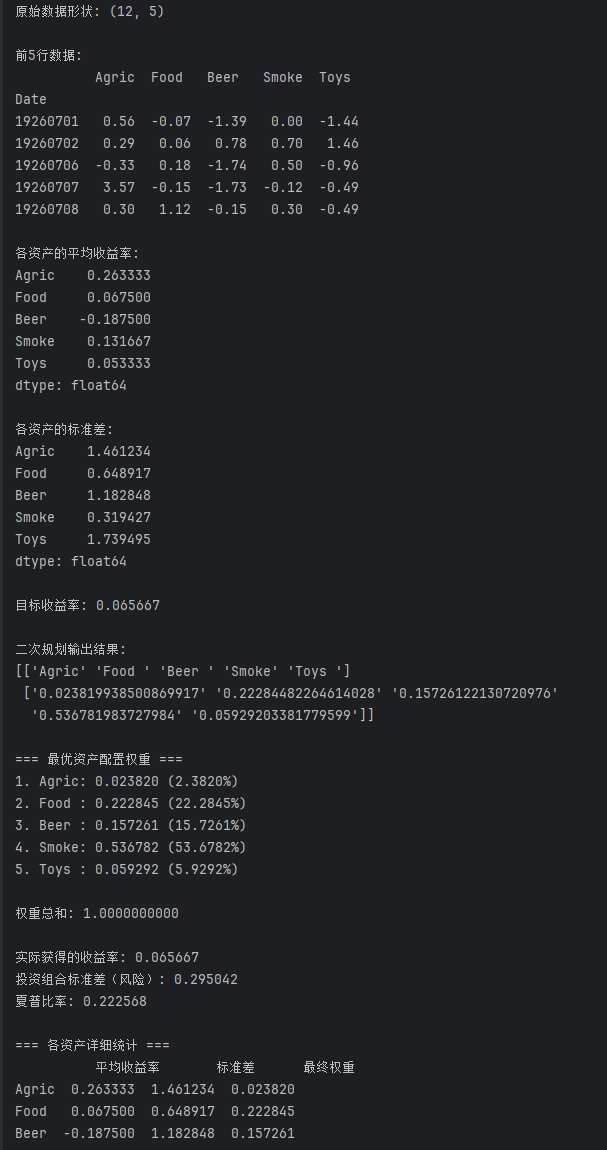

portfolio_weights_by_period.csv数据结果如下:

使用的industry2.csv数据文件与Black-Litterman模型数据文件一致。

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)