RRT、RRT*——路径规划算法(1)(附完整Matlab代码)
一、RRT
1.一次迭代原理
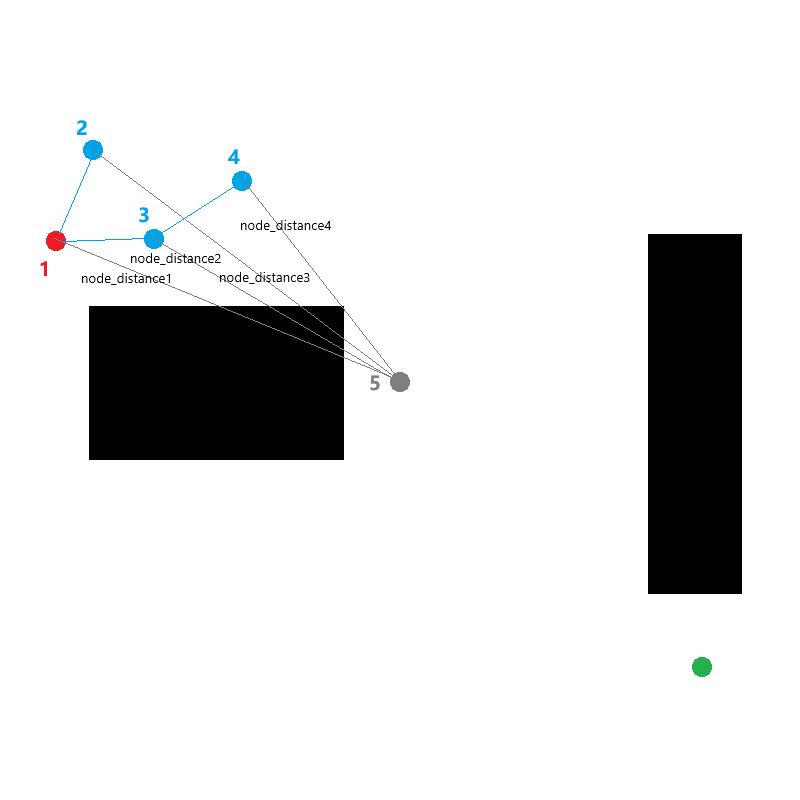
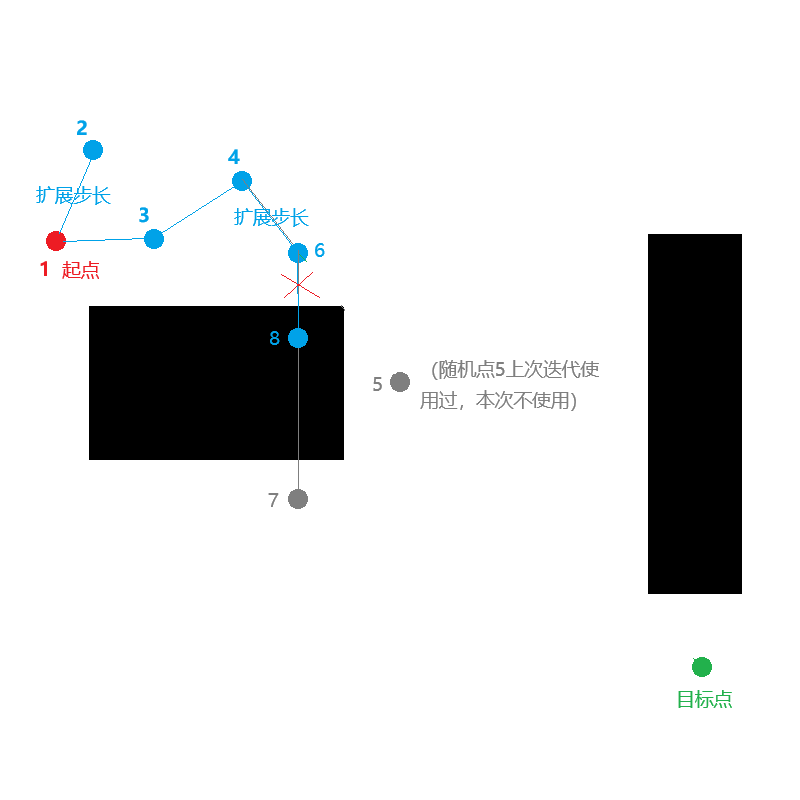
红点:起点 绿点:终点 蓝点:树节点 灰点:随机点
蓝色线:扩展步长(Prev到x_new) 绿色线:检查新节点(x_new)到目标点距离
(1)第一步
起点1、已生成节点:点2、点3、点4都已加入了树,此时生成随机点5,计算随机点5到树中所有节点距离node_distance,此时node_distance4最小。
(2)第二步(未碰障碍物)
选定节点4,向随机点5方向以一定长度扩展,并设立新的节点6(x_new),检查节点4到节点6路径上是否经过障碍物;再检查节点6到目标点距离,若小于设定的目标点阈值,则表示已经找到路径,可以回溯(从目标点向前查找父节点,生成完整路径)。假设,未经过障碍物,大于目标点阈值,将节点6加入树,并记录节点6的父节点,即节点4。

(3)第三步(碰撞障碍物)
同上,随机点7距离树中节点6最近,则有节点6向随机点7以一定步长扩展,得到节点8,检查该条扩展路径,发现经过了障碍物,则该条路径无效,节点8也无效,不必加入树。
2.RRT算法步骤
(1)初试化阶段
- 参数与节点设置:定义起点
(x_star, y_star)、终点(x_target, y_target),设置扩展步长Delta(控制每次扩展的距离)和目标阈值Thr(判断是否接近终点)。
%% 流程初始化
clc; clear all; close all;
x_star = 75; y_star = 290;         % 起点
x_target = 750; y_target = 750;     % 终点
Thr = 50;                          % 目标点阈值
Delta = 30;                        % 扩展步长
- 树结构初始化:创建树
T,以起点为根节点,初始化根节点的坐标、父节点信息(无父节点,indPrev=0)。
%% 构建树结构
T.v(1).x = x_star;
T.v(1).y = y_star;
T.v(1).xPrev = x_star;
T.v(1).yPrev = y_star;
T.v(1).dist = 0;
T.v(1).indPrev = 0;                % 根节点无父节点
- 地图与可视化准备:加载地图图像,转换为灰度图并显示;在地图上标记起点(红色)和终点(绿色),获取地图尺寸
xL(宽度)、yL(高度)。
%% 显示地图
figure(1);
ImpRgb = imread("newmap.png");
Imp = rgb2gray(ImpRgb);
imshow(Imp);
hold on;
plot(x_star, y_star, 'ro', 'MarkerSize', 10, 'MarkerFaceColor', 'r');
plot(x_target, y_target, 'go', 'MarkerSize', 10, 'MarkerFaceColor', 'g');

xL = size(Imp, 2);                 % 地图宽度
yL = size(Imp, 1);                 % 地图高度
count = 1;                         % 节点计数
bFind = false;                     % 路径找到标志
tic;                               % 开始计时
(2)主循环迭代
循环执行以下步骤,直至找到路径或达到最大迭代 次数(10000 次):
- 随机采样:在地图范围内随机生成一个点
point_rand(坐标为[rand(1)*xL, rand(1)*yL]),引导树的扩展方向。
% 1. 随机采样
    point_rand = [rand(1)*xL, rand(1)*yL];
- 寻找最近节点:计算树中所有现有节点到
point_rand的欧氏距离,找到距离最近的节点nearestNodeID(通过min(node_distance)获取)。
% 2. 寻找最近节点
    node_distance = inf(1, length(T.v));
    for i = 1:length(T.v)
        dist_temp = sqrt((T.v(i).x - point_rand(1))^2 + (T.v(i).y - point_rand(2))^2);
        node_distance(i) = dist_temp;
    end
    [~, nearestNodeID] = min(node_distance);
- 生成新节点:从最近节点
nearestNodeID出发,沿point_rand方向扩展固定步长Delta(若距离小于Delta则直接到达point_rand),得到新节点x_new。
% 3. 生成新节点
    x_near = [T.v(nearestNodeID).x, T.v(nearestNodeID).y];
    dir = point_rand - x_near;
    x_new = x_near + (dir / norm(dir)) * min(Delta, norm(dir));
- 碰撞检测:通过
collisionChecking函数验证从最近节点到x_new的路径是否可行(无障碍物、不越界)。若碰撞,跳过本次迭代。
    % 4. 碰撞检测
    if ~collisionChecking(x_near, x_new, Imp)
        continue;
    end
- 添加新节点:将
x_new加入树中,其父节点设为nearestNodeID,记录坐标、父节点索引、距离等信息。
 % 5. 添加新节点(直接使用最近节点作为父节点)
    count = count + 1;
    newNodeID = length(T.v) + 1;

    T.v(newNodeID).x = x_new(1);
    T.v(newNodeID).y = x_new(2);
    T.v(newNodeID).xPrev = T.v(nearestNodeID).x;
    T.v(newNodeID).yPrev = T.v(nearestNodeID).y;
    T.v(newNodeID).dist = sqrt((x_new(1) - T.v(nearestNodeID).x)^2 + (x_new(2) - T.v(nearestNodeID).y)^2);
    T.v(newNodeID).indPrev = nearestNodeID;  % 关键修改:直接使用最近节点作为父节点
- 可视化扩展:绘制从最近节点到
x_new的边(蓝色),实时显示树的生长过程。
    % 6. 绘制新路径
    plot([T.v(nearestNodeID).x, x_new(1)], [T.v(nearestNodeID).y, x_new(2)], 'b');
    hold on;
    pause(0.005);
- 目标检查:计算
x_new到终点的距离,若小于阈值Thr且路径无碰撞,标记 “找到路径” 并退出循环。
(3)结果处理与路径提取
- 时间计算:通过
toc获取从tic开始的规划总时间。 - 路径回溯:若找到路径,从终点反向追溯新节点的父节点指针(
indPrev),直至起点,拼接得到完整路径。 - 路径可视化与输出:绘制最终路径(红色粗线),计算路径总长度,输出规划时间、节点数、迭代次数等信息;若未找到路径,提示 “未找到路径”。
(4)碰撞检测函数
collisionChecking:沿起点到终点的路径均匀采样点,检查是否越界或触碰障碍物(地图中灰度值小于 255 的区域),返回路径是否可行(feasible)
3.完整RRT代码
(1)完整代码
%% 流程初始化
clc; clear all; close all;
x_star = 75; y_star = 290;         % 起点
x_target = 750; y_target = 750;     % 终点
Thr = 50;                          % 目标点阈值
Delta = 30;                        % 扩展步长

%% 构建树结构
T.v(1).x = x_star;
T.v(1).y = y_star;
T.v(1).xPrev = x_star;
T.v(1).yPrev = y_star;
T.v(1).dist = 0;
T.v(1).indPrev = 0;                % 根节点无父节点

%% 显示地图
figure(1);
ImpRgb = imread("newmap.png");
Imp = rgb2gray(ImpRgb);
imshow(Imp);
hold on;
plot(x_star, y_star, 'ro', 'MarkerSize', 10, 'MarkerFaceColor', 'r');
plot(x_target, y_target, 'go', 'MarkerSize', 10, 'MarkerFaceColor', 'g');

xL = size(Imp, 2);                 % 地图宽度
yL = size(Imp, 1);                 % 地图高度
count = 1;                         % 节点计数
bFind = false;                     % 路径找到标志
tic;                               % 开始计时

%% 主循环
for iter = 1:10000
    % 1. 随机采样
    point_rand = [rand(1)*xL, rand(1)*yL];

    % 2. 寻找最近节点
    node_distance = inf(1, length(T.v));
    for i = 1:length(T.v)
        dist_temp = sqrt((T.v(i).x - point_rand(1))^2 + (T.v(i).y - point_rand(2))^2);
        node_distance(i) = dist_temp;
    end
    [~, nearestNodeID] = min(node_distance);

    % 3. 生成新节点
    x_near = [T.v(nearestNodeID).x, T.v(nearestNodeID).y];
    dir = point_rand - x_near;
    x_new = x_near + (dir / norm(dir)) * min(Delta, norm(dir));

    % 4. 碰撞检测
    if ~collisionChecking(x_near, x_new, Imp)
        continue;
    end

    % 5. 添加新节点(直接使用最近节点作为父节点)
    count = count + 1;
    newNodeID = length(T.v) + 1;

    T.v(newNodeID).x = x_new(1);
    T.v(newNodeID).y = x_new(2);
    T.v(newNodeID).xPrev = T.v(nearestNodeID).x;
    T.v(newNodeID).yPrev = T.v(nearestNodeID).y;
    T.v(newNodeID).dist = sqrt((x_new(1) - T.v(nearestNodeID).x)^2 + (x_new(2) - T.v(nearestNodeID).y)^2);
    T.v(newNodeID).indPrev = nearestNodeID;  % 关键修改:直接使用最近节点作为父节点

    % 6. 绘制新路径
    plot([T.v(nearestNodeID).x, x_new(1)], [T.v(nearestNodeID).y, x_new(2)], 'b');
    hold on;
    pause(0.005);

    % 7. 检查是否到达目标
    dist_to_goal = sqrt((x_target - x_new(1))^2 + (y_target - x_new(2))^2);
    if dist_to_goal < Thr && collisionChecking(x_new, [x_target, y_target], Imp)
        bFind = true;
        break;
    end

    % 显示进度
    if mod(iter, 100) == 0
        fprintf('迭代: %d, 节点数: %d\n', iter, length(T.v));
    end
end

%% 计算时间 & 路径回溯
planning_time = toc;
if bFind
    path.pos(1).x = x_target;
    path.pos(1).y = y_target;
    currentNode = length(T.v);

    while true
        path.pos(end+1).x = T.v(currentNode).x;
        path.pos(end).y = T.v(currentNode).y;
        if T.v(currentNode).indPrev == 0
            break;
        end
        currentNode = T.v(currentNode).indPrev;
    end

    path.pos(end+1).x = x_star;
    path.pos(end).y = y_star;

    % 绘制最终路径
    for j = 1:length(path.pos)-1
        plot([path.pos(j).x, path.pos(j+1).x],...
             [path.pos(j).y, path.pos(j+1).y],...
             'r', 'LineWidth', 3);
    end

    % 计算路径长度
    path_length = 0;
    for j = 1:length(path.pos)-1
        segment_length = sqrt((path.pos(j).x - path.pos(j+1).x)^2 + ...
                         (path.pos(j).y - path.pos(j+1).y)^2);
        path_length = path_length + segment_length;
    end

    % 输出结果
    fprintf('路径规划完成!\n');
    fprintf('路径长度: %.2f 像素\n', path_length);
    fprintf('节点数量: %d\n', length(T.v));
    fprintf('迭代次数: %d\n', iter);
    fprintf('规划时间: %.4f 秒\n', planning_time);
    title(sprintf('RRT 路径 (长度: %.2f, 时间: %.4f秒)', path_length, planning_time));
else
    disp('未找到路径!');
end

%% 碰撞检测函数(保持不变)
function feasible = collisionChecking(start, goal, map)
    feasible = true;
    dir = goal - start;
    dist = norm(dir);
    if dist < 1
        return;
    end
    step = ceil(dist);
    for d = 0:1/step:1
        pos_check = round(start + d*dir);
        if pos_check(1) < 1 || pos_check(2) < 1 || ...
           pos_check(1) > size(map,2) || pos_check(2) > size(map,1) || ...
           map(pos_check(2), pos_check(1)) < 255
            feasible = false;
            return;
        end
    end
end
(2)地图
文件名称:newmap,格式:png

(3)完整代码运行效果

4.RRT优缺点
(1)优点
-
概率完备性
理论上,只要目标点可达,通过足够多的随机采样,RRT 算法最终能以概率 1 找到一条可行路径(区别于 “绝对完备性”,后者能保证在有限步骤内找到路径,若存在)。 -
高维空间适应性强
无需预先构建环境的显式表示(如栅格地图或势场),通过随机采样和树结构扩展,能有效处理高维构型空间(如机器人的多自由度运动规划),避免了高维空间中 “维度灾难” 带来的计算复杂度激增。 -
实现简单
核心逻辑清晰(随机采样→找最近节点→扩展新节点→碰撞检测),编程实现难度低,如示例代码中仅通过基本的几何计算和循环即可完成核心流程。 -
适用于复杂障碍物环境
无需对障碍物进行复杂建模,通过碰撞检测函数(如示例中的collisionChecking)可直接判断路径是否与障碍物冲突,能处理不规则或未知障碍物场景。
(2)缺点
-
路径非最优性
由于依赖随机采样扩展,生成的路径通常曲折、冗余,并非最短或最优路径(如示例中路径沿随机方向扩展,缺乏对路径长度的优化)。 -
收敛速度慢
随机采样的盲目性可能导致大量无效扩展(尤其是在障碍物密集的环境中),需要大量迭代才能找到目标,效率较低(示例中最多迭代 10000 次,仍可能失败)。 -
对参数敏感
性能严重依赖扩展步长(Delta)、目标阈值(Thr)等参数:步长过大可能导致碰撞检测失效,步长过小则扩展效率低下;阈值设置不当可能过早终止或延迟找到目标。 -
路径平滑性差
生成的路径由大量短直线段组成,存在较多拐点,实际应用中需额外进行路径优化(如分段平滑处理)才能用于机器人控制。 -
缺乏回溯能力
树结构一旦扩展,节点的父节点固定(如示例中直接以最近节点为父节点),无法通过调整已扩展节点的连接关系优化路径(RRT * 算法通过 “重连” 机制部分解决了这一问题)。
二、RRT*
1.RRT*与RRT差异
RRT*(Rapidly-exploring Random Trees Star)是 RRT 算法的渐进最优版本,在保持 RRT 概率完备性的基础上,通过优化机制逐渐逼近全局最优路径。RRT*增加了2个关键步骤。
(1)重新选择最优父节点
步骤1:假设节点1、2、3、4、5、6、7,均加入了树节点。节点7拓展出了节点8(节点7是节点8的父节点),开始对节点8重新选择父节点。以节点8为原点,r为半径,作圆。
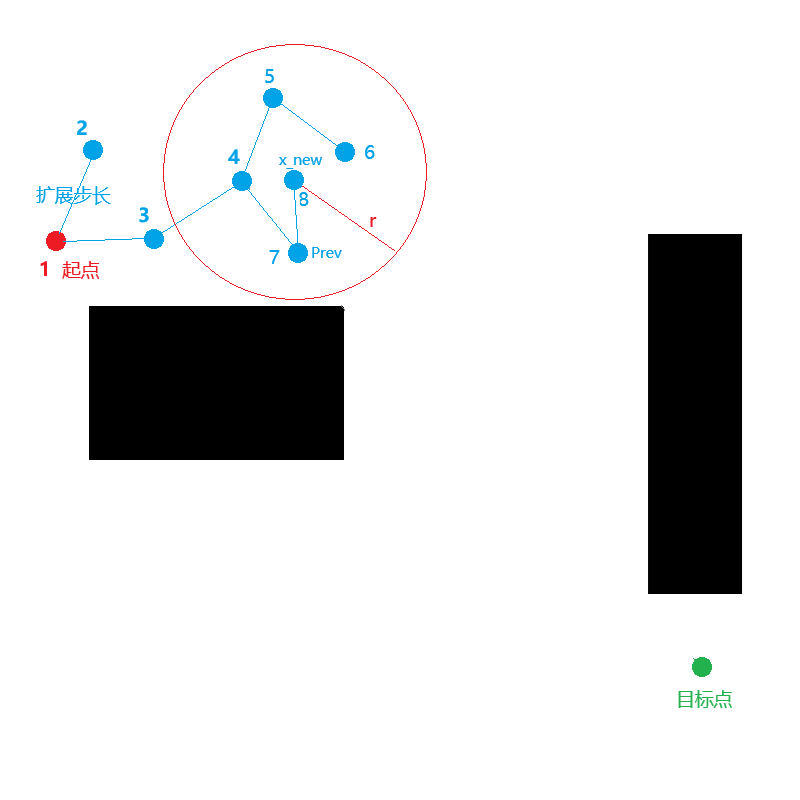
第二步:连接节点8到圆内的各个节点(灰色线段),记录min(各个灰色线段长度、节点7到节点8距离长度):节点8到节点4距离长度最短,故更新节点8的父节点为节点4。

第三步:连接节点4和节点8,为有效路径,此时节点8的父节点更换为了节点4;消除节点7到节点8的原路径。将更新后的父节点信息加入树。

(2)重新布线
第一步:连接节点8到圆内的各个节点(灰色线段,父节点不用连接)。

第二步:如果(节点8到节点6的距离长度+节点8的距离代价<节点6的距离代价)则将节点5到节点6断开,连接节点8和节点6,完成对节点6的重新布线。
节点8的距离代价:到节点8的整条路径代价(1==>3==>4==>8)
节点6的距离代价:到节点6的整条路径代价(1==>3==>4==>5==>6)
判断 (1==>3==>4==>8)+(8==>6)是否小于(1==>3==>4==>5==>6)
是:断开(5==>6),连接(8==>6)
否:检查下一个节点(节点8的父节点4不用检查)
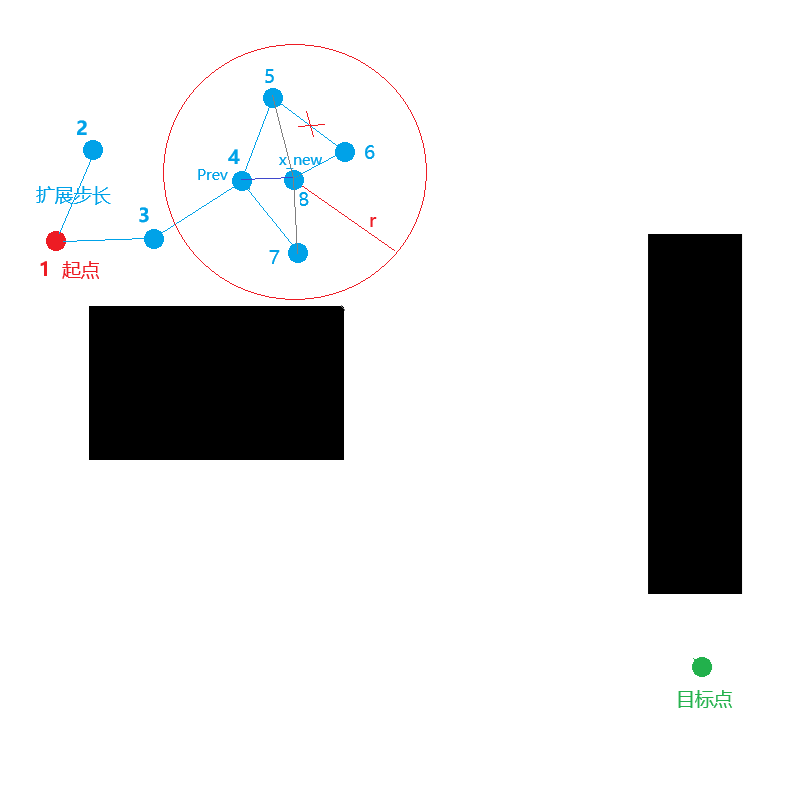
最终重布线效果如下:

2.完整RRT*代码
(1)完整代码
%% 流程初始化
clc
clear all; close all;
x_star=75; y_star=290;                % 设置初始点坐标
x_target=750; y_target=750;        % 设置终点坐标
Thr=50;                            % 设置目标点阈值
Delta=30;                          % 设置扩展步长
r = 50;                            % RRT* 邻域搜索半径

%% 构建第1个树的结点
T.v(1).x = x_star;
T.v(1).y = y_star;                 % 当前节点坐标
T.v(1).xPrev = x_star;
T.v(1).yPrev = y_star;             % 父节点坐标
T.v(1).dist = 0;                   % 当前节点到父节点距离
T.v(1).indPrev = 0;                % 父节点的索引
T.v(1).cost = 0;                   % 根节点到当前节点的路径代价
T.v(1).children = [];              % 子节点索引列表

set (figure(1),'position',[1000,100,800,600] ); % 创建图形窗口1
ImpRgb=imread("newmap.png");       % 读取图片
Imp=rgb2gray(ImpRgb);              % 将图片转换为灰度
imshow(Imp);                       % 显示图片
hold on                            % 保持图形

xL = size(Imp,2);                  % 地图宽度
yL = size(Imp,1);                  % 地图高度

% 绘制起点和终点
plot(x_star,y_star,'ro','MarkerSize',10, 'MarkerFaceColor','r');
plot(x_target,y_target,'go','MarkerSize',10, 'MarkerFaceColor','g');
count=1;                           % 节点计数
bFind=false;                       % 路径找到标志
%% 新增:开始计时
tic;  % 开始计时

%% 主循环
for iter = 1:10000                 % 最大迭代次数
    %=== 步骤1:随机采样 ===
    point_rand = [rand(1)*xL, rand(1)*yL];

    %=== 步骤2:寻找最近节点 ===
    node_distance = inf(1, length(T.v));%创建一个长度为当前树中节点的数量,记录随机点到所有树节点的距离
    for i = 1:length(T.v)%计算随机点与所有节点的距离
        dist_temp = sqrt((T.v(i).x - point_rand(1))^2 + (T.v(i).y - point_rand(2))^2);
        node_distance(i) = dist_temp;
    end
    [min_dist, nearestNodeID] = min(node_distance);% 找到最小距离及其对应的节点索引

    %=== 步骤3:生成新节点 ===
    x_near = [T.v(nearestNodeID).x, T.v(nearestNodeID).y];
    dir = point_rand - x_near;
    x_new = x_near + (dir / norm(dir)) * min(Delta, norm(dir));

    %=== 碰撞检测 ===
    if ~collisionChecking(x_near, x_new, Imp)
        continue;
    end

    %=== RRT* 改进1:寻找邻域节点 ===
    neighborNodes = [];
    neighborCosts = [];
    for i = 1:length(T.v)%遍历树中所有已有节点
        dist_to_new = sqrt((T.v(i).x - x_new(1))^2 + (T.v(i).y - x_new(2))^2);%计算新节点到所有树节点的欧式距离
        %条件1:节点i在新节点的邻域半径r内
        %条件2:节点i到新节点的路径无碰撞
        if dist_to_new <= r && collisionChecking([T.v(i).x, T.v(i).y], x_new, Imp)
            % (节点i的当前代价 + 节点i到新节点的距离)
            % 计算通过节点i到达新节点的总路径代价
            neighborNodes(end+1) = i;%记录圆范围内节点的序号
            neighborCosts(end+1) = T.v(i).cost + dist_to_new; %整条路径的代价
        end
    end

    %=== RRT* 改进2:选择最优父节点 ===
    [min_cost, idx] = min(neighborCosts);%取圆范围内新节点到树节点最短距离
    bestNodeID = neighborNodes(idx);%记录 父节点的序号

    % 添加新节点
    count = count + 1;
    newNodeID = length(T.v) + 1;%序号增加1

    T.v(newNodeID).x = x_new(1);
    T.v(newNodeID).y = x_new(2);
    T.v(newNodeID).xPrev = T.v(bestNodeID).x;%根据上面的最优父节点序号,记录新节点的父节点坐标
    T.v(newNodeID).yPrev = T.v(bestNodeID).y;
    T.v(newNodeID).dist = sqrt((x_new(1)-T.v(bestNodeID).x)^2 + (x_new(2)-T.v(bestNodeID).y)^2);%记录子节点到更新后的父节点间距离
    T.v(newNodeID).indPrev = bestNodeID;%将最优父节点序号记录
    T.v(newNodeID).cost = min_cost;%由更新后父节点到子节点的整个路径距离
    T.v(newNodeID).children = [];

    % 更新父节点的子节点列表
    T.v(bestNodeID).children(end+1) = newNodeID;%记录父节点的孩子点在树中的序号,可以有多个孩子

    % 绘制新路径
    plot([T.v(bestNodeID).x, x_new(1)], [T.v(bestNodeID).y, x_new(2)], 'b');
    hold on;
    pause(0.005);

    %=== RRT* 改进3:重布线 ===
    for i = 1:length(neighborNodes)
        nid = neighborNodes(i);
        % 跳过父节点自身
        if nid == bestNodeID
            continue;
        end

        % 计算通过新节点的路径代价 从新节点到圆范围内点的距离代价
        new_cost = T.v(newNodeID).cost + sqrt((T.v(nid).x - x_new(1))^2 + (T.v(nid).y - x_new(2))^2);

        % 检查是否优化  从新节点到圆范围内某点的距离代价<从某点的父节点到某点的距离代价(某点代价) ?
        if new_cost < T.v(nid).cost && collisionChecking(x_new, [T.v(nid).x, T.v(nid).y], Imp)
            % 从原父节点移除
            oldParent = T.v(nid).indPrev;%若满足条件,先将某点的父节点在树中的序号赋值给oldParent
            T.v(oldParent).children = setdiff(T.v(oldParent).children, nid);%将某点之前的父节点的孩子集中的序号移除

            % 更新节点信息 更新某点的节点信息
            T.v(nid).indPrev = newNodeID;%更新某点的父节点在树中的序号为:新节点的序号
            T.v(nid).xPrev = x_new(1);%更新某点的父节点为新节点的坐标
            T.v(nid).yPrev = x_new(2);
            T.v(nid).dist = sqrt((T.v(nid).x - x_new(1))^2 + (T.v(nid).y - x_new(2))^2);%更新某点到新的父节点的距离代价
            T.v(nid).cost = new_cost;%更新新的整个路径的距离代价

            % 添加到新父节点
            T.v(newNodeID).children(end+1) = nid;%新节点成为父节点,添加孩子信息

            % 绘制重布线
            plot([x_new(1), T.v(nid).x], [x_new(2), T.v(nid).y], 'c');
            hold on;
            pause(0.005);
        end
    end

    %=== 检查是否到达目标 ===
    dist_to_goal = sqrt((x_target - x_new(1))^2 + (y_target - x_new(2))^2);
    if dist_to_goal < Thr && collisionChecking(x_new, [x_target, y_target], Imp)
        bFind = true;
        break;
    end
    %% 每100次迭代显示进度
    if mod(iter, 100) == 0
        fprintf('迭代: %d, 节点数: %d\n', iter, length(T.v));
    end
end
%% 新增:计算路径规划时间
planning_time = toc;  % 结束计时


%% 路径回溯
if bFind
    % 添加目标点
    path.pos(1).x = x_target;
    path.pos(1).y = y_target;
    currentNode = length(T.v);

    % 回溯到起点
    while true
        path.pos(end+1).x = T.v(currentNode).x;
        path.pos(end).y = T.v(currentNode).y;
        if T.v(currentNode).indPrev == 0
            break;
        end
        currentNode = T.v(currentNode).indPrev;
    end

    % 添加起点
    path.pos(end+1).x = x_star;
    path.pos(end).y = y_star;

    % 绘制最终路径
    for j = 1:length(path.pos)-1
        plot([path.pos(j).x, path.pos(j+1).x],...
             [path.pos(j).y, path.pos(j+1).y],...
             'r', 'LineWidth', 3);
    end
    % 计算并显示路径长度
    path_length = 0;
    for j = 1:length(path.pos)-1
        segment_length = sqrt((path.pos(j).x - path.pos(j+1).x)^2 + ...
                         (path.pos(j).y - path.pos(j+1).y)^2);
        path_length = path_length + segment_length;
    end
    %% 新增:显示路径规划时间
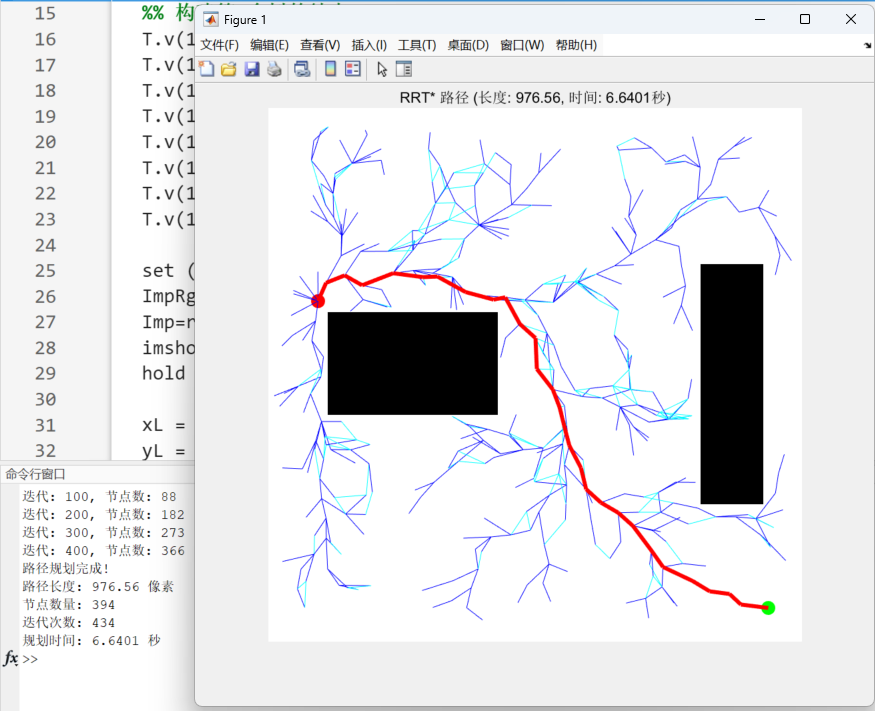
    fprintf('路径规划完成!\n');
    fprintf('路径长度: %.2f 像素\n', path_length);
    fprintf('节点数量: %d\n', length(T.v));
    fprintf('迭代次数: %d\n', iter);
    fprintf('规划时间: %.4f 秒\n', planning_time);

    title_str = sprintf('RRT* 路径 (长度: %.2f, 时间: %.4f秒)', path_length, planning_time);
    title(title_str);
else
    disp('Error, no path found!');
end

%% 碰撞检测函数 (保持不变)
function feasible = collisionChecking(start, goal, map)
    feasible = true;
    dir = goal - start;
    dist = norm(dir);
    if dist < 1
        return;
    end
    step = ceil(dist);
    for d = 0:1/step:1
        pos_check = round(start + d*dir);
        if pos_check(1) < 1 || pos_check(2) < 1 || ...
           pos_check(1) > size(map,2) || pos_check(2) > size(map,1) || ...
           map(pos_check(2), pos_check(1)) < 255
            feasible = false;
            return;
        end
    end
end
(2)完整代码运行效果
3.RRT*优缺点
(1)优点
-
渐近最优性
相比只能找到 “可行路径” 的 RRT,RRT * 通过 “重布线(rewire)” 步骤优化路径:每次扩展新节点时,会检查邻域内的已有节点,通过重新选择父节点降低路径总成本(如距离),最终随着采样点数量增加,路径会概率收敛到最优解(理论上可无限接近全局最优)。 -
高维空间适应性
继承了 RRT 的随机采样特性,无需对环境进行结构化建模,能有效探索高维构型空间(如机械臂多关节、移动机器人带姿态约束的场景),避免了传统网格法在高维空间中计算爆炸的问题。 -
增量式构建
树结构通过逐步采样和扩展动态生长,无需一次性遍历整个环境,适合动态或部分未知环境(可在环境变化时局部更新树,无需重新规划全局)。 -
无需精确先验模型
仅通过随机采样和碰撞检测即可工作,无需环境的解析表达式(如障碍物的精确几何参数),对非结构化环境(如自然地形、杂乱场景)适应性强。 -
实现相对简单
核心逻辑(采样、扩展、重布线)易于编程实现,相比基于优化的路径规划算法(如非线性规划)或复杂图搜索算法(如带约束的 A * 变种),工程落地门槛较低。
(2)缺点
-
收敛速度慢 虽然能渐近最优,但依赖大量采样点才能接近最优解,在需要实时性的场景(如动态避障)中表现不足,尤其在复杂环境中,可能需要成百上千次采样才能生成高质量路径。
-
路径不平滑 由于随机采样的特性,生成的路径可能包含大量冗余拐点(锯齿状),需额外的后处理(如贝塞尔曲线拟合、多项式平滑)才能满足实际机器人的运动学需求(如减少转向次数)。
-
对参数敏感 性能严重依赖邻域半径(用于重布线的节点搜索范围)等参数:
-
邻域半径过大会导致重布线时检查节点过多,计算成本激增;
-
半径过小则可能错过更优的父节点,无法实现有效重布线,丧失最优性。
-
-
狭窄通道效率低 随机采样难以命中狭窄通道(如两个障碍物间的狭长区域),导致该区域探索缓慢,路径生成耗时;即使生成路径,也可能因采样不足导致最优性下降。
-
计算成本较高 重布线步骤会增加计算量:每次扩展新节点时,需遍历邻域内所有节点并评估路径成本,随着树的规模增大,该过程的时间复杂度显著上升(近似为(O(n^2)),n为树节点数)。
-
动态环境适应性有限 虽然支持增量式更新,但在环境快速变化时(如障碍物突然移动),需重新扩展树或调整重布线关系,大规模树的更新成本较高,实时性难以保证。
-
最优性是概率意义上的 依赖随机采样,路径最优性是 “概率渐近” 的(随采样数增加收敛),而非绝对最优;在某些场景下,可能需要极多样本才能收敛。

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐

 36
 0
- 0


 已为社区贡献2条内容

所有评论(0)