机器翻译与数据集
机器翻译与数据集
语言模型是自然语言处理的关键,而机器翻译是语言模型最成功的基准测试。因为机器翻译正是将输入序列转换成输出序列的序列转换模型(sequence transduction)的核心问题。序列转换模型在各类现代人工智能应用中发挥着至关重要的作用。
机器翻译(machine translation)指的是将序列从一种语言自动翻译成另一种语言。事实上,这个研究领域可以追溯到数字计算机发明后不久的20世纪40年代,特别是在第二次世界大战中使用计算机破解语言编码。几十年来,在使用神经网络进行端到端学习的兴起之前,统计学方法在这一领域一直占据主导地位 :cite:Brown.Cocke.Della-Pietra.ea.1988,Brown.Cocke.Della-Pietra.ea.1990。因为统计机器翻译(statistical machine translation)涉及了翻译模型和语言模型等组成部分的统计分析,因此基于神经网络的方法通常被称为神经机器翻译(neural machine translation),用于将两种翻译模型区分开来。
关注神经网络机器翻译方法,强调的是端到端的学习。与语言模型中的语料库是单一语言的语言模型问题存在不同,机器翻译的数据集是由源语言和目标语言的文本序列对组成的。因此,我们需要一种完全不同的方法来预处理机器翻译数据集,而不是复用语言模型的预处理程序。下面,我们看一下如何将预处理后的数据加载到小批量中用于训练。
import os
import torch
from d2l import torch as d2l
[下载和预处理数据集]
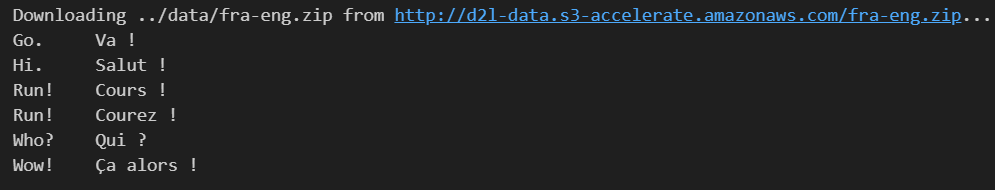
首先,下载一个由Tatoeba项目的双语句子对组成的“英-法”数据集,数据集中的每一行都是制表符分隔的文本序列对,序列对由英文文本序列和翻译后的法语文本序列组成。请注意,每个文本序列可以是一个句子,也可以是包含多个句子的一个段落。在这个将英语翻译成法语的机器翻译问题中,英语是源语言(source language),法语是目标语言(target language)。
# @save
# 将“英语-法语”数据集的URL和校验码添加到d2l.DATA_HUB中
# d2l.DATA_HUB是一个字典,用于存储数据集的下载链接和校验码
# 'fra-eng' 是数据集的名称
# d2l.DATA_URL 是数据集的基础URL
# '94646ad1522d915e7b0f9296181140edcf86a4f5' 是数据集的SHA-1校验码,用于验证文件完整性
d2l.DATA_HUB['fra-eng'] = (d2l.DATA_URL + 'fra-eng.zip',
                           '94646ad1522d915e7b0f9296181140edcf86a4f5')

# @save


def read_data_nmt():
    """
    载入“英语-法语”数据集。

    返回:
    str
        包含整个数据集的文本内容,每一行是一个制表符分隔的文本序列对。
    """
    # 下载并解压“英语-法语”数据集
    # d2l.download_extract 会根据提供的名称从 d2l.DATA_HUB 下载数据集并解压
    data_dir = d2l.download_extract('fra-eng')

    # 打开解压后的数据文件 'fra.txt',以只读模式读取内容
    # 使用 UTF-8 编码以确保正确处理非ASCII字符
    with open(os.path.join(data_dir, 'fra.txt'), 'r',
              encoding='utf-8') as f:
        # 读取整个文件内容并返回
        return f.read()


# 调用 read_data_nmt 函数,读取“英语-法语”数据集的原始文本内容
raw_text = read_data_nmt()
# 打印原始文本的前75个字符,方便快速查看数据内容
print(raw_text[:75])
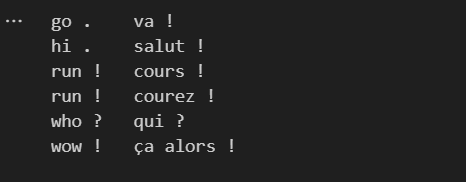
下载数据集后,原始文本数据需要经过几个预处理步骤。例如用空格代替不间断空格(non-breaking space),使用小写字母替换大写字母,并在单词和标点符号之间插入空格。
#@save
def preprocess_nmt(text):
    """预处理“英语-法语”数据集"""
    def no_space(char, prev_char):
        """
        判断是否需要在当前字符和前一个字符之间插入空格。
        如果当前字符是标点符号(如,.!?)且前一个字符不是空格,则返回True。
        """
        return char in set(',.!?') and prev_char != ' '

    # 使用空格替换不间断空格(\u202f)和不可换行空格(\xa0)
    # 将所有字符转换为小写字母
    text = text.replace('\u202f', ' ').replace('\xa0', ' ').lower()

    # 遍历文本中的每个字符
    # 如果当前字符是标点符号且前一个字符不是空格,则在标点符号前插入一个空格
    # 否则,保持字符不变
    out = [' ' + char if i > 0 and no_space(char, text[i - 1]) else char
           for i, char in enumerate(text)]

    # 将字符列表合并为字符串并返回
    return ''.join(out)

# 对原始文本进行预处理
text = preprocess_nmt(raw_text)

# 打印预处理后的文本的前80个字符
print(text[:80])
词元化
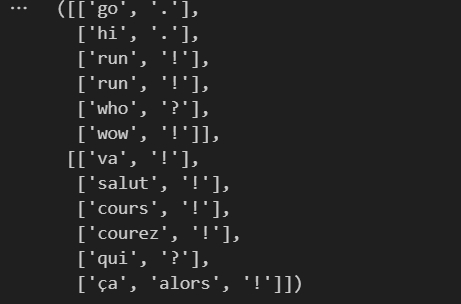
与语言模型中的字符级词元化不同,在机器翻译中,更喜欢单词级词元化(最先进的模型可能使用更高级的词元化技术)。下面的tokenize_nmt函数对前num_examples个文本序列对进行词元,其中每个词元要么是一个词,要么是一个标点符号。此函数返回两个词元列表:source和target:source[i]是源语言(这里是英语)第
i
i
i个文本序列的词元列表,target[i]是目标语言(这里是法语)第
i
i
i个文本序列的词元列表。
#@save
def tokenize_nmt(text, num_examples=None):
    """
    词元化“英语-法语”数据集。
    将文本数据分割成源语言和目标语言的词元列表。

    参数:
    text: str
        包含“英语-法语”数据集的原始文本。
        每一行是一个制表符分隔的文本序列对(英语和法语)。
    num_examples: int, 可选
        指定要处理的最大文本序列对数量。
        如果为None,则处理所有文本序列对。

    返回:
    source: list of list of str
        源语言(英语)的词元列表,每个子列表对应一个文本序列。
    target: list of list of str
        目标语言(法语)的词元列表,每个子列表对应一个文本序列。
    """
    source, target = [], []  # 初始化源语言和目标语言的词元列表
    for i, line in enumerate(text.split('\n')):  # 按行分割文本数据
        if num_examples and i > num_examples:  # 如果达到指定的最大数量,则停止处理
            break
        parts = line.split('\t')  # 按制表符分割每一行,得到源语言和目标语言的文本
        """
        line = "I am a student.\tJe suis un étudiant."
        """
        if len(parts) == 2:  # 确保每一行有且仅有两个部分(源语言和目标语言)
            source.append(parts[0].split(' '))  # 将源语言文本按空格分割成词元列表
            target.append(parts[1].split(' '))  # 将目标语言文本按空格分割成词元列表
    return source, target  # 返回源语言和目标语言的词元列表

# 对预处理后的文本进行词元化
source, target = tokenize_nmt(text)

# 打印源语言和目标语言的前6个文本序列的词元列表
source[:6], target[:6]
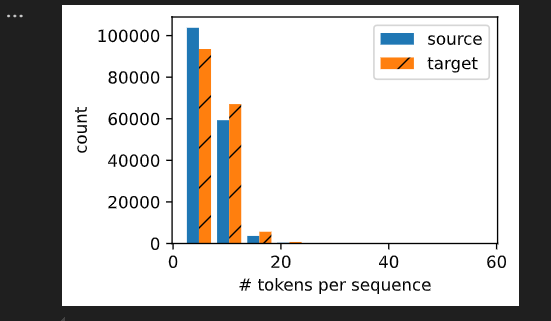
绘制每个文本序列所包含的词元数量的直方图。在这个简单的“英-法”数据集中,大多数文本序列的词元数量少于
20
20
20个。
#@save
def show_list_len_pair_hist(legend, xlabel, ylabel, xlist, ylist):
    """
    绘制两个列表中元素长度的直方图。

    参数:
    legend: list of str
        图例的标签列表,用于标识两个列表的名称。
    xlabel: str
        x轴的标签,表示横轴的含义。
    ylabel: str
        y轴的标签,表示纵轴的含义。
    xlist: list of list
        第一个列表,包含多个子列表,每个子列表的长度将用于绘制直方图。
    ylist: list of list
        第二个列表,包含多个子列表,每个子列表的长度将用于绘制直方图。
    """
    # 设置图形的大小
    d2l.set_figsize()

    # 绘制直方图,统计两个列表中每个子列表的长度
    # patches 是一个包含直方图条形对象的列表
    _, _, patches = d2l.plt.hist(
        [[len(l) for l in xlist], [len(l) for l in ylist]])  # 计算每个子列表的长度并绘制直方图

    # 设置x轴的标签
    d2l.plt.xlabel(xlabel)

    # 设置y轴的标签
    d2l.plt.ylabel(ylabel)

    # 为第二个列表的直方图条形添加斜线填充样式,以便区分两个列表
    for patch in patches[1].patches:
        patch.set_hatch('/')

    # 添加图例,用于标识两个列表
    d2l.plt.legend(legend)

# 调用函数,绘制源语言和目标语言的词元数量直方图
show_list_len_pair_hist(['source', 'target'], '# tokens per sequence',
                        'count', source, target);
词表
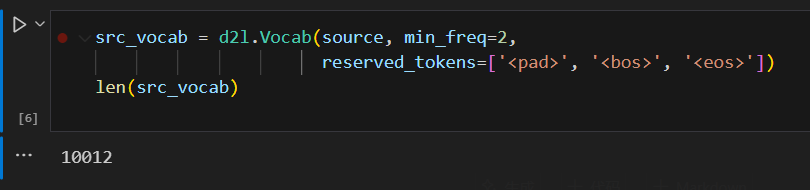
由于机器翻译数据集由语言对组成,因此我们可以分别为源语言和目标语言构建两个词表。使用单词级词元化时,词表大小将明显大于使用字符级词元化时的词表大小。为了缓解这一问题,这里我们将出现次数少于2次的低频率词元视为相同的未知(“<unk>”)词元。除此之外,我们还指定了额外的特定词元,例如在小批量时用于将序列填充到相同长度的填充词元(“<pad>”),以及序列的开始词元(“<bos>”)和结束词元(“<eos>”)。这些特殊词元在自然语言处理任务中比较常用。
加载数据集
语言模型中的[序列样本都有一个固定的长度],无论这个样本是一个句子的一部分还是跨越了多个句子的一个片断。这个固定长度是由语言模型中的num_steps(时间步数或词元数量)参数指定的。在机器翻译中,每个样本都是由源和目标组成的文本序列对,其中的每个文本序列可能具有不同的长度。
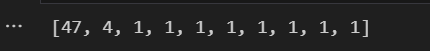
为了提高计算效率,我们仍然可以通过截断(truncation)和填充(padding)方式实现一次只处理一个小批量的文本序列。假设同一个小批量中的每个序列都应该具有相同的长度num_steps,那么如果文本序列的词元数目少于num_steps时,我们将继续在其末尾添加特定的“<pad>”词元,直到其长度达到num_steps;反之,我们将截断文本序列时,只取其前num_steps 个词元,并且丢弃剩余的词元。这样,每个文本序列将具有相同的长度,以便以相同形状的小批量进行加载。
如前所述,下面的truncate_pad函数将(截断或填充文本序列)。
#@save
def truncate_pad(line, num_steps, padding_token):
    """
    截断或填充文本序列。

    参数:
    line: list of int
        表示文本序列的词元索引列表。
    num_steps: int
        指定序列的目标长度。
    padding_token: int
        用于填充的特殊词元索引。

    返回:
    list of int
        经过截断或填充后的文本序列,长度为num_steps。
    """
    if len(line) > num_steps:
        # 如果序列长度超过目标长度,则截断到目标长度
        return line[:num_steps]
    # 如果序列长度小于目标长度,则在末尾填充指定的填充词元,直到达到目标长度
    """
    在 Python 中,列表乘法(*)的行为是:
        如果乘数为正数,生成一个重复的列表。
        如果乘数为 0 或负数,返回一个空列表。
    """
    return line + [padding_token] * (num_steps - len(line))

# 调用truncate_pad函数,对源语言的第一个文本序列进行截断或填充
# 将其转换为长度为10的序列,使用src_vocab['<pad>']作为填充词元
truncate_pad(src_vocab[source[0]], 10, src_vocab['<pad>'])
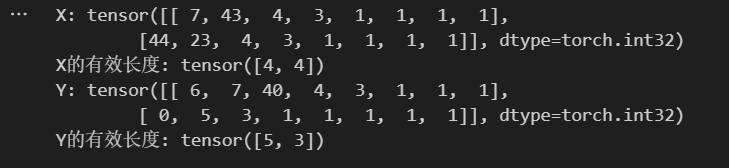
现在我们定义一个函数,可以将文本序列[转换成小批量数据集用于训练]。我们将特定的“<eos>”词元添加到所有序列的末尾,用于表示序列的结束。当模型通过一个词元接一个词元地生成序列进行预测时,生成的“<eos>”词元说明完成了序列输出工作。此外,我们还记录了每个文本序列的长度,统计长度时排除了填充词元,在稍后将要介绍的一些模型会需要这个长度信息。
#@save
def build_array_nmt(lines, vocab, num_steps):
    """
    将机器翻译的文本序列转换成小批量。

    参数:
    lines: list of list of str
        文本序列的词元列表,每个子列表表示一个文本序列。
    vocab: d2l.Vocab
        词表对象,用于将词元转换为索引。
    num_steps: int
        每个序列的目标长度(时间步数)。

    返回:
    array: torch.Tensor
        转换后的张量,形状为 (batch_size, num_steps),
        每行表示一个经过截断或填充的文本序列。
    valid_len: torch.Tensor
        每个序列的有效长度(不包括填充词元的长度),形状为 (batch_size,)。
    """
    # 将每个文本序列中的词元转换为对应的索引
    lines = [vocab[l] for l in lines]

    # 在每个序列的末尾添加特殊的结束词元(<eos>)
    lines = [l + [vocab['<eos>']] for l in lines]

    # 对每个序列进行截断或填充,使其长度为num_steps
    # 并将结果转换为PyTorch张量
    array = torch.tensor([truncate_pad(
        l, num_steps, vocab['<pad>']) for l in lines])

    # 计算每个序列的有效长度(不包括填充词元的长度)
    # 使用 (array != vocab['<pad>']) 判断哪些位置不是填充词元
    # 然后对每行的非填充词元计数
    valid_len = (array != vocab['<pad>']).type(torch.int32).sum(1)

    # 返回转换后的张量和有效长度
    return array, valid_len
训练模型
最后定义load_data_nmt函数来返回数据迭代器,以及源语言和目标语言的两种词表。
#@save
def load_data_nmt(batch_size, num_steps, num_examples=600):
    """
    返回翻译数据集的迭代器和词表。

    参数:
    batch_size: int
        每个小批量的样本数量。
    num_steps: int
        每个序列的目标长度(时间步数)。
    num_examples: int, 可选
        要处理的最大文本序列对数量,默认为600。

    返回:
    data_iter: torch.utils.data.DataLoader
        数据迭代器,用于按小批量加载数据。
    src_vocab: d2l.Vocab
        源语言的词表对象。
    tgt_vocab: d2l.Vocab
        目标语言的词表对象。
    """
    # 读取并预处理原始的“英语-法语”数据集
    text = preprocess_nmt(read_data_nmt())

    # 对预处理后的文本进行词元化,得到源语言和目标语言的词元列表
    source, target = tokenize_nmt(text, num_examples)

    # 构建源语言的词表,过滤掉出现次数少于2次的低频词元
    # 并添加特殊词元(<pad>, <bos>, <eos>)
    src_vocab = d2l.Vocab(source, min_freq=2,
                          reserved_tokens=['<pad>', '<bos>', '<eos>'])

    # 构建目标语言的词表,过滤掉出现次数少于2次的低频词元
    # 并添加特殊词元(<pad>, <bos>, <eos>)
    tgt_vocab = d2l.Vocab(target, min_freq=2,
                          reserved_tokens=['<pad>', '<bos>', '<eos>'])

    # 将源语言的词元列表转换为张量,并进行截断或填充
    # src_array: 转换后的张量,形状为 (num_examples, num_steps)
    # src_valid_len: 每个序列的有效长度(不包括填充词元的长度)
    src_array, src_valid_len = build_array_nmt(source, src_vocab, num_steps)

    # 将目标语言的词元列表转换为张量,并进行截断或填充
    # tgt_array: 转换后的张量,形状为 (num_examples, num_steps)
    # tgt_valid_len: 每个序列的有效长度(不包括填充词元的长度)
    tgt_array, tgt_valid_len = build_array_nmt(target, tgt_vocab, num_steps)

    # 将源语言和目标语言的张量及其有效长度打包为一个元组
    data_arrays = (src_array, src_valid_len, tgt_array, tgt_valid_len)

    # 使用d2l提供的load_array函数,将数据打包为数据迭代器
    # data_iter: 数据迭代器,用于按小批量加载数据
    data_iter = d2l.load_array(data_arrays, batch_size)

    # 返回数据迭代器以及源语言和目标语言的词表
    return data_iter, src_vocab, tgt_vocab
下面读出“英语-法语”数据集中的第一个小批量数据。
train_iter, src_vocab, tgt_vocab = load_data_nmt(batch_size=2, num_steps=8)
for X, X_valid_len, Y, Y_valid_len in train_iter:
    print('X:', X.type(torch.int32))
    print('X的有效长度:', X_valid_len)
    print('Y:', Y.type(torch.int32))
    print('Y的有效长度:', Y_valid_len)
    break
小结
- 机器翻译指的是将文本序列从一种语言自动翻译成另一种语言。
- 使用单词级词元化时的词表大小,将明显大于使用字符级词元化时的词表大小。为了缓解这一问题,我们可以将低频词元视为相同的未知词元。
- 通过截断和填充文本序列,可以保证所有的文本序列都具有相同的长度,以便以小批量的方式加载。
以下是将你提供的内容整理为结构清晰、格式良好的 Markdown 版本文档:
问题与回答总结
问题 1:在 load_data_nmt 函数中尝试不同的 num_examples 参数值。这对源语言和目标语言的词表大小有何影响?
回答:
num_examples 参数决定了处理的文本序列对的数量。较小的 num_examples 值会减少处理的文本序列对,从而影响源语言和目标语言的词表大小。
影响分析:
词表大小的变化:
- 词表构建基础:词表的大小取决于处理的文本序列中出现的唯一词元数量。
- 参数影响:
- 如果
num_examples较小,则处理的文本序列对较少,词表中的词元数量也会减少。 - 如果
num_examples较大,则处理的文本序列对较多,词表中的词元数量会更多。
- 如果
相关代码部分:
在 load_data_nmt 函数中,num_examples 参数限制了 tokenize_nmt 函数处理的文本序列对数量。
词表的构建依赖于 source 和 target 中的词元。
实验示例:
假设 num_examples 分别为 100 和 1000:
- 当
num_examples=100时,词表大小可能较小,因为处理的文本序列对较少。 - 当
num_examples=1000时,词表大小会更大,因为处理的文本序列对更多,包含的词元也更多。
结论:
num_examples的值越大,源语言和目标语言的词表大小越大。- 选择合适的
num_examples需要权衡计算效率和模型性能。
问题 2:某些语言(例如中文和日语)的文本没有单词边界指示符(例如空格)。对于这种情况,单词级词元化仍然是个好主意吗?为什么?
回答:
对于中文和日语等没有明确单词边界的语言,单词级词元化可能不是最优选择,但仍然可以使用,具体取决于任务需求和模型设计。
分析:
单词边界的缺失:
- 中文和日语文本通常是连续的字符串,没有空格分隔单词。
- 直接使用空格分割的单词级词元化方法无法正确识别单词边界。
单词级词元化的适用性:
- 如果可以借助分词工具(如
jieba或MeCab),可以对中文或日语文本进行分词,从而实现单词级词元化。 - 这种方式适用于需要捕获更高层次语义的任务。
替代方法:
-
字符级词元化:
- 将每个字符作为一个词元。
- 适用于中文和日语,因为这些语言的字符通常具有独立的语义。
-
子词级词元化:
- 使用 BPE(Byte Pair Encoding)或 WordPiece 等方法。
- 将文本分割为子词单元,适用于多种语言,包括中文和日语。
相关代码部分:
当前代码中,tokenize_nmt 函数使用空格分割单词:
text.split(' ')
对于中文和日语,需要替换为分词工具的输出。
结论:
- 如果可以使用分词工具,单词级词元化仍然是一个好主意,因为它能有效捕获高层次的语义信息。
- 如果无法分词或分词效果较差,可以考虑使用字符级或子词级词元化作为替代方案。

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 24
 0
- 0


 已为社区贡献8条内容

所有评论(0)