登录社区云,与社区用户共同成长
邀请您加入社区
Python 使用googletrans 报错的解决方法
↳使用华为手机的朋友可以打开其自带的“AI字幕”工具,作为实时翻译英/日/韩翻译成中文的音频翻译工具;↳能够识别全球200+种语言的语音内容进行翻译,单击麦克风图标即可进入实时录入音频翻译的使用界面;↳可以一键翻译手头上多个听力英文音频材料的桌面翻译工具,单击“音频翻译”即可进入翻译界面;快根据自己需要使用英文音频翻译工具的状况,选择其中一款工具使用起来吧!
这篇文章主要介绍了一种利用图像描述任务来预训练视觉模型的方法,并将其应用于其他视觉任务。核心思想:将图像描述任务作为预训练任务,训练一个模型来生成图像的文字描述。利用该模型的视觉部分作为基础模型,迁移学习到其他视觉任务,例如图像分类、目标检测、语义分割等。优势:当其他视觉任务缺乏训练数据时,该方法可以有效地提升模型性能。具体细节:视觉任务通常使用卷积神经网络作为其基础模型,...
好学多智能听力机听力熊采用星宸科技SoC芯片-SSD222D,作为保障教育产品使用效果的重要基石,最大程度地发挥其“硬件+软件+服务‘的价值。SSD222D支持嵌入式Linux系统,支持Flythings,LittleVGL,AWTK,TD-UI,QT,mini-GUI等多种GUI图形开发界面工具,还可以支持Free RTOS系统,配合LittleVGL图形界面开发产品
自动翻译android的strings.xml
什么是自然语言生成(NLG)?自然语言处理(NLP)分为自然语言理解(NLU)和自然语言生成(NLG),NLU负责理解文本内容而NLG负责根据信息生成文本内容,该信息可以是语音、视频、图片、文字等等。总共分为两种方式:1、文本到语言生成。2、数据到语言生成。NLG的三个级别(Level)1、简单的数据合并,将数据转换为文本,类似于数据填空。2、模板化的NLG:以模板驱动模式来显示输出,简单来说就是
摘要本文提出了通过词汇链接的使用来提高文档级别机器翻译评估性能的想法。作为一种实现文字连贯的语言手段,词汇衔接通过相同或相关的意思的单词将句子连在一起组成一个有意义的交织结构。机器翻译与人工翻译进行了一场比较来表明他们的关键区别之一是人工翻译往往比机器翻译使用更多的衔接手段。很多方法应用这个特点来评测机器翻译提交的文档,其中包括不依赖于参考译文。实验结果表明,将这一特征与语句级评价指标进行融合
本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-4b-it镜像,实现本地化图文翻译功能。依托平台能力,用户可快速在消费级GPU(如RTX 3060)上一键拉起服务,典型应用于产品说明书、多语言邮件及电商截图等工程文档的离线精准翻译,兼顾隐私安全与响应效率。
本文提供了一种客观有效的方法,可以全面评估大模型的翻译效果。
BLEU 是一个在机器翻译领域极其重要的自动化评估指标。它通过计算机器译文与参考译文在 n-gram 上的修正精确度,并结合简洁惩罚,提供了一个快速、客观、低成本的质量评估手段,特别适用于系统级(语料库级别)的比较和迭代开发。
学习越南语的有效方法涉及多方面的策略,包括对基础字母和发音的掌握,通过媒体和文化产品沉浸在语言环境中,学习并实践日常对话,参与正规课程和使用语言学习应用,与母语者进行语言交换,以及通过阅读和写作来提高语言技能。越南语翻译通app是一个多功能的越南语学习与翻译工具,它集成了文本翻译、语音识别翻译、图片识别翻译、文字转语音、词汇学习、句子学习、阅读和听力训练等功能。此外,它还提供了丰富的学习资源和个性
作为一家积极从事机器翻译+译后编辑的专业本地化机构,Alconost 在本文中将为您介绍机器翻译的来龙去脉,帮助那些想要优化本地化工作流程的组织。以及详细明确机器翻译+人工编辑适合哪些用途。
笛卡尔曾经说过:“语言的分歧是人生最大的不幸之一”。地理分隔导致人类之间存在巴别塔,现在机器翻译和大模型的出现让这座塔变得越来越低~虽然世界上有大约 7000 个在使用中的语言,大约200种语言的用户超过10万,但大多数在线的内容都是以少数的流行语言来提供的,比如英语,这让许多不懂这些语言的人处于不利的地位。虽然现存的许多翻译工具,但语法错误会让错误变得难以阅读和理解。另外,如果你想把内容翻译为一
使用 8×V100 GPU 时,完整训练需约 24 小时。可复用 Hugging Face 的。Transformer 模型凭借自注意力机制在机器翻译中表现优异。预训练模型加速收敛。
扫地机器人作为智能家电代表,集成了传感、定位和路径规划等关键技术,其核心SLAM算法已拓展至无人驾驶等领域。文章从机器人技术起源出发,解析扫地机器人智能导航系统原理,探讨其对生活方式的改变。机器人本质在于模拟人类完成特定任务,形态多样且应用广泛。
机器翻译与数据集
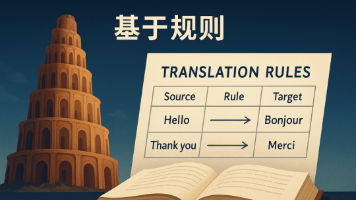
本文介绍了机器翻译的基本概念及其在NLTK中的实现方法。主要内容包括:1)机器翻译的分类(基于规则、统计、神经和混合方法);2)机器翻译的工作流程(源语言分析、转换、目标生成和后处理);3)NLTK在文本处理、词汇对齐和评估等环节的应用;4)统计机器翻译的核心组件。通过代码示例展示了基于词典的简单翻译、IBM Model 1词汇对齐以及基于短语的翻译实现。文章为使用NLTK构建基础机器翻译系统提供
本文介绍了如何在星图GPU平台上自动化部署Hunyuan-MT-7B-WEBUI镜像,快速构建多语言翻译服务。该镜像专为轻量高效落地设计,支持维吾尔语、藏语等38种语言互译,典型应用于电商商品标题翻译、政务文档本地化及民汉实时校对等场景,显著降低部署门槛与响应延迟。
本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-12b-it镜像,实现本地化图文混合翻译。该轻量级模型支持55种语言互译,可直接识别并翻译图片中的英文文本,适用于技术文档、说明书、网页截图等场景,兼顾隐私性与响应速度。
作为一名在迪拜远程为欧美公司打工的程序员,我每天要面对英文技术文档、阿拉伯语客户需求、Zoom站会、GitHub Issue、Discord社区……没有一套强悍的实时翻译软件组合,根本活不过三天。过去90天,我用科学方法实测了42款实时翻译软件/插件/硬件,最终整理出这份2025年最硬核的《程序员出海实时翻译软件深度横评》。
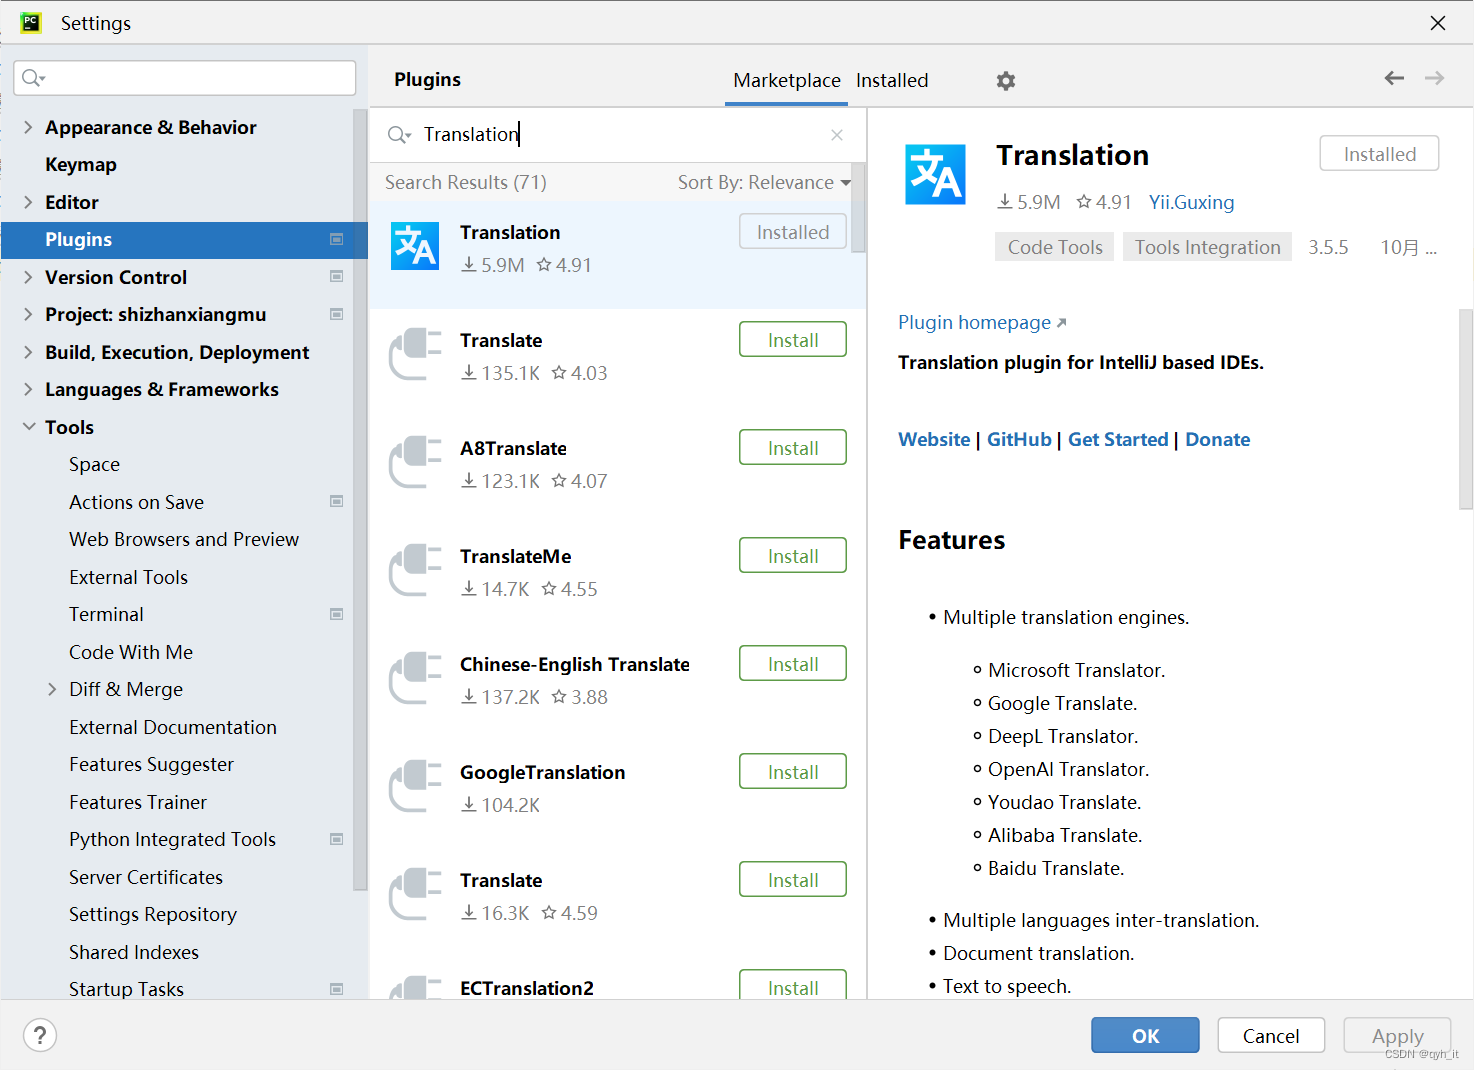
(1)选中要翻译的文本,右键点击,选择 “Translate” > “Translate Text”,即可翻译成功。(2)打开 “File” > “Settings”,在 “Tools” 下找到 “Translation”。(1)打开 PyCharm,点击菜单栏的 “File” > “Settings”。(3)在 “Marketplace” 标签中,搜索 “Translation”。(3)在 “T
机器翻译小结 机器翻译主要是通过计算机将一种语言翻译到其他语言,也就是最基本的序列到序列的问题。传统的机器翻译主要是基于统计的机器翻译,一般能够在精确度上做的比较好,但是在译文流畅度上有很大的不足,往往是只是翻译出对应单词的意思而缺少句子的整体信息。近几年,出现了基于神经网络的机器翻译,在译文流畅度和精确度上均有较好的表现。目前,主流的神经网络翻译架构有 CNN(facebook)..
本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-12b-it镜像,构建本地化、隐私安全的AI翻译系统。该镜像支持图文双模态输入,可直接对英文产品说明书、技术文档截图等图片进行高精度OCR识别与专业术语翻译,适用于开发者、产品经理及科研人员的日常跨语言工作场景。
文章目录前言基于词重叠率的方法机器翻译 & 摘要 常用指标BLEUROUGENISTMETEORTERdata to text 常用指标relation generation (RG)content selection (CS)content ordering (CO)如何实现上述的评价指标CoverageDistinctimage caption 常用指标CIDEr好处SPIC
来自北京大学和字节跳动的研究团队,提出了一种名为"Visual AutoRegressive (VAR) Modeling"的全新视觉生成范式。VAR 重新定义了图像的自回归学习过程,从而使得GPT风格的自回归模型首次超越扩散模型,在图像生成质量、速度和可扩展性等多方面都取得了突破性进展。Huggingface模型下载:AI快站模型免费加速下载:VAR核心思想:模仿人类视觉认知VAR的核心思想源于
实现类,构建基于Transformer的编码器和解码器。# 从torch.nn模块导入Transformer相关的类# 定义Seq2SeqTransformer类# 初始化父类nn.Module# 创建Transformer编码器层# 创建Transformer编码器,传入编码器层和层数# 创建Transformer解码器层# 创建Transformer解码器,传入解码器层和层数# 创建一个线性层
随着AI开源项目DeepSeek团队的重大突破,人工智能领域迎来了新的技术飞跃。DeepSeek是一个结合了自然语言处理、图像识别和大数据分析的智能搜索引擎。它的创新之处在于通过深度学习技术,能够提供更为精准和个性化的搜索体验。由于deepseek这段时间过于火爆,导致官网模型回复问题的速度十分缓慢,而本地部署deepseek模型可以很好的解决这个问题,下面是我最近的使用经验,希望能够帮助到你!对
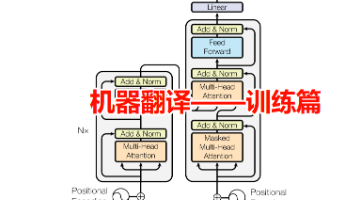
还在为机器翻译模型从理论到落地卡壳?系列博客第三弹——模型训练篇强势登场,手把手带你走完Transformer中日翻译项目的最后关键一步!前两期我们搞定了数据预处理(分词、词表构建全流程)和模型搭建(词嵌入、位置编码、编码器解码器核心结构),而这一篇,将聚焦让模型“学会翻译”的核心秘籍:如何设计损失函数,让模型精准捕捉中日语言差异?优化器参数怎么调,才能让训练更稳定、收敛更快?从数据到模型,再到训
本文介绍了如何在星图GPU平台上自动化部署【ollama】translategemma-12b-it镜像,赋能跨语言知识图谱构建。该轻量级多语言翻译模型支持图文联合理解,可精准抽取中英日等多语种文档中的实体、关系及结构化信息,显著提升知识建模效率与数据隐私安全性。
本文介绍了如何在星图GPU平台上自动化部署HY-MT1.5-7B镜像,构建基于vLLM的高效翻译服务。通过该平台,用户可快速启用支持多语种、上下文感知及术语干预的专业级翻译模型,适用于文档翻译、跨境交流等实际场景,显著提升翻译准确性与效率。
1.背景介绍自然语言处理(Natural Language Processing,NLP)是人工智能(Artificial Intelligence,AI)的一个分支,它旨在让计算机理解、生成和处理人类语言。自然语言是人类的主要交流方式,因此,自然语言处理在人工智能领域具有重要意义。自然语言处理的主要任务包括文本分析、情感分析、语义分析、命名实体识别、语言翻译、语音识别等。这些任务涉及到计...
本项目采用深度学习方法,具体使用架构实现英文到中文的机器翻译任务。是一种基于自注意力机制的序列到序列(Seq2Seq)模型,专为高效处理长距离依赖和并行计算设计。其核心思想是通过多头注意力替代传统循环或卷积结构,实现全局上下文建模。主要由编码器(Encoder)和解码器(Decoder)组成,采用完全基于注意力机制的结构,摒弃了传统的循环神经网络。
7-2 词典 (15分)你刚从滑铁卢搬到了一个大城市,这里的人们讲一种难以理解的外语方言。幸运的是,你有一本字典来帮助你理解它们。输入格式:输入第一行是正整数N和M,后面是N行字典条目(最多10000条),然后是M行要翻译的外语单词(最多10000个)。每一个字典条目都包含一个英语单词,后面跟着一个空格和一个外语单词。 输入中的每个单词都由最多10个小写字母组成。输出格式:输出翻译后的英文单词,每
FLUX.1是由某机构开发的新型开源图像生成模型,现已在某平台上线,只需一行代码即可在云端运行。
提供了本节使用代码(1)对比RNN:①对于卷积神经网络来说,受限于长文本。如果要对长距离依赖进行描述,需要多层卷积操作,而且不同层之间信息传递也可能有损失,这些都限制了模型的能力。②对于循环神经网络来说,随着序列长度的增加,编码在隐藏状态中的序列早期的上下文信息被逐渐遗忘。尽管注意力机制的引入在一定程度上缓解了这个问题,但循环网络在编码效率方面仍存在很大的不足之处。(2)引入Transformer
基于seq2seq的机器翻译系统
基于循环或卷积神经网络的序列到序列建模方法是现存机器翻译任务中的经典方法。然而,它们在建模文本长程依赖方面都存在一定的局限性。对于卷积神经网络来说,受限的上下文窗口在建模长文本方面天然地存在不足。如果要对长距离依赖进行描述,需要多层卷积操作,而且不同层之间信息传递也可能有损失,这些都限制了模型的能力。而对于循环神经网络来说,上下文的语义依赖是通过维护循环单元中的隐状态实现的。在编码过程中,每一个时
RMSNorm:给数据 “定规矩”,让模型训练更稳定,计算更快;SwiGLU:带 “智能开关”,让模型更灵活地抓重点,学习复杂语言模式;RoPE:用 “旋转魔法” 给词加位置标签,让模型更懂词的顺序和相对关系。看例子(数据处理):把文本拆成字符,建立字符和数字的对应。练基础(模型搭建):用 Transformer 和 LLaMA 的核心技术,让模型能理解字符的关系和位置。反复练(训练):通过预测下
本文讨论了大型语言模型(LLM)的微调,这是一种通过少量数据训练已经预训练好的模型以执行特定任务的过程。微调可以让LLM在翻译、文本分类、文本生成等领域更加高效。本文还提供了微调的实践示例和代码,帮助读者理解并应用微调过程。
人工智能技术对比表
在自然语言处理领域,机器翻译是一个具有挑战性的任务,涉及将一种语言的文本翻译成另一种语言,同时保持语义和语法的准确性。TER衡量了模型生成的翻译与参考翻译之间的编辑距离,即通过删除、插入、替换等操作将一个翻译转换为另一个的最小编辑次数。在这个例子中,模型生成的翻译中有一些词汇次序不同,降低了BLEU分数。BLEU是一种常用的机器翻译评估指标,通过比较生成的翻译和参考翻译之间的匹配程度来计算分数。C
【预训练语言模型】MT-DNN: Multi-Task Deep Neural Networks for Natural Language Understanding 预训练语言模型在下游任务微调时如果可以获得更丰富的训练任务,则提高让预训练语言模型的泛化能力,本文则通过添加多任务训练实现泛化性能的提升。核心要点包括:将NLP划分为四种类型的任务;在BERT预训练的基础上,添加若干多任务的参数,