登录社区云,与社区用户共同成长
邀请您加入社区
4A架构是指在AI系统开发过程中需要考虑的四个关键架构层面:业务架构(BA)、应用架构(AA)、技术架构(TA) 和 数据架构(DA)。这四个架构层相互关联,确保AI系统的功能、性能和可扩展性能够满足业务需求,并支持持续的创新与发展。业务架构(BA):从业务角度出发,描述AI系统如何通过其核心功能、流程、组织结构等来实现企业的战略目标。应用架构(AA):定义了支持AI系统功能的应用程序及其之间的关
大型语言模型(LMs)虽然能够执行多种自然语言处理(NLP)任务,但它们并不总是能够很好地遵循用户的意图。例如,它们可能会产生不真实、有偏见、有毒或者简单地不遵循用户指令的输出。这是因为大型LMs的训练目标——预测互联网网页上的下一个词——与“有帮助且安全地遵循用户指令”的目标不同。因此,我们说这些模型与用户的目标不一致。对于部署在数百个应用中的语言模型来说,避免这些意外行为尤为重要。1. 与GP
这是关于大模型的DPO方法的论文,尝试使用腾讯元宝进行快速阅读!
写代码的能力上看,文心一言3.5的能力已经很强了,能够和GPT-4各有千秋。我这里只贴出了GPT-4的实现,文心一言3.5的代码实现也是类似的,只是会提示JDK没有实现SHA-3-256,需要引入第三方库。但是生成的单元测试用例明显好于GPT-4,对于边界条件验证的更加充分。足够用了,关键文心一言3.5还免费。
Transformers是一种神经网络架构,广泛应用于自然语言处理NLP任务,如翻译、文本分类和问答系统。它们是在 2017 年发表的开创性论文 "Attention Is All You Need "中引入的。将Transformers想象成一个复杂的语言模型,通过将文本分解成更小的片段并分析它们之间的关系来处理文本。然后,该模型可以对各种查询生成连贯流畅的回复。
Agent 是一个自主单元,通过编程可以执行任务、做出决策并与环境通信。同样,基于 LLM 的 Agent 是一个高级单元,它将 LLM 作为大脑来进行思考、做出决策并采取行动完成特定任务。这些 Agent 还可以拥有记忆,可以是短期记忆( Agent 的思路),也可以是长期记忆(对话历史)。它们还可以使用工具来执行任务,如上网搜索、使用计算器等。让我们看看下面的示例–如果用户的天气条件不理想(如
BN批量归一化:以进行学习时的mini-batch为单位,按mini-batch进行正规化。具体而言,就是进行使数据分布的均值为0、方差为1的正规化。LN层归一化是对每个batch(3维)里的每个样本的每行进行标准化,使用layer norm 对应到NLP里就是相当于对每个词向量各自进行标准化总结:BN是对一个中间层的单个神经元进行归一化操作,LN是对一个中间层的所有神经元进行归一化。
作者:禅与计算机程序设计艺术自动化运维的最佳实践:如何高效地实现运维自动化引言1.1. 背景介绍随着互联网业务的快速发展,运维工作变得越来越重要。传统的运维方式已经难以满足高效、自动化的需求。
截止至本月,我从前端研发转岗为产品经理已经一年左右了,这篇文章就讲讲我这一年中的一些经验和总结。希望能为同样身为前端也有想法转产品的你提供一点帮助。
作者:禅与计算机程序设计艺术《基于Apache NiFi的分布式流处理与传输平台》技术博客文章引言1.1. 背景介绍随着互联网的高速发展,分布式流处理与传输平台成为了大数据
与T5不同,LLaMA(Large Language Model Meta AI)是Meta AI发布的一系列大型语言模型,专注于提高较小模型的性能,而。、130亿或700亿参数的版本,旨在使小型组织也能部署这些模型,而无需昂贵的计算时间或基础架构投资 4。T5 架构的这些特点使其成为一个灵活、强大的 NLP 模型,能够高效处理各种文本任务,并在多个基准测试中取得了优异的成绩。T5和LLaMA的主
qwenvl 模型理解:参考资料:论文:最近正好在做qwenvl 总结记录一下qwenvl 以及qwenvl2模型的架构,本文主要聚焦模型架构和训练技术,其他内容后面有涉及再补由于我主要关注模型架构,因此读论文的时候读完摘要直接看model architecture。
24年1月论文“Agent AI: surveying the horizons of multimodal interaction“,来自斯坦福、微软、UCLA和华盛顿大学。
校招如何成为大厂算法工程师,楼主是双非同学,所以我想我更能够和大多数的普通同学有相同经历和感受,能够和大家有更强的共鸣。
GPT可以实现更快速、更精准的问题解答。借助其先进的语音识别与对话技术,GPT可以与用户进行准确理解与交流,并快速给出相应答案或建议。这让用户得到了更加专业化、个性化的服务支持,也提升了品牌形象。对于舆情监测而言,GPT可以帮助企业在海量信息中迅速捕捉到关键信息,并做出相应的反应。1、人们如何使用 ChatGPT?该模型除了可以回答简单的问题外,还有很多功能。ChatGPT 可以撰写论文、详细描述
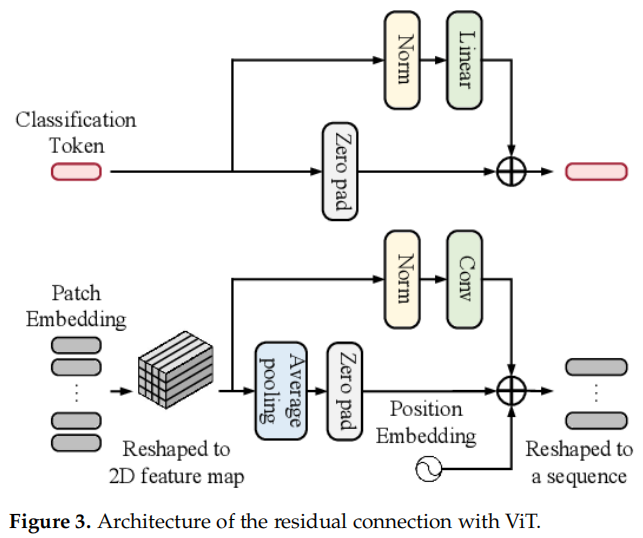
在2024年,深度学习领域的研究者们在追求论文发表和模型性能提升时,不妨关注一下结合了ResNet和Transformer的创新架构——EfficientRMT-Net。这一模型将Transformer的全局信息处理能力与ResNet-50的深度残差结构相结合,实现了99.12%的惊人准确率。这种融合之所以有效,是因为它能够充分发挥两种架构的优势:ResNet的深度残差结构有助于网络深入学习复杂特
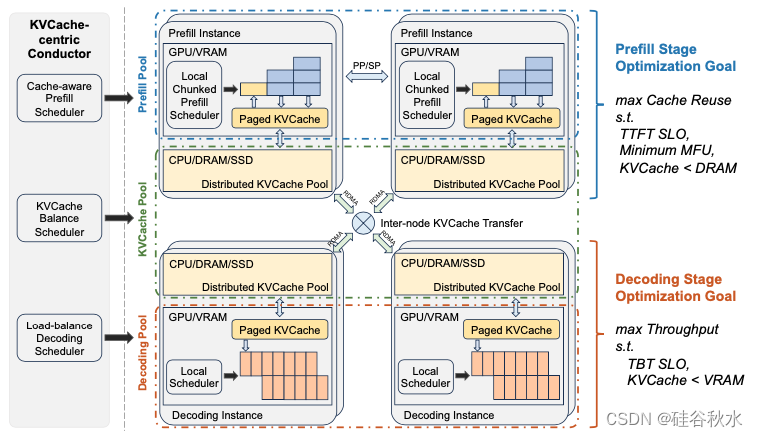
24年6月AI公司月之暗面的技术报告“Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving”。
在大型语言模型(LLM)的实际部署与应用中,推理性能调优是决定技术落地成败的核心环节。随着模型规模指数级增长,如何在延迟(Latency)与吞吐量(Throughput)之间实现最佳平衡,成为开发者面临的关键挑战。
我这里用的是算力云 选择的是两张4090 扩容是50G进入终端输入命令切换文件 cd autodl-tmpcurl -s https://packagecloud.io/install/repositories/github/git-lfs/script.deb.sh sudo apt-get update sudo apt-get install git-lfs1.pip install "tr
这是因为在国内大部分区域不能访问 huggingface.co 网站,解决办法如下。
GLM-4-9B是智谱AI在24年6月5日推出的开源预训练模型,属于GLM-4系列。之前已开源chatglm1~chatglm3等多个版本。GLM4在语义理解、数学、推理、编程和知识等领域的测试中表现优异。GLM-4-9B-Chat是其人类偏好对齐版本,支持多轮对话、网页浏览、代码执行、自定义工具调用(function call)以及长文本推理(最大128K上下文)。该系列模型还支持26种语言,包
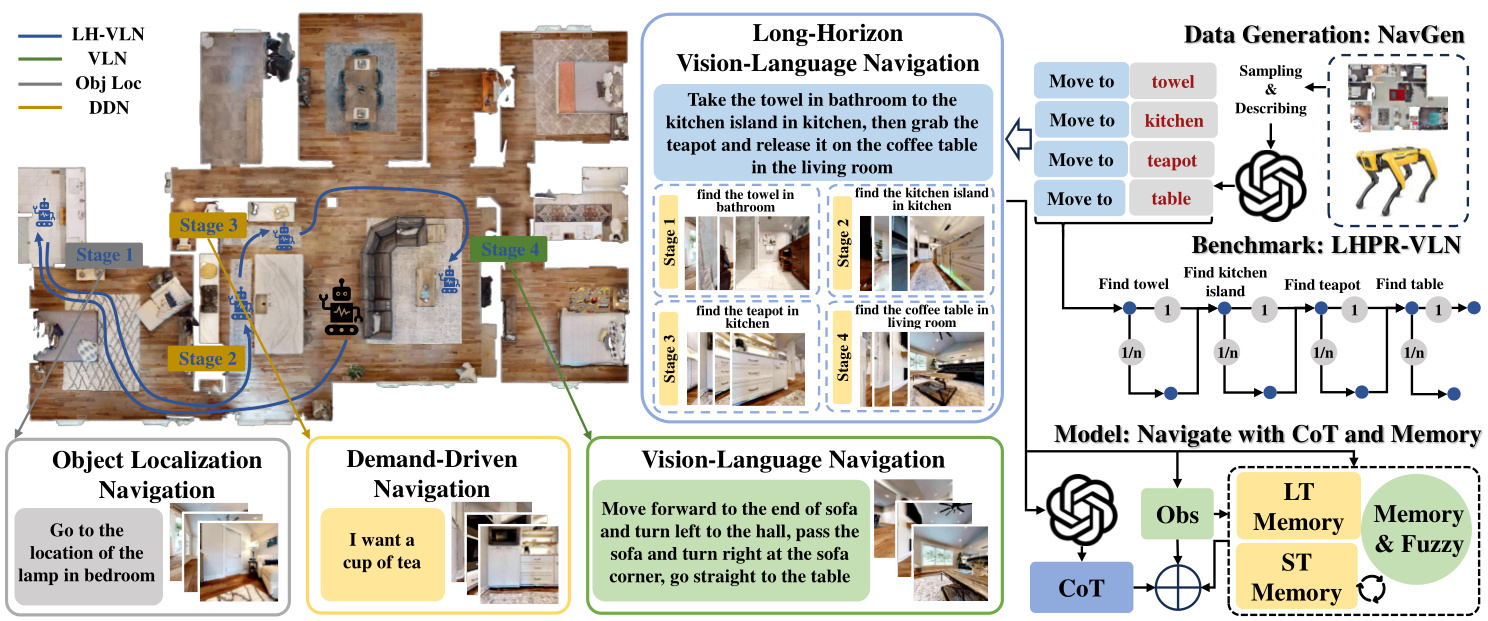
(a) 机器人分布。(b) 任务长度分布。© 任务指令和步骤长度的分布。我们将 2、3、4 个子任务分别视为短任务、中任务和长任务。
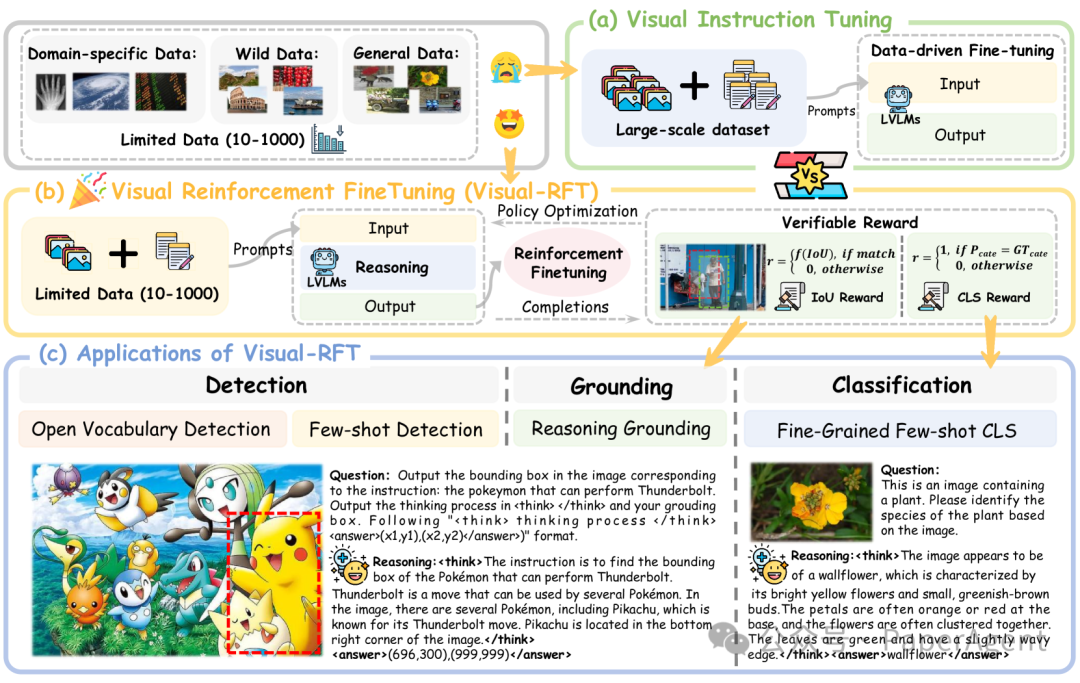
与(a)数据驱动的视觉指令微调相比,(b)视觉强化微调(Visual-RFT)在有限数据下更具数据效率。(c)成功地将RFT应用于一系列多模态任务,并在底部展示了模型的推理过程示例。
Moondream:智能解读图像信息,让视觉叙事如影随形,畅所欲言无极限! - 精选真开源,释放新价值。
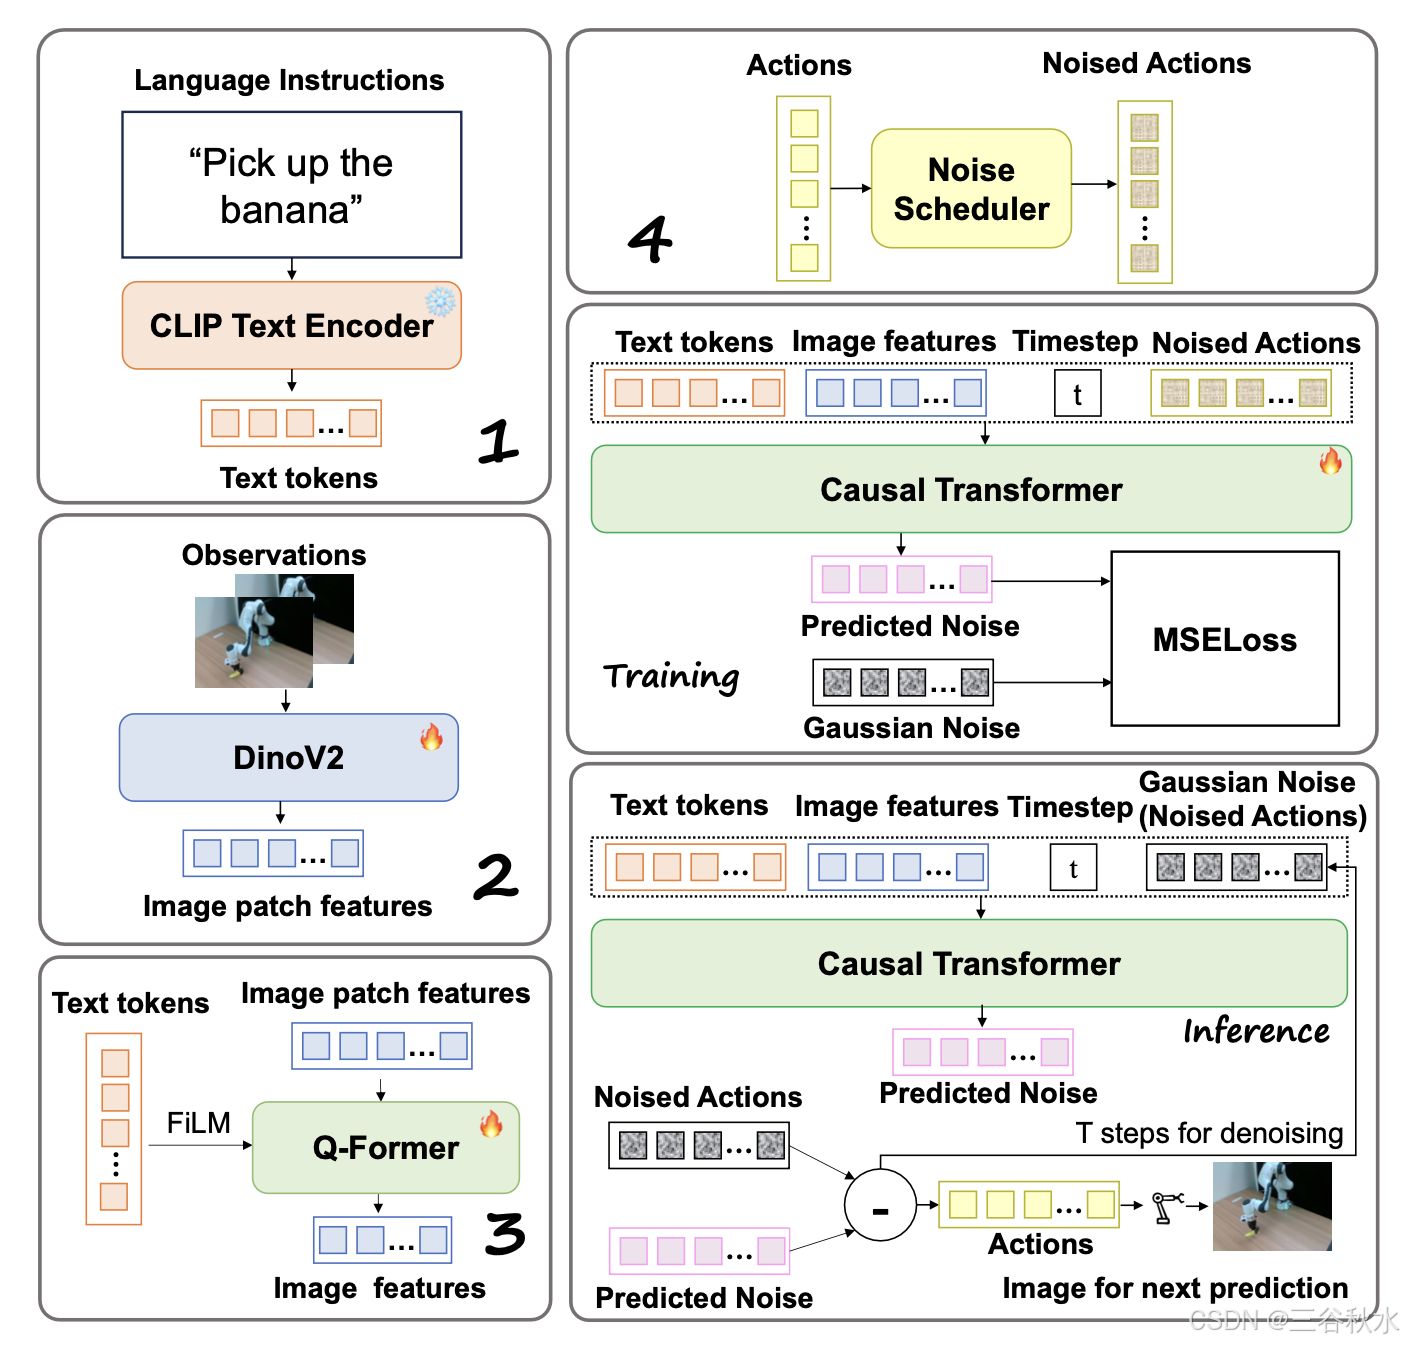
25年2月来自上海AI实验室、浙大、香港中文大学、北大、商汤科技、清华和中科院香港科学创新研究院的论文“Diffusion Transformer Policy: Scaling Diffusion Transformer for Generalist Vision-Language-Action Learning”。最近,在多样化的机器人数据集上进行预训练的大型视觉-语言-动作模型,已展示出利用
Llama-3.1-Nemotron-Nano-VL-8B-V1
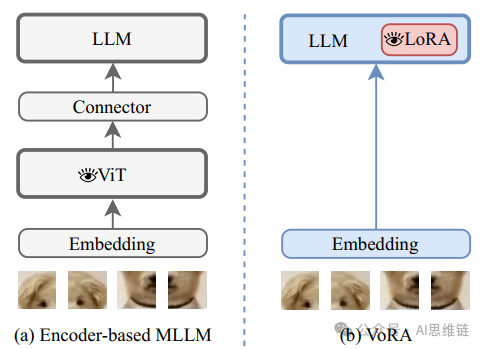
如何将视觉理解能力有效集成到大语言模型(LLM)中,以克服传统多模态模型的缺陷?论文提出了一种新的方法"Vision as LoRA"(VoRA),通过低秩适应(LoRA)将视觉能力直接嵌入LLM中,避免了外部视觉模型的依赖,同时保持了语言知识的完整性。
每个神经元都接收前一层所有神经元的输出(经过加权和激活函数处理),并产生自己的输出。
与此同时,许多匿名的病理图像在互联网上被分享,特别是在社交媒体上,在这些平台上,临床医生与同事们讨论匿名的医学图像。图2b)的图像嵌入向量上训练了一个简单的线性分类器(图3e),并将其与两个基线模型进行了比较:原始CLIP模型的图像编码器和深度神经网络的多任务预训练(MuDiPath)。作者使用这32个标签从2006年3月21日(第一条Twitter帖子的日期)到2022年11月15日检索相关的推
计算机视觉是人工智能的一个重要分支,其目标是使机器具备类似于人类视觉的能力,使用计算机模仿人类视觉系统的科学,让计算机拥有类似人类提取、处理、理解和分析图像以及图像序列的能力。计算机视觉系统的主要功能有图像获取、预处理、特征提取、检测/分割和高级处理,这一领域涵盖了图像识别、目标检测、图像生成等多个方面,已经在各行各业取得了显著的成果。人工智能是一门涵盖多个领域的科学,它旨在使计算机能够模拟人类智
大型视频语言模型(LVLM)的最新进展推动了旨在评估基于视频任务的认知能力的基准的发展。然而,大多数现有的基准严重依赖于网络收集的视频与人类注释或模型生成的问题,这限制了对视频内容的控制,并且在评估涉及符号元素和抽象概念的高级认知能力方面存在不足。为了解决这些限制,我们引入VCBench,一个可控的基准来评估LVLM的认知能力,涉及不同难度水平的符号和抽象概念。通过使用基于Python的引擎生成视
本文总结了VALSE 2024的Tutorial报告《开放词汇视觉感知》的精彩内容,方便读者学习。
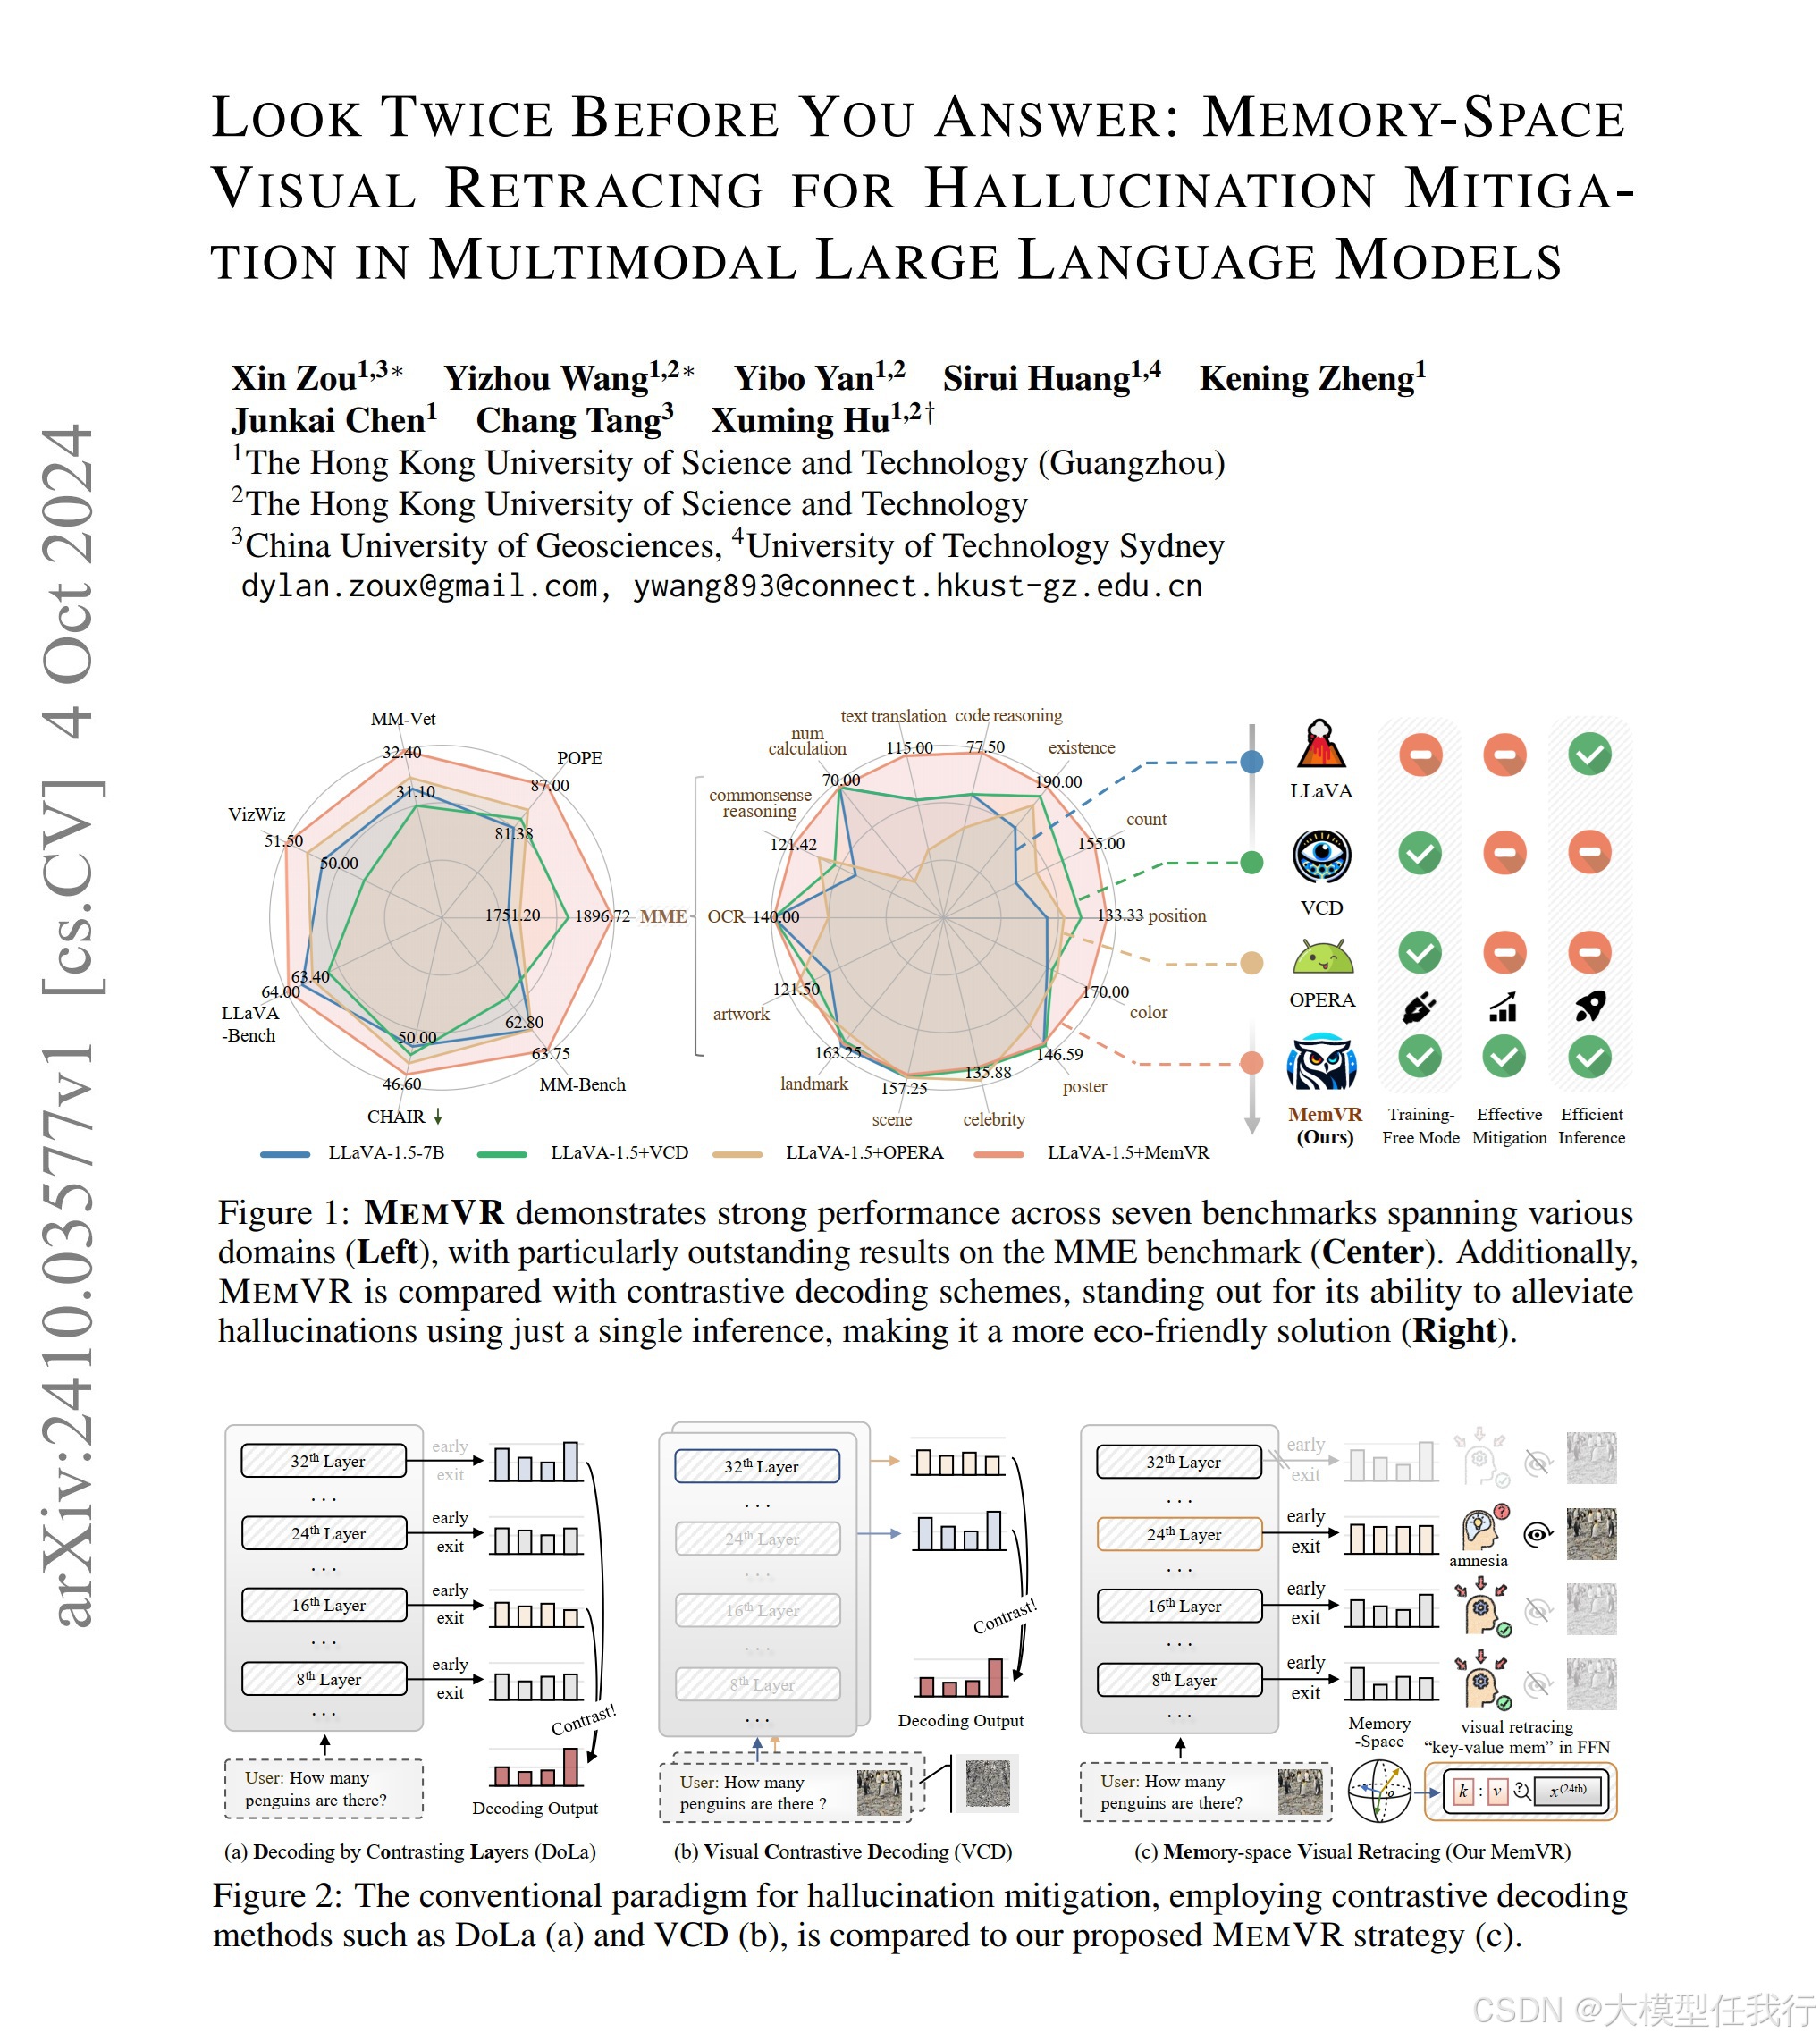
多模态大型语言模型(MLLM)中,因视觉输入与模型内部表示不充分对齐而导致的“幻觉”现象。论文提出了一种新的训练无关的幻觉缓解范式MEMVR,通过补充视觉线索来改善模型的回答准确性。
Google Veo3终结AI"哑剧时代",开启商业视觉叙事新纪元 摘要:Google Veo3作为首个原生生成人物对话的视频模型,实现了三大技术突破:语音-唇形-表情实时协同生成、上下文感知对话引擎和跨语种情感保留技术,彻底解决了传统AI视频"有画面无声音"的瓶颈。在跨国企业培训、智能客服和产品演示等商业场景中,Veo3可降低60%成本,提升3倍效率,同时
利用针对特定任务的预训练模型和自定义 Prompt 进行情境学习在自然语言处理任务中取得了显著的成功。在此基础上,最近的研究将类似的方法应用于"一次性"框架中的Segment Anything Model(SAM),其中只使用一张参考图像及其标签。然而,这些方法在医学领域面临局限性,主要原因在于SAM对视觉 Prompt 的基本需求和生成过程中对像素相似度的过度依赖。这种依赖可能导致(1)不准确的
如何构建一个统一的音频基础模型,同时处理音频理解、生成和对话等多种音频处理任务?Kimi-Audio作为一个开源的音频基础模型,实现了在多个音频处理任务上达到最先进的性能,并提供了可重复的评估工具包。
大家好,我是开源项目解析小编,每天分享GitHub上的好项目主要分享GitHub上有趣、有意义、重要的项目一个用于医疗领域的问答数据集源代码:Chinese-medical-dialogue-data是一个专门为医疗领域的自然语言处理研究提供丰富资源的数据集。这个数据集包含了医生和患者之间的对话,总共有1百万个对话和4百万个话语。这些对话数据都是用中文进行的,涵盖了多种医疗场景和话题。该数据集的主
【摘要】本文提出了一种创新的视频挖掘方法,通过将图像描述数据集中的文本转移到相似视频片段,构建出千万级规模的VideoCC3M数据集(1030万视频-描述对),解决了视频音频领域标注数据匮乏的难题。该方法采用双流模型架构,在文本-视频检索、音频检索和视频描述三大任务上取得突破性表现:在MSR-VTT数据集上检索性能超越HowTo100M预训练模型,AudioCaps音频检索达到SOTA,视频描述任
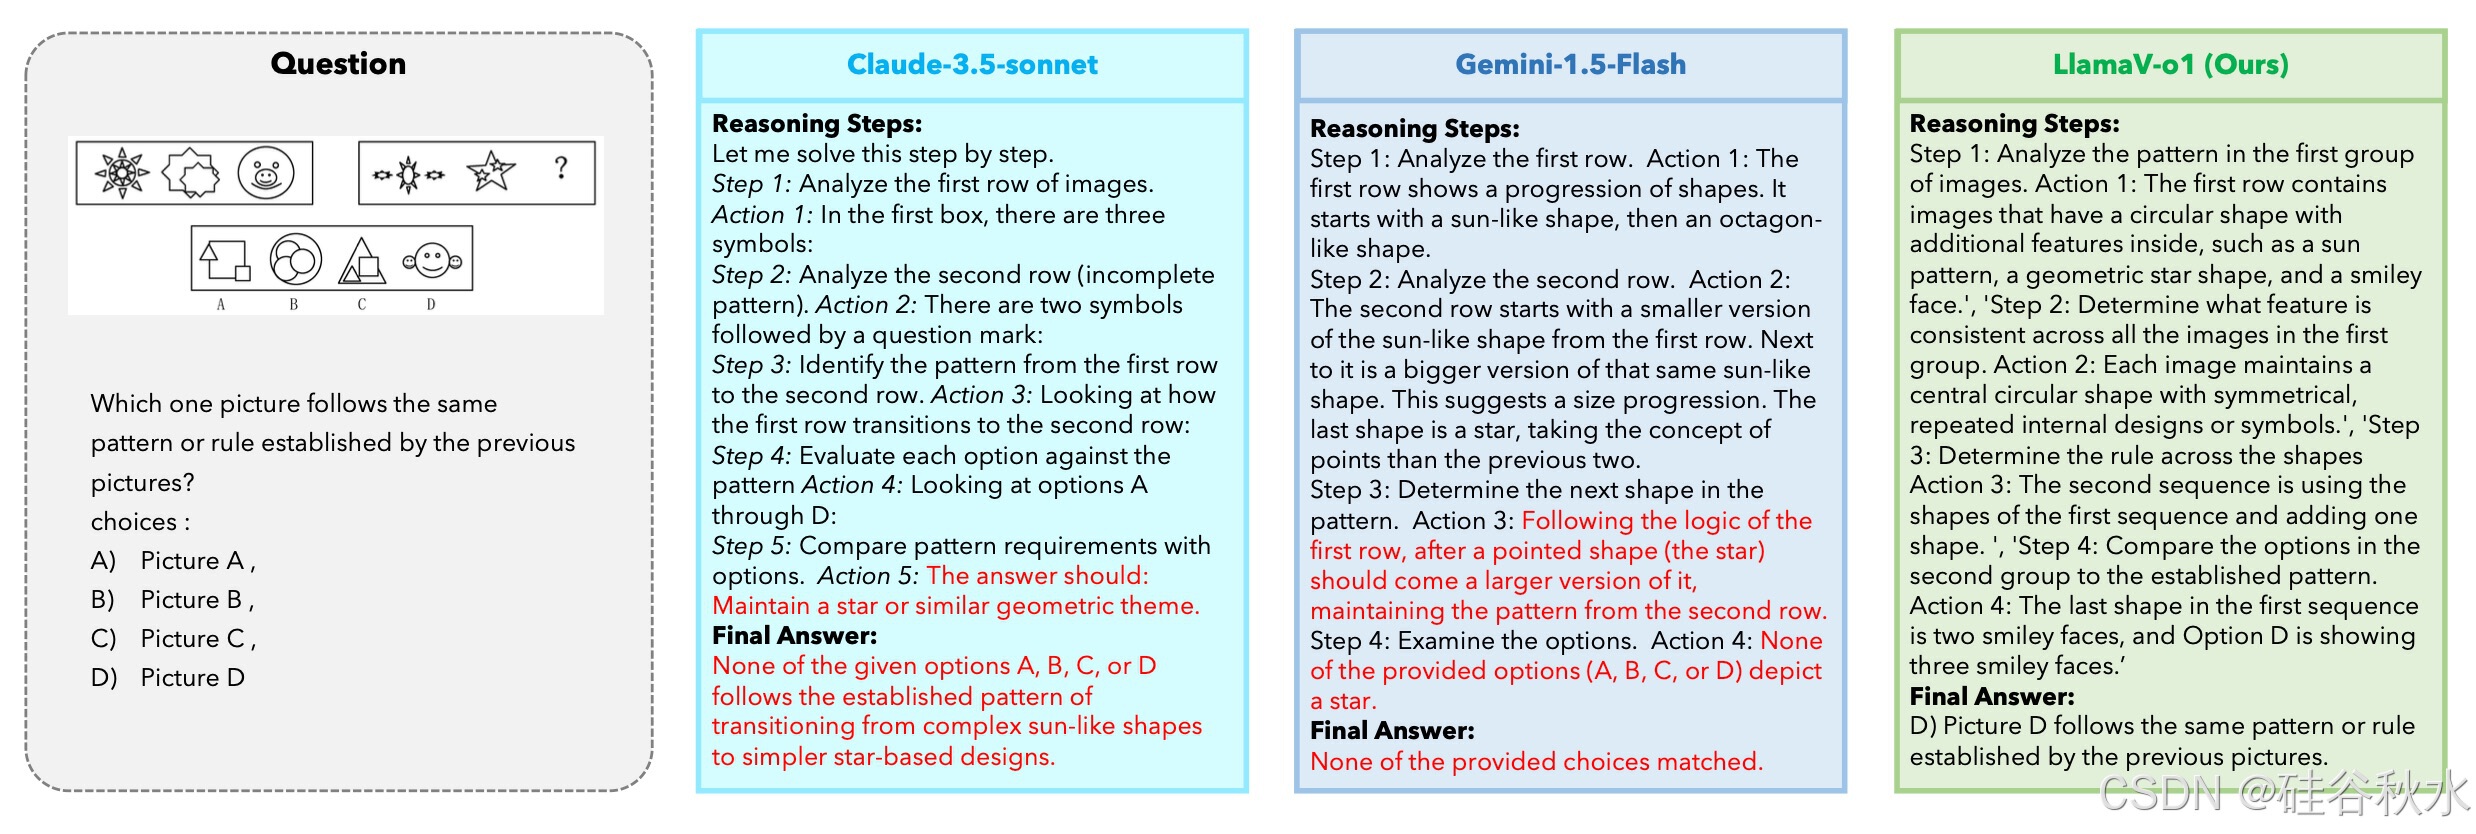
25年1月来自 MBZUAI、U Central Florida、Linkoping 大学和澳大利亚 ANU 的论文“LlamaV-o1: Rethinking Step-by-step Visual Reasoning in LLMs”。推理是解决复杂多步问题的基本能力,特别是在需要按顺序逐步理解的视觉环境中。现有方法缺乏评估视觉推理的综合框架,也不强调逐步解决问题。为此提出一个全面的框架,推进
Llama3 的横空出世震惊了世界,它在几乎所有基准测试中都超越了 GPT-3.5,并在一些方面超越了 GPT-4。随后,GPT-4o 的出现凭借其多模态能力再次夺回了王座。今天,我们发布了一个改变现状的产品:Llama3-V,这是首个基于 Llama3 构建的多模态模型。而且,我们在不到 500 美元的成本下完成了整个训练。你问基准测试怎么样?让数据来说话吧。我们的性能比当前最先进且最受欢迎的多
多模态大语言模型(MLLMs)通过模块化设计将预训练视觉模型与大语言模型(LLMs)集成,取得了显著进展:如图1(a)所示,视觉编码器提取的视觉特征通过连接器与大语言模型对齐。虽然这种方法在训练中效率较高,但由于依赖外部视觉专家模型,存在关键局限性,即额外的计算成本和图像分辨率限制。例如,许多视觉编码器,特别是视觉变换器(ViTs),遵循固定分辨率的训练范式,限制了灵活性。此外,模块化设计采用顺序
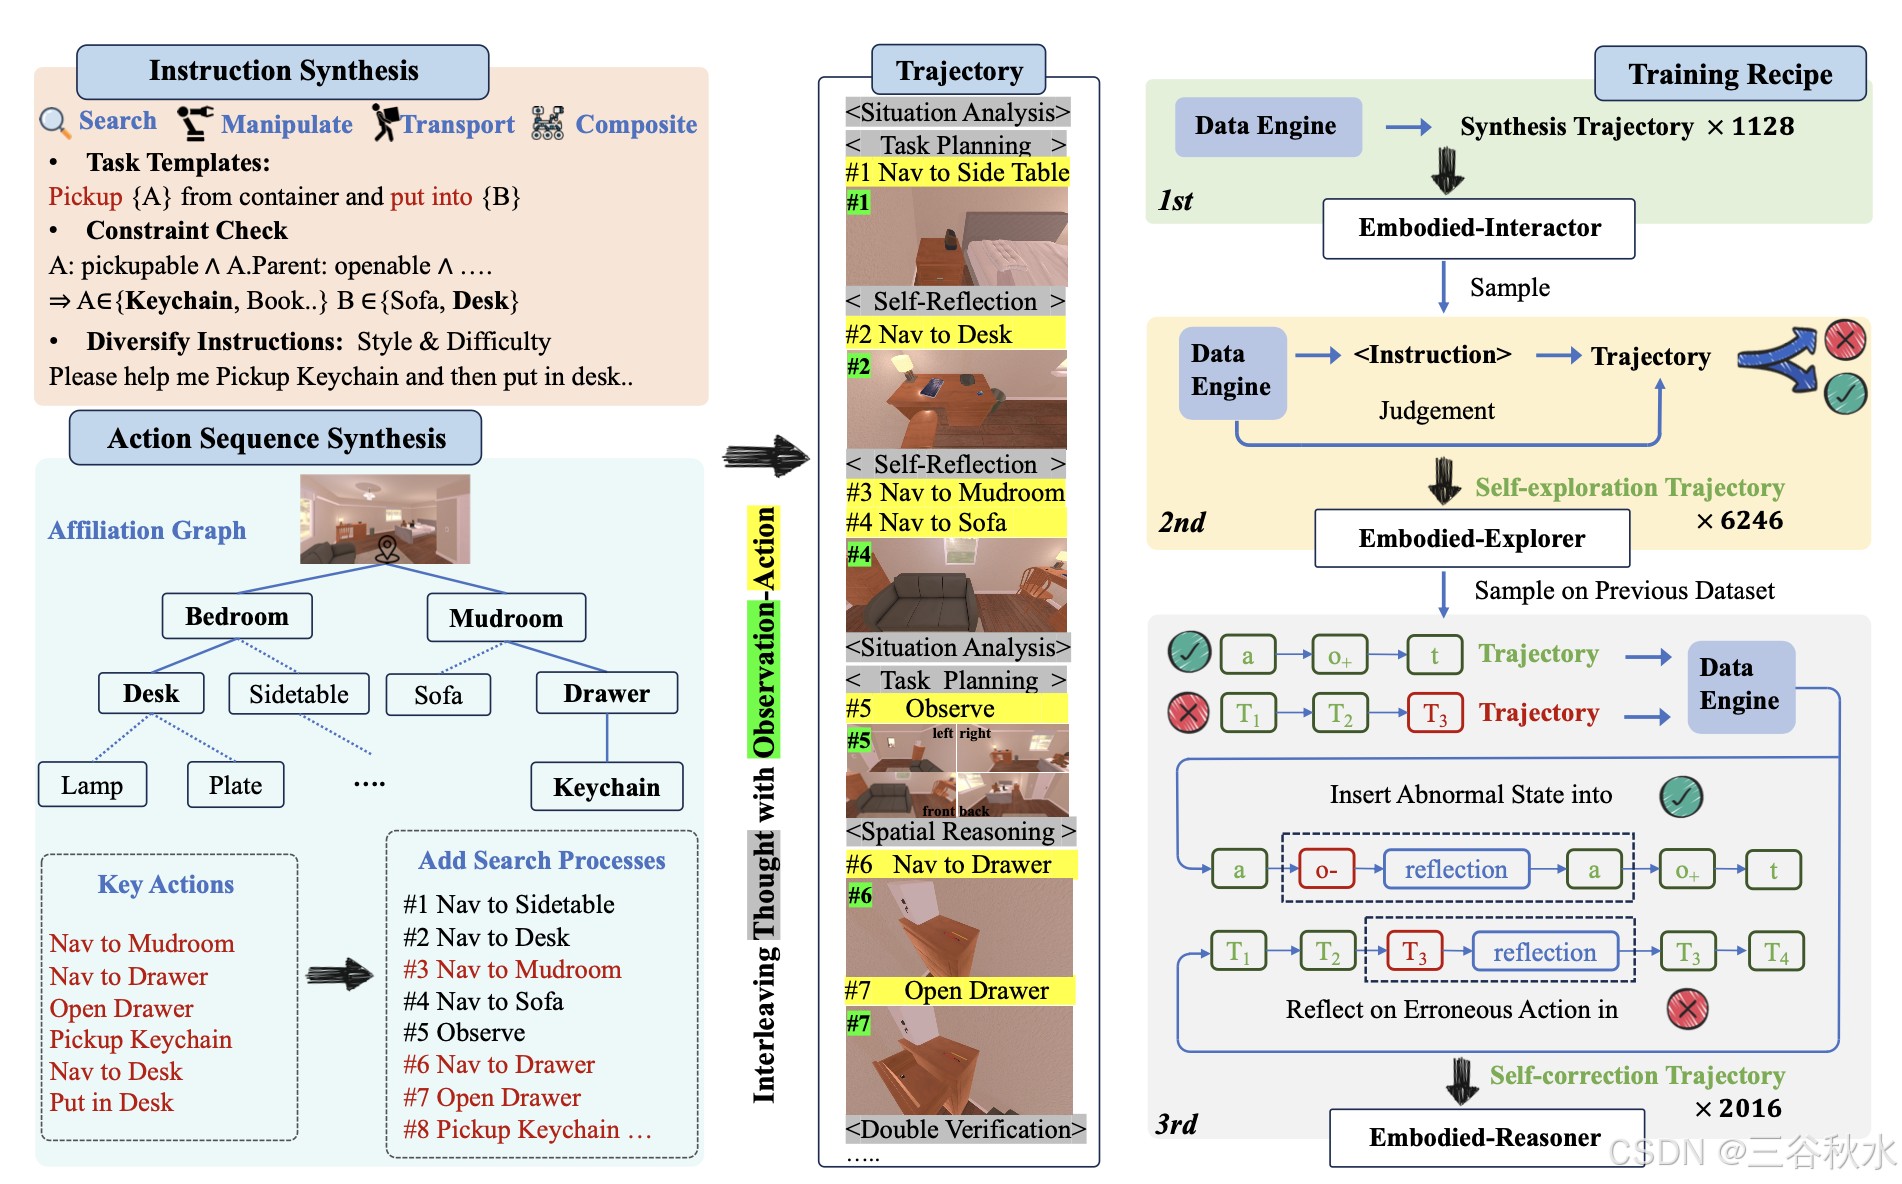
25年3月来自浙大、中科院软件所、中科院大学、阿里达摩院、南京软件所、南邮和河海大学的论文“Embodied-Reasoner: Synergizing Visual Search, Reasoning, and Action for Embodied Interactive Tasks”。深度思维模型的最新进展,已在数学和编码任务上展现出卓越的推理能力。然而,它们在需要通过图像动作交错轨迹与环境