HKUST:补充视觉信息缓解多模态幻觉
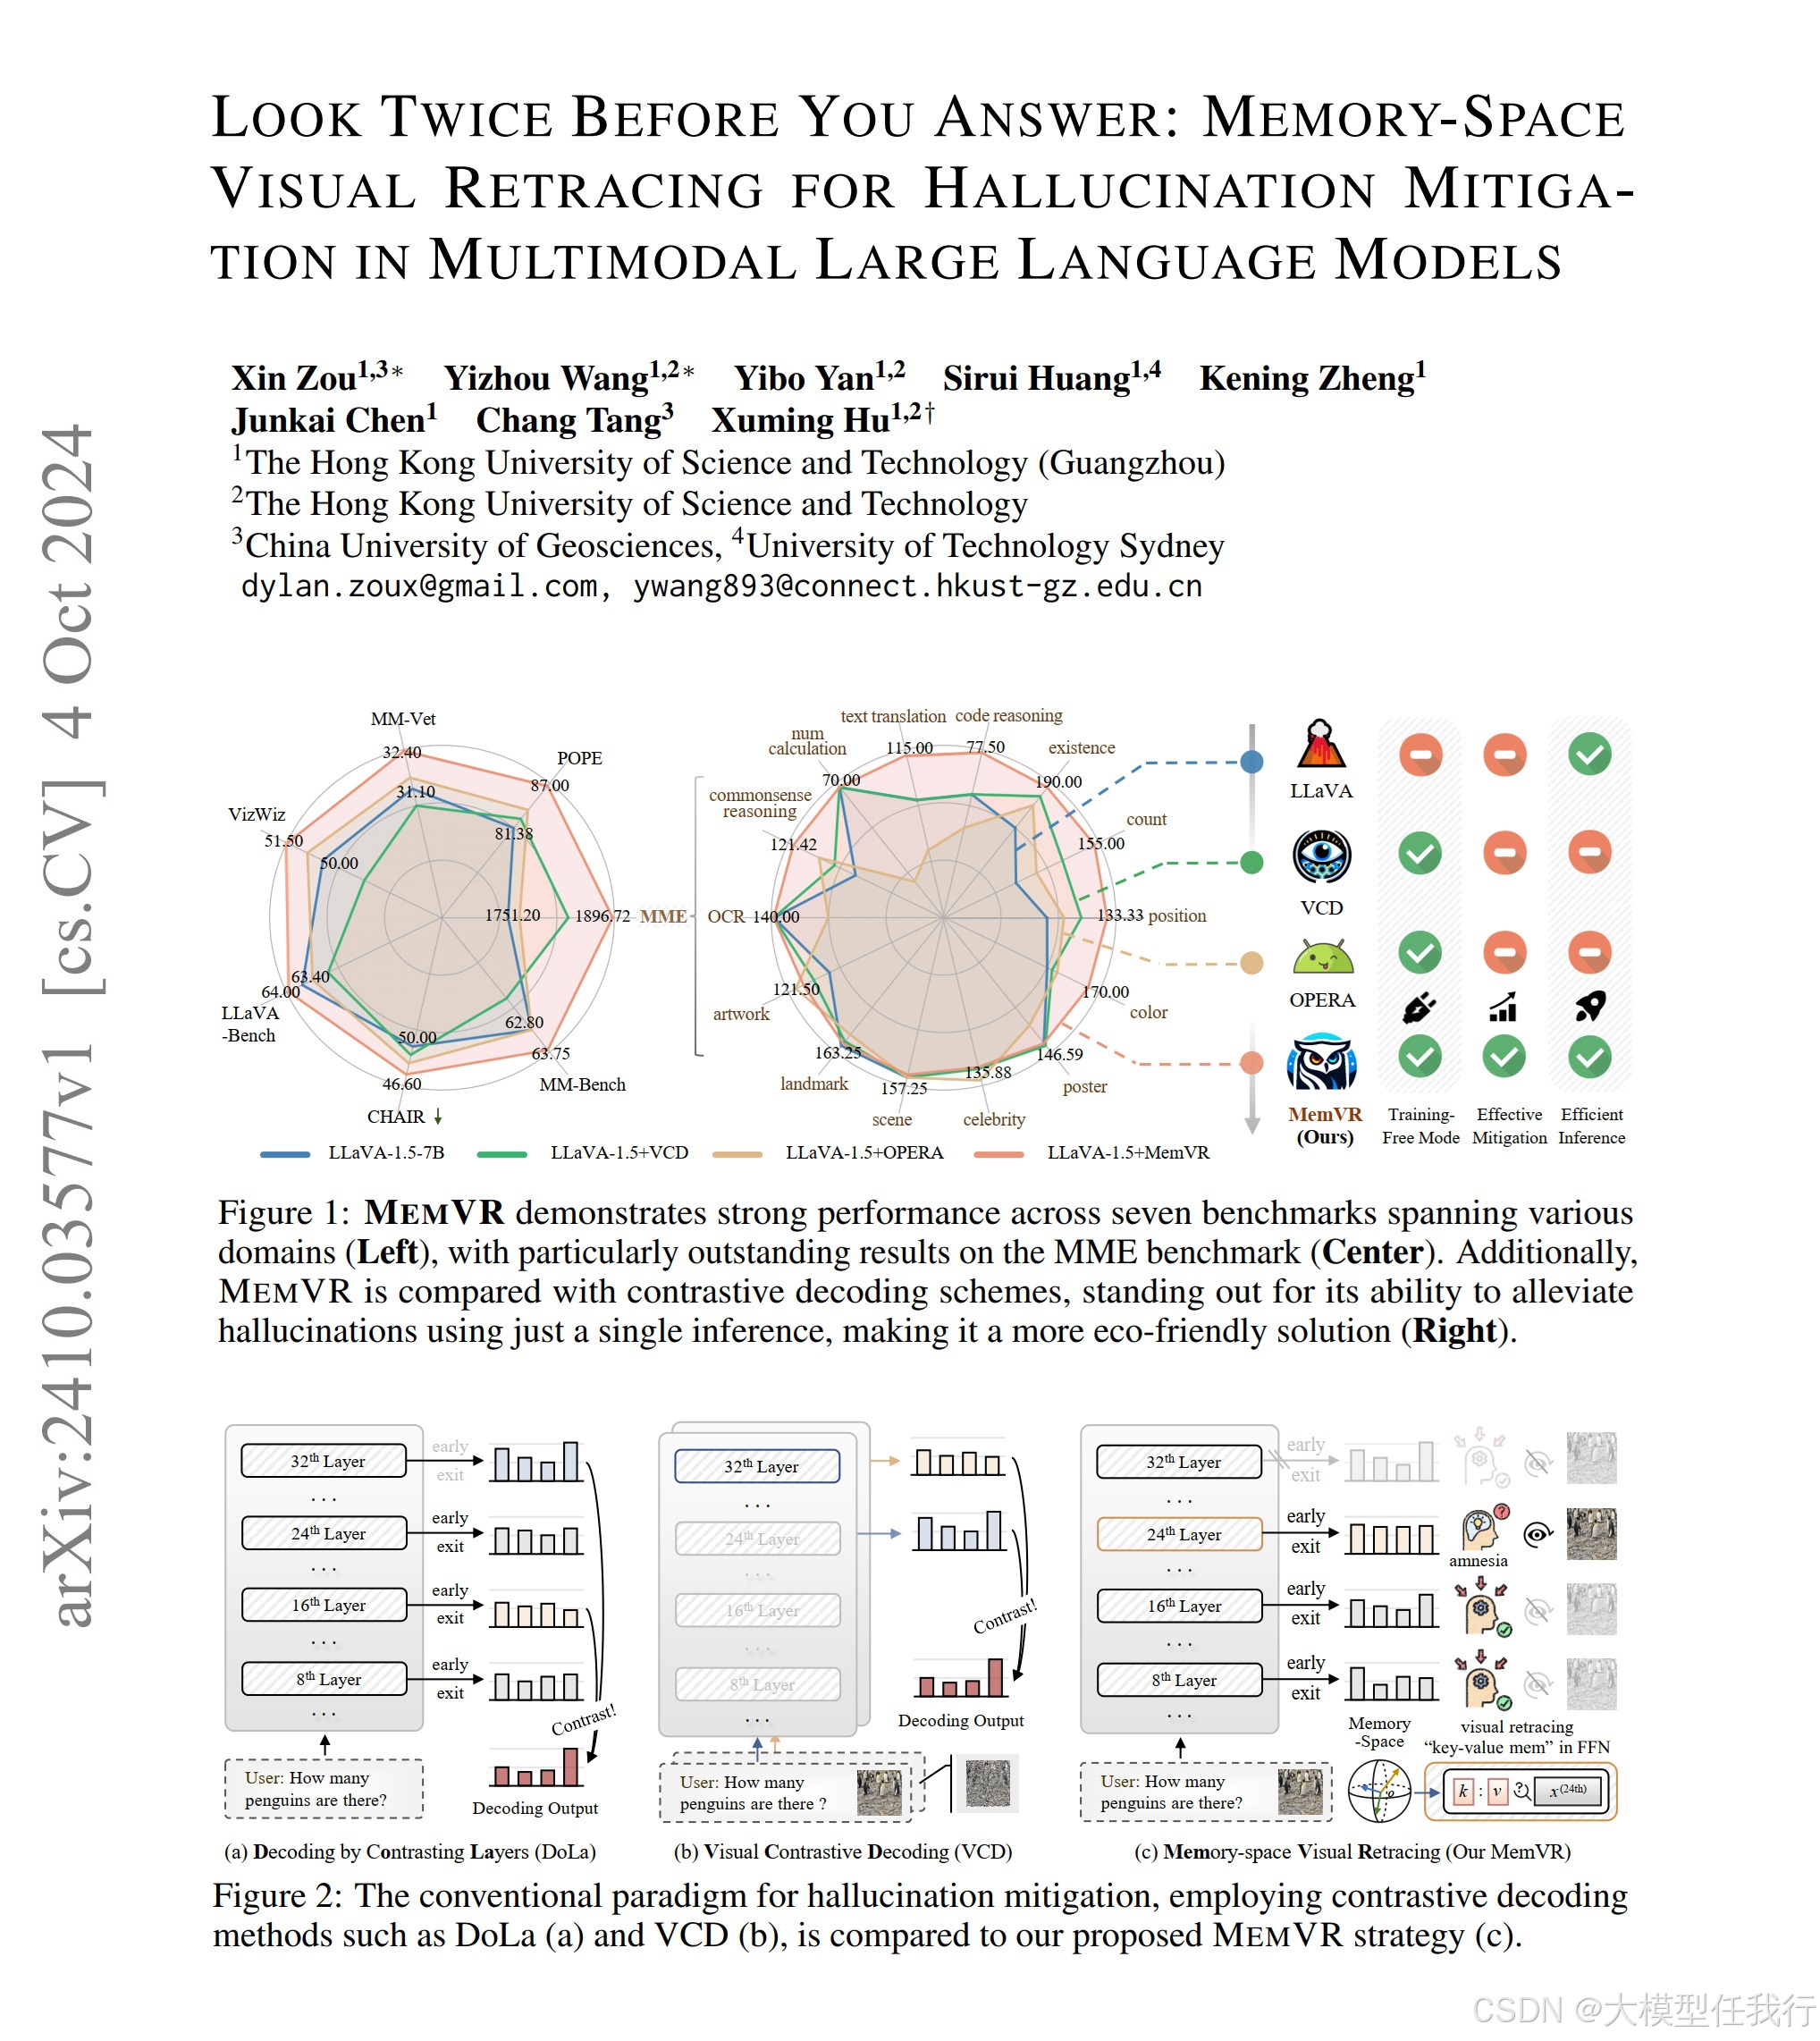
📖标题:Look Twice Before You Answer: Memory-Space Visual Retracing for Hallucination Mitigation in Multimodal Large Language Models
🌐来源:ICML 2025
🌟摘要
🔸尽管多模态大型语言模型 (MLLM) 具有令人印象深刻的能力,但容易受到幻觉的影响,尤其是断言制造视觉输入中不存在的内容。
🔸为了解决上述挑战,我们遵循一个共同的认知过程——当一个人对关键监督细节的初始记忆褪色时,第二次查看它们以寻求事实和准确的答案是很直观的。因此,我们引入了记忆空间视觉回溯(MEMVR),这是一种新的幻觉缓解范式,不需要外部知识检索或额外的微调。特别是,当模型对与问题相关的视觉记忆不确定甚至遗忘时,我们将视觉提示视为补充证据,通过前馈网络 (FFN) 重新注入到 MLLM 中作为“键值记忆”。
🔸综合实验评估表明,MEMVR 显着减轻了各种 MLLM 的幻觉问题,并且在一般基准测试中表现出色,而不会产生额外的时间开销,从而强调了其广泛适用性的潜力。项目在https://github.com/1zhou-Wang/MemVR.
🛎️文章简介
🔸研究问题:多模态大型语言模型(MLLM)中,因视觉输入与模型内部表示不充分对齐而导致的“幻觉”现象。
🔸主要贡献:论文提出了一种新的训练无关的幻觉缓解范式MEMVR,通过补充视觉线索来改善模型的回答准确性。
📝重点思路
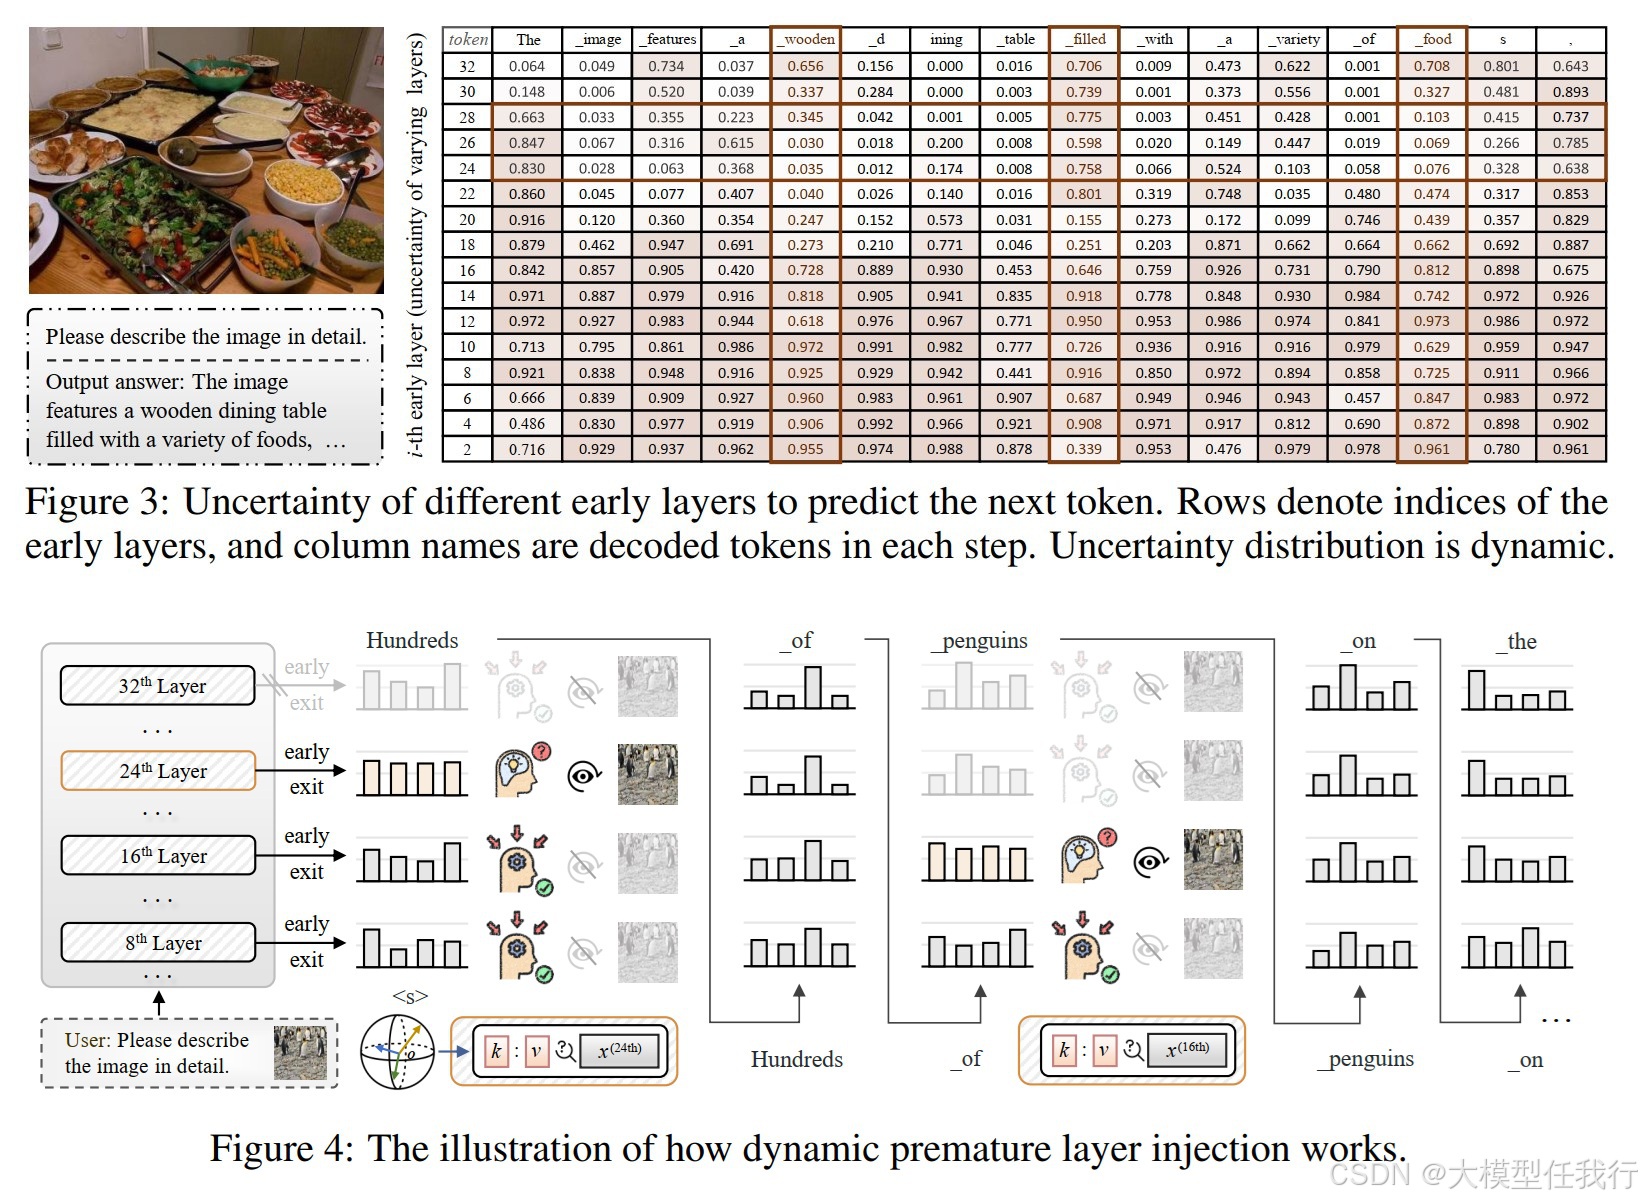
🔸设计了一种动态的提前层注入策略,利用视觉重追溯(visual retracing)来模拟人类的直觉思维,以便在关键记忆被混淆时重新审视图像特征。
🔸MEMVR通过在不增加训练成本的情况下,向MLLM的中间层重新注入视觉特征,以减轻因视觉遗忘造成的幻觉。
🔸通过不确定性作为指标,动态触发视觉重追溯,以提高模型在生成依赖视觉信息的令牌时的准确性。
🔎分析总结
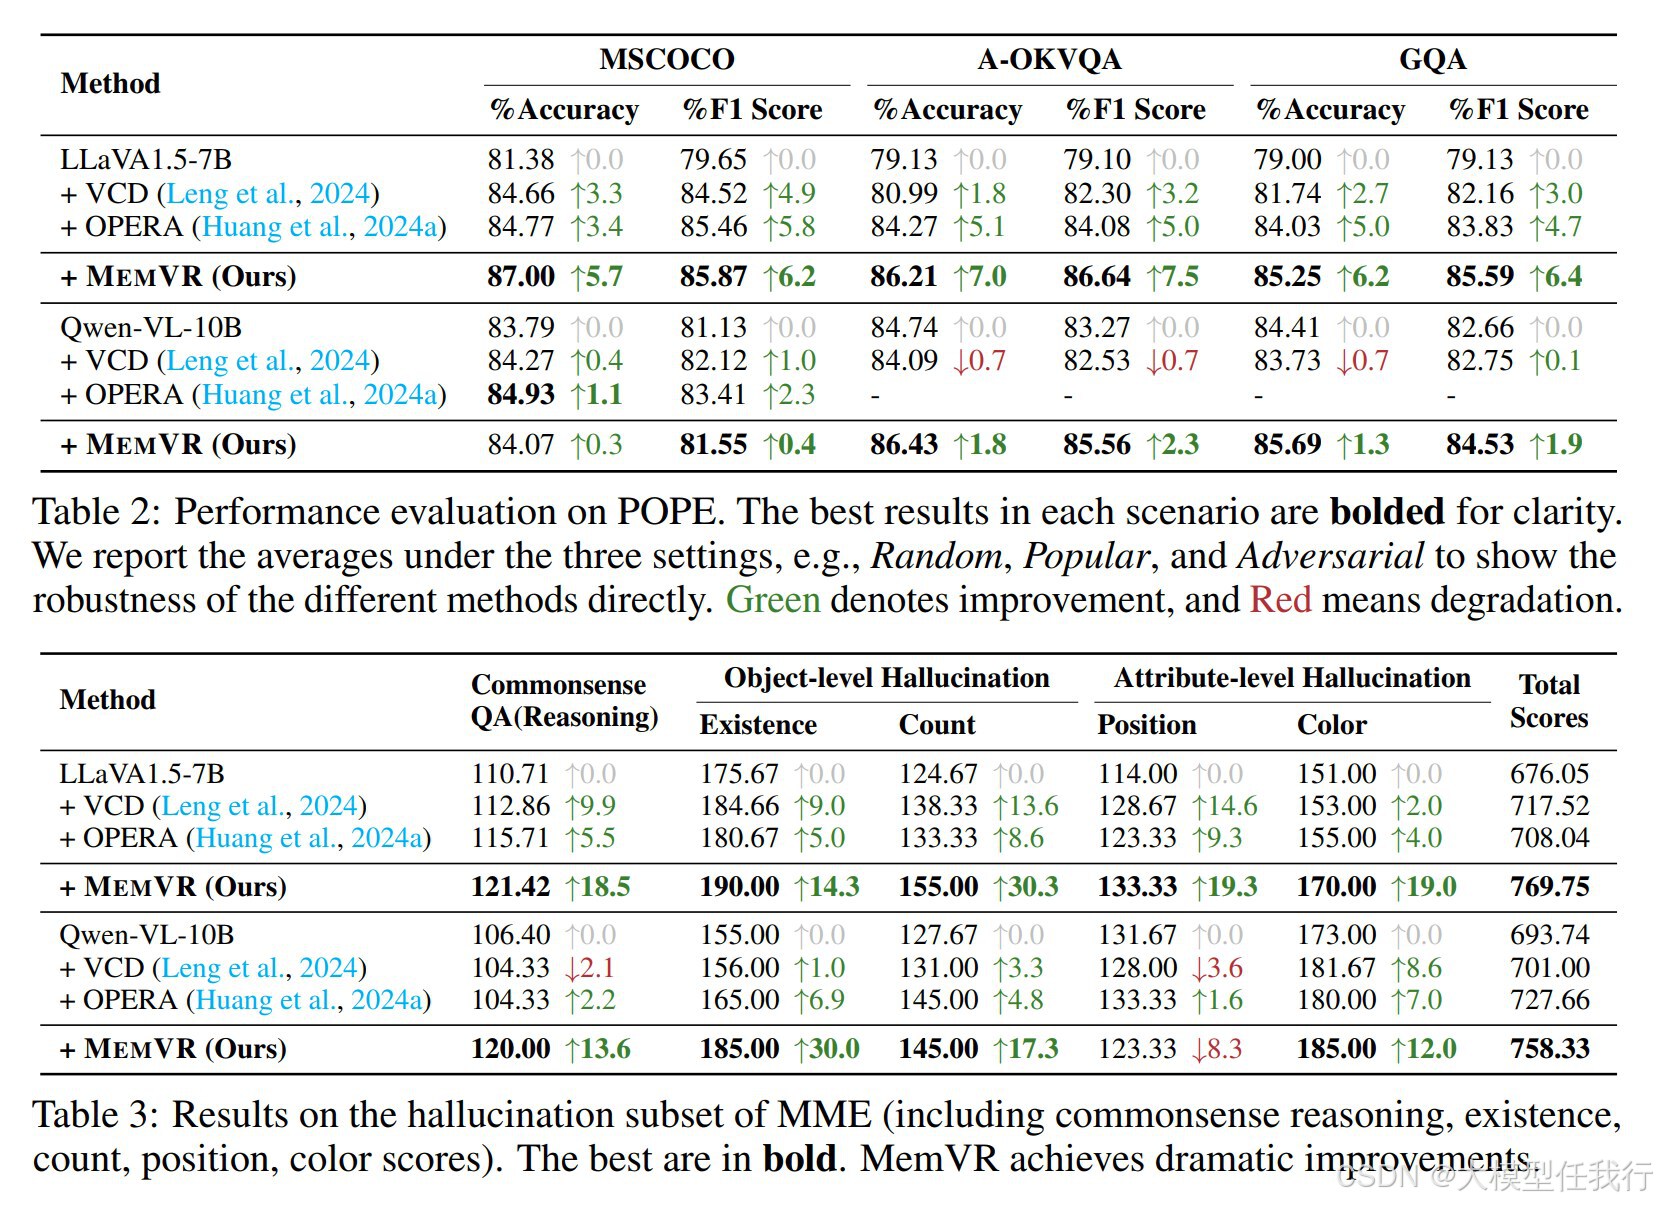
🔸实验结果表明,MEMVR能够有效降低多模态大型语言模型中的幻觉现象,并增强模型的一般认知和感知性能。
🔸通过信息论的视角,验证了视觉重追能够显著提高隐含状态与视觉特征之间的互信息,从而增强模型的表示能力。
🔸论文展示了MEMVR在多项基准测试中的性能提升,表明其在幻觉缓解和一般能力提升方面的有效性和高效率。
💡个人观点
论文强调了通过补充视觉信息而非仅仅依赖语言先验的方式来解决模型的幻觉问题。
🧩附录

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 10
 0
- 0


 已为社区贡献13条内容

所有评论(0)