机器学习算法基础 DAY 5 决策树、随机森林
分类算法-决策树、随机森林
-
认识决策树
-
信息论基础-银行贷款分析
-
决策树的生成
-
泰坦尼克号乘客生存分类
决策树思想的来源非常朴素,程序设计中的条件分支结构就是if-then结构,最早的决策树就是利用这类结构分割数据的一种分类学习方法。
如:

信息的度量和作用
假设有32支球队,猜谁
“谁是世界杯冠军”的信息量应该比5比特少。香农指出,它的准确信息量应该是:
H = -(p1logp1 + p2logp2 + … + p32log32)
式中log以2为底
信息熵
H的专业术语称之为信息熵,单位为比特。

-
32支球队,log32=5比特
-
64支球队,log64=6比特
当这32支球队夺冠的几率相同时,对应的信息熵等于5比特。
信息和消除不确定性是相联系
决策树的划分依据之一-信息增益
特征A对训练数据集D的信息增益g(D,A),定义为集合D的信息熵H(D)与特征A给定条件下D的信息条件熵H(D|A)之差,即公式为:

注:信息增益表示得知特征X的信息而使得类Y的信息的不确定性减少的程度
信息增益的计算
信息熵的计算:

条件熵的计算:

结合前面的贷款数据来看:

常见决策树使用的算法
-
ID3
信息增益最大的准则; -
C4.5
信息增益比最大的准则; -
CART
回归树: 平方误差最小;
分类树: 基尼系数最小的准则,划分更加仔细,在sklearn中可以选择划分的默认原则
sklearn决策树API
class sklearn.tree.DecisionTreeClassifier(criterion=’gini’, max_depth=None,random_state=None)
决策树分类器
criterion:默认是’gini’系数,也可以选择信息增益的熵’entropy’
max_depth:树的深度大小
random_state:随机数种子
method:
decision_path:返回决策树的路径
案例:泰坦尼克号数据分析
在泰坦尼克号和titanic2数据帧描述泰坦尼克号上的个别乘客的生存状态。在泰坦尼克号的数据帧不包含从剧组信息,但它确实包含了乘客的一半的实际年龄。关于泰坦尼克号旅客的数据的主要来源是百科全书Titanica。这里使用的数据集是由各种研究人员开始的。其中包括许多研究人员创建的旅客名单,由Michael A. Findlay编辑。
我们提取的数据集中的特征是票的类别,存活,乘坐班,年龄,登陆,home.dest,房间,票,船和性别。乘坐班是指乘客班(1,2,3),是社会经济阶层的代表。
其中age数据存在缺失。
部分数据:

泰坦尼克号乘客生存分类模型
-
pd读取数据
-
选择有影响的特征,处理缺失值
-
进行特征工程,pd转换字典,特征抽取
x_train.to_dict(orient=“records”) -
决策树估计器流程
决策树的结构、本地保存
1、sklearn.tree.export_graphviz() 该函数能够导出DOT格式
tree.export_graphviz(estimator,out_file='tree.dot’,feature_names=[‘’,’’])
2、工具:(能够将dot文件转换为pdf、png)
安装graphviz
ubuntu:sudo apt-get install graphviz Mac:brew install graphviz
3、运行命令
然后我们运行这个命令
$ dot -Tpng tree.dot -o tree.png
程序:
from sklearn.model_selection import train_test_split
from sklearn.feature_extraction import DictVectorizer
from sklearn.tree import DecisionTreeClassifier, export_graphviz
import pandas as pd

def decision():
    """
    决策树对泰坦尼克号进行预测生死
    :return: None
    """
    # 获取数据
    titan = pd.read_csv("./titanic.txt")

    # 处理数据,找出特征值和目标值
    x = titan[['pclass', 'age', 'sex']]

    y = titan['survived']

    print(x)

    # 缺失值处理
    x['age'].fillna(x['age'].mean(), inplace=True)

    # 分割数据集到训练集合测试集
    x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.25)

    # 进行处理(特征工程)特征-》类别-》one_hot编码
    dict = DictVectorizer(sparse=False)

    #字典特征抽取,
    x_train = dict.fit_transform(x_train.to_dict(orient="records"))

    print(dict.get_feature_names())

    x_test = dict.transform(x_test.to_dict(orient="records"))

    # print(x_train)

    #用决策树进行预测
    dec = DecisionTreeClassifier()

    dec.fit(x_train, y_train)

    # 预测准确率
    print("预测的准确率:", dec.score(x_test, y_test))

    # 导出决策树的结构
    export_graphviz(dec, out_file="./tree.dot", feature_names=['年龄', 'pclass=1st', 'pclass=2nd', 'pclass=3rd', '女性', '男性'])

 	return None


if __name__ == "__main__":
    decision()
运行结果:
     pclass      age     sex
0       1st  29.0000  female
1       1st   2.0000  female
2       1st  30.0000    male
3       1st  25.0000  female
4       1st   0.9167    male
...     ...      ...     ...
1308    3rd      NaN    male
1309    3rd      NaN    male
1310    3rd      NaN    male
1311    3rd      NaN  female
1312    3rd      NaN    male

[1313 rows x 3 columns]

['age', 'pclass=1st', 'pclass=2nd', 'pclass=3rd', 'sex=female', 'sex=male']
预测的准确率: 0.8054711246200608
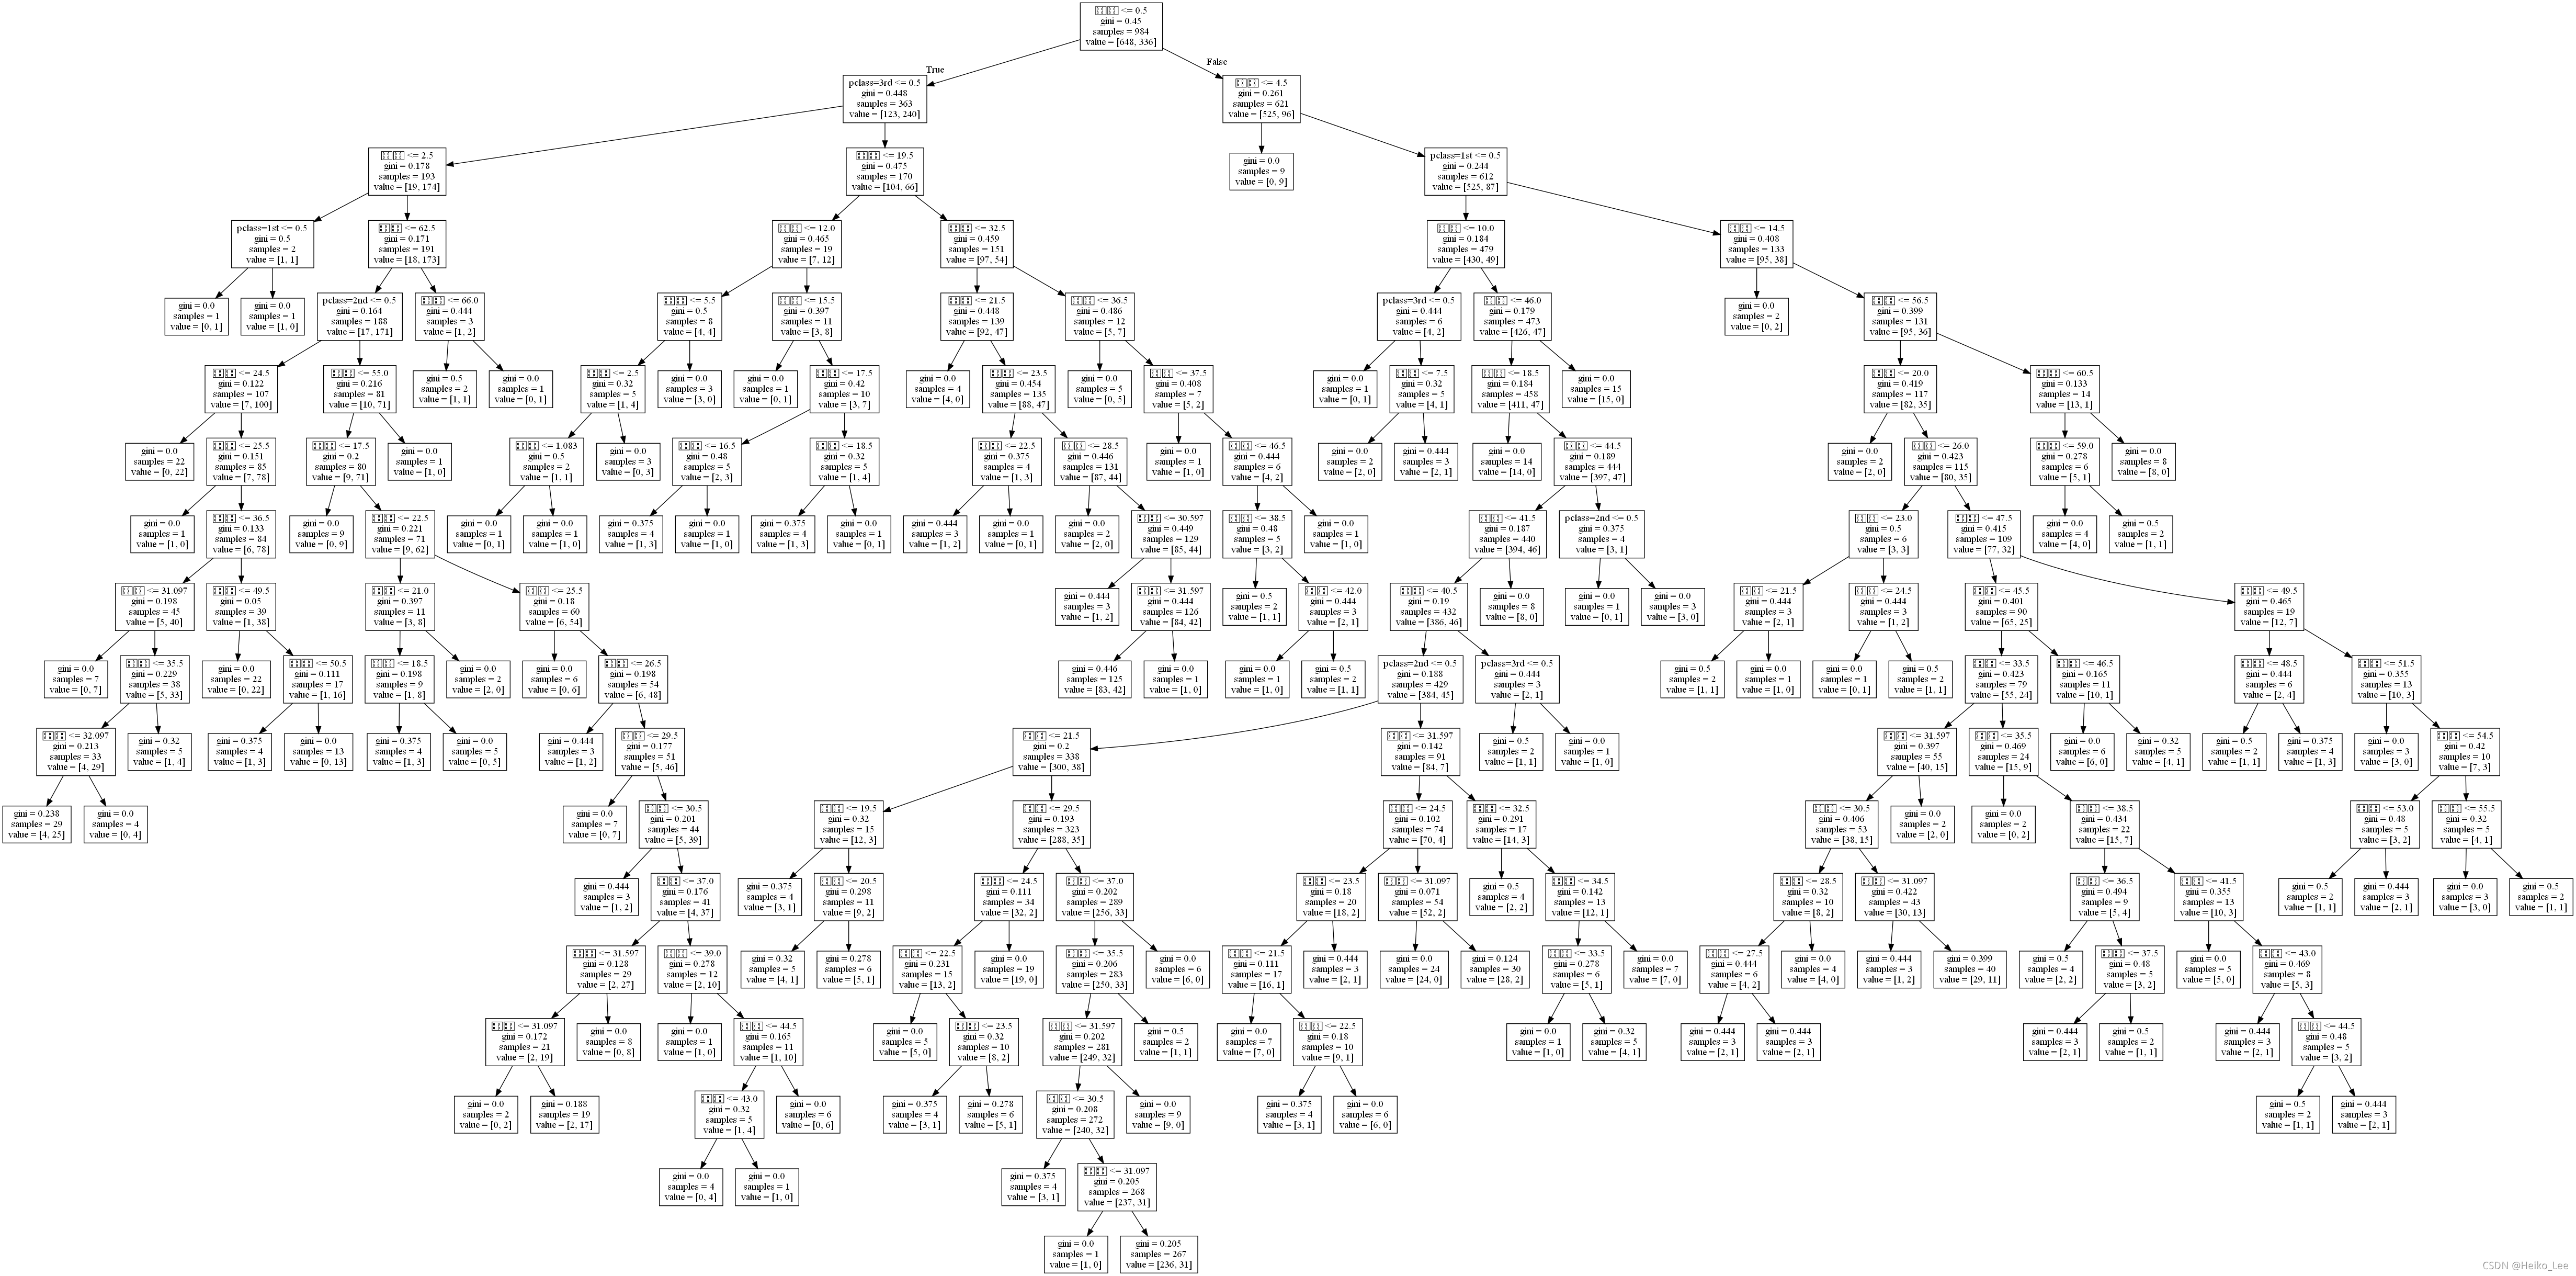
决策树的优缺点以及改进
- 优点:
简单的理解和解释,树木可视化。
需要很少的数据准备,其他技术通常需要数据归一化,
- 缺点:
决策树学习者可以创建不能很好地推广数据的过于复杂的树,这被称为过拟合;
决策树可能不稳定,因为数据的小变化可能会导致完全不同的树被生成。
- 改进:
1.减枝cart算法
(DecisionTreeClassifier参数设定
min_samples_split限定,⼀个结点必须要包含⾄少min_samples_split个训练样本,这个结点才允许被分⽀,否则分⽀就不会发⽣。
min_samples_leaf限定,⼀个结点在分⽀后的每个⼦结点都必须包含⾄少min_samples_leaf个训练样本,否则分⽀就不会发⽣,或者,分⽀会朝着满⾜每个⼦结点都包含min_samples_leaf个样本的⽅向去发⽣。)
2.随机森林
注:企业重要决策,由于决策树很好的分析能力,在决策过程应用较多。
集成学习方法-随机森林
-
什么是随机森林
-
随机森林的过程、优势
-
泰坦尼克号乘客生存分类分析
集成学习方法
集成学习通过建立几个模型组合的来解决单一预测问题。它的工作原理是生成多个分类器/模型,各自独立地学习和作出预测。这些预测最后结合成单预测,因此优于任何一个单分类的做出预测。
什么是随机森林
在机器学习中,随机森林是一个包含多个决策树的分类器,并且其输出的类别是由个别树输出的类别的众数而定。
学习算法
根据下列算法而建造每棵树:
用N来表示训练用例(样本)的个数,M表示特征数目。
输入特征数目m,用于确定决策树上一个节点的决策结果;其中m应远小于M。
从N个训练用例(样本)中以有放回抽样的方式,取样N次,形成一个训练集(即bootstrap取样),并用未抽到的用例(样本)作预测,评估其误差。
为什么要随机抽样训练集?
如果不进行随机抽样,每棵树的训练集都一样,那么最终训练出的树分类结果也是完全一样的
为什么要有放回地抽样?
如果不是有放回的抽样,那么每棵树的训练样本都是不同的,都是没有交集的,这样每棵树都是“有偏的”,都是绝对“片面的”(当然这样说可能不对),也就是说每棵树训练出来都是有很大的差异的;而随机森林最后分类取决于多棵树(弱分类器)的投票表决。
集成学习API
class sklearn.ensemble.RandomForestClassifier(n_estimators=10, criterion=’gini’,max_depth=None, bootstrap=True, random_state=None)
-
随机森林分类器
-
n_estimators:integer,optional(default = 10) 森林里的树木数量
-
criteria:string,可选(default =“gini”)分割特征的测量方法
-
max_depth:integer或None,可选(默认=无)树的最大深度
-
max_features:每个决策树的最大特征数量,默认为“auto”
-
bootstrap:boolean,optional(default = True)是否在构建树时使用放回抽样
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.feature_extraction import DictVectorizer
from sklearn.ensemble import RandomForestClassifier
import pandas as pd

def decision():
    """
    决策树对泰坦尼克号进行预测生死
    :return: None
    """
    # 获取数据
    titan = pd.read_csv("./titanic.txt")

    # 处理数据,找出特征值和目标值
    x = titan[['pclass', 'age', 'sex']]

    y = titan['survived']

    print(x)

    # 缺失值处理
    x['age'].fillna(x['age'].mean(), inplace=True)

    # 分割数据集到训练集合测试集
    x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.25)

    # 进行处理(特征工程)特征-》类别-》one_hot编码
    dict = DictVectorizer(sparse=False)

    #字典特征抽取,
    x_train = dict.fit_transform(x_train.to_dict(orient="records"))

    print(dict.get_feature_names())

    x_test = dict.transform(x_test.to_dict(orient="records"))

	# 随机森林进行预测 (超参数调优)
    rf = RandomForestClassifier()

    param = {"n_estimators": [120, 200, 300, 500, 800, 1200], "max_depth": [5, 8, 15, 25, 30]}

    # 网格搜索与交叉验证
    gc = GridSearchCV(rf, param_grid=param, cv=2)

    gc.fit(x_train, y_train)

    print("准确率:", gc.score(x_test, y_test))

    print("查看选择的参数模型:", gc.best_params_)

    return None


if __name__ == "__main__":
    decision()
运行结果:
 pclass      age     sex
0       1st  29.0000  female
1       1st   2.0000  female
2       1st  30.0000    male
3       1st  25.0000  female
4       1st   0.9167    male
...     ...      ...     ...
1308    3rd      NaN    male
1309    3rd      NaN    male
1310    3rd      NaN    male
1311    3rd      NaN  female
1312    3rd      NaN    male

[1313 rows x 3 columns]

['age', 'pclass=1st', 'pclass=2nd', 'pclass=3rd', 'sex=female', 'sex=male']
准确率: 0.8145896656534954
查看选择的参数模型: {'max_depth': 5, 'n_estimators': 1200}
随机森林的优点
在当前所有算法中,具有极好的准确率;
能够有效地运行在大数据集上;
能够处理具有高维特征的输入样本,而且不需要降维;
能够评估各个特征在分类问题上的重要性;
对于缺省值问题也能够获得很好得结果.

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)