监督学习-分类-决策树算法
·
决策树类似于流程图的树结构,其中,每个内部节点表示在一个属性上面的测试,每个分支代表一个属性输出,每个树叶节点代表类或者类分布。构成它的元素是节点和边,节点会根据样本的特征做出判断,最初的分支点被成为根结点,其余的被成为子节点,不再有分支的节点被称为叶子节点,他们代表样本的分类结果。边则指示着方向。
为了确定许多的特征中谁来做根节点,接下来的节点又是哪些,引入了熵的概念,在决策树中,熵代表的是分支下样本种类的丰富性,样本种类越多越混乱,熵就越大,随着树的深度即树的层数增加,熵的降低速度越快,代表决策树分类效率越高。
决策树最大的优点是天然的可解释性,对各种属性的具象判断;但是数据都是有特例的,如果一棵树能够将训练样本完美分类,那它一定是过拟合的。解决的方法:剪枝,剪枝有两种:预剪枝是在训练开始前规定的条件,比如树达到某一个深度就停止训练;后剪枝则是依据一定条件如限制叶子结点的个数去掉一部分分支。
代码实现:通过样本声音粗细和头发长短来对男女性别进行分类
from math import log
import operator
""""
    根据样本声音粗细和头发长短来对男女性别进行分类
"""
def calcShannonEnt(dataSet):  # 计算数据的熵(entropy)
    numEntries=len(dataSet)  # 数据条数
    labelCounts={}
    for featVec in dataSet:
        currentLabel=featVec[-1] # 每行数据的最后一个字(类别)
        if currentLabel not in labelCounts.keys():
            labelCounts[currentLabel]=0
        labelCounts[currentLabel]+=1  # 统计有多少个类以及每个类的数量
    shannonEnt=0
    for key in labelCounts:
        prob=float(labelCounts[key])/numEntries # 计算单个类的熵值 eg:男 和 女
        shannonEnt-=prob*log(prob,2) # 累加每个类的熵值 男+女
    return shannonEnt

def createDataSet1():    # 创造示例数据
    dataSet = [['长', '粗', '男'],
               ['短', '粗', '男'],
               ['短', '粗', '男'],
               ['长', '细', '女'],
               ['短', '细', '女'],
               ['短', '粗', '女'],
               ['长', '粗', '女'],
               ['长', '粗', '女']]
    labels = ['头发','声音']  #两个特征
    return dataSet,labels

def splitDataSet(dataSet,axis,value): # 按某个特征分类后的数据
    retDataSet=[]
    for featVec in dataSet:
        if featVec[axis]==value:
            reducedFeatVec =featVec[:axis]
            reducedFeatVec.extend(featVec[axis+1:])
            retDataSet.append(reducedFeatVec)
    return retDataSet

def chooseBestFeatureToSplit(dataSet):  # 选择最优的分类特征
    numFeatures = len(dataSet[0]) - 1   #  去掉分类结果这一项,总共有多少个特征
    baseEntropy = calcShannonEnt(dataSet)  # 原始的熵
    bestInfoGain = 0
    bestFeature = -1
    for i in range(numFeatures):
        featList = [example[i] for example in dataSet]
        uniqueVals = set(featList)
        newEntropy = 0
        for value in uniqueVals:
            subDataSet = splitDataSet(dataSet, i, value)
            prob = len(subDataSet) / float(len(dataSet))
            newEntropy += prob * calcShannonEnt(subDataSet)  # 按特征分类后的熵
        infoGain = baseEntropy - newEntropy  # 原始熵与按特征分类后的熵的差值
        if (infoGain > bestInfoGain):  # 若按某特征划分后,熵值减少的最大,则次特征为最优分类特征
            bestInfoGain = infoGain
            bestFeature = i
    return bestFeature

def majorityCnt(classList):  # 按分类后类别数量排序,比如:最后分类为2男1女,则判定为男;
    classCount = {}
    for vote in classList:
        if vote not in classCount.keys():
            classCount[vote] = 0
        classCount[vote] += 1
    sortedClassCount = sorted(classCount.items(), key=operator.itemgetter(1), reverse=True)
    return sortedClassCount[0][0]

def createTree(dataSet, labels): # 输入数据为示例数据集+特征集合
    classList = [example[-1] for example in dataSet]  # 从实例数据集中取出分类结果:男或女
    if classList.count(classList[0]) == len(classList):
        return classList[0]   #  分类结果没区别  不管怎么分都是这个结果   直接输出就行了
    if len(dataSet[0]) == 1:
        return majorityCnt(classList) #  分类结果没区别  不管怎么分都是这个结果   直接输出就行了
    bestFeat = chooseBestFeatureToSplit(dataSet)  # 选择最优特征
    bestFeatLabel = labels[bestFeat]
    myTree = {bestFeatLabel: {}}  # 分类结果以字典形式保存
    del (labels[bestFeat])
    featValues = [example[bestFeat] for example in dataSet]
    uniqueVals = set(featValues)
    for value in uniqueVals:
        subLabels = labels[:]
        myTree[bestFeatLabel][value] = createTree(splitDataSet \
                                                      (dataSet, bestFeat, value), subLabels)
    return myTree


dataSet, labels = createDataSet1()  # 创造示列数据
print(createTree(dataSet, labels))  # 输出决策树模型结果
运行结果: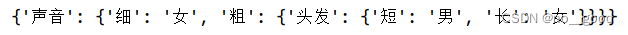

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)