统计学习方法——(第五章)决策树及其变种与剪枝(下)
一、知识回顾
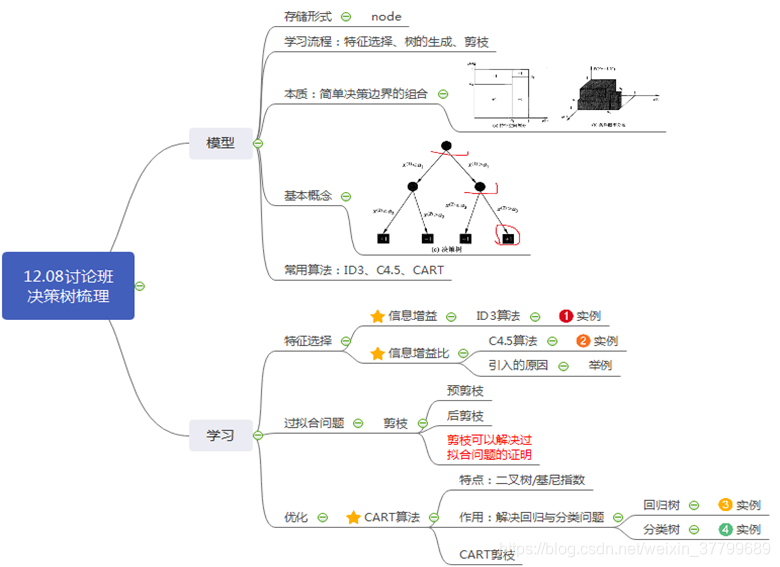
二、CART算法
1、原理
分类与回归树(classification and regression tree, CART)模型是应用广泛的决策树学习方法,同样由特征选择、树的生成和剪枝组成,既可以用于分类也可以用于回归。CART假设决策树是二叉树,内部结点特征的取值为“是”和“否”,左分支是取值为“是”的分支,右分支是取值为“否”的分支。
2、算法流程
- 决策树生成:基于训练数据集生成决策树,生成的决策树要尽量大。
- 决策树剪枝:用验证数据集对已生成的树进行剪枝并选择最优子树,这时用损失函数最小作为剪枝的标准。
3、分类树
1)划分选择
分类树用基尼指数选择最优特征,同时决定该特征的最优二值切分点。比较基尼系数和熵模型的表达式,二次运算比对数简单很多。尤其是二分类问题,更加简单。
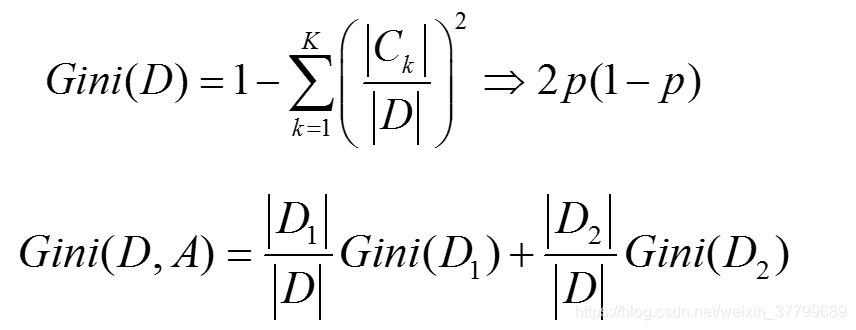
和熵模型的度量方式比,基尼系数对应的误差有多大呢?对于二类分类,基尼系数和熵之半的曲线如下:
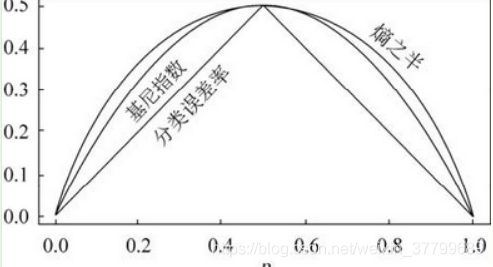
基尼系数和熵之半的曲线非常接近,仅在45度角附近误差稍大。因此,基尼系数可以做为熵模型的一个近似替代。CART分类树算法每次仅对某个特征的值进行二分,而不是多分,这样CART分类树算法建立起来的是二叉树,而不是多叉树。
2)算法流程
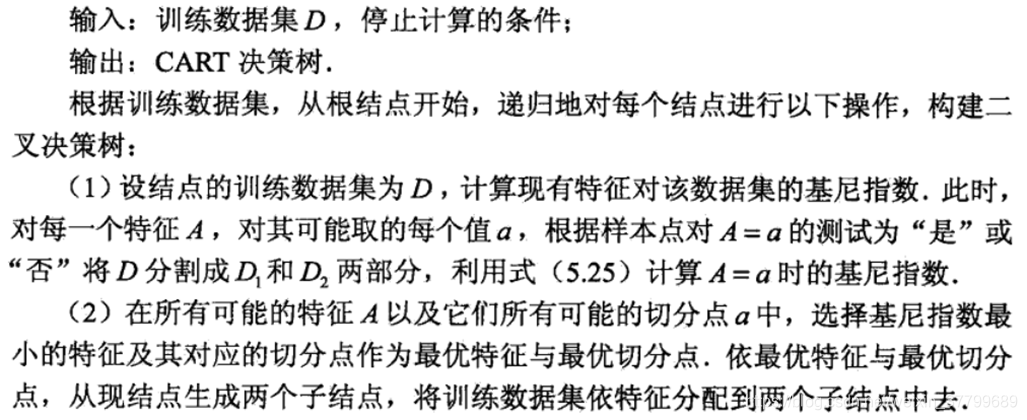
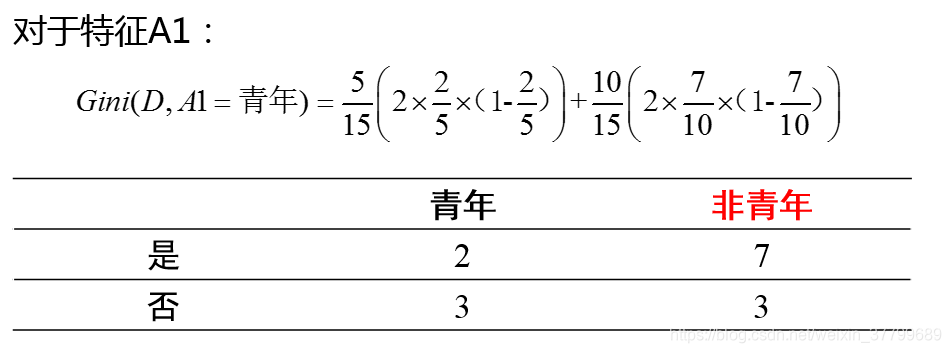
3)例子 ,题干见书
4、回归树
1)原理
该片叶子所含训练集元素输出的均值每一片叶子作为该叶子节点的预测值。所以CART 的每一片叶子都表示的是一个预测值,取值是连续的。取值是连续的。
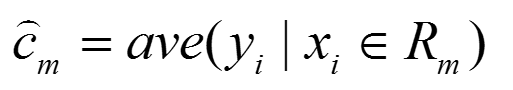
2)策略
CART假设决策树是二叉树,内部结点特征的取值为“是”和“否”,左分支是取值为“是”的分支,右分支是取值为“否”的分支。构造一个f(x)能够拟合数据集中的元素,使mse最小。
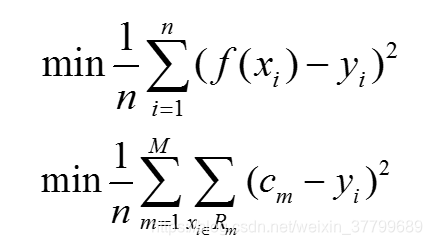
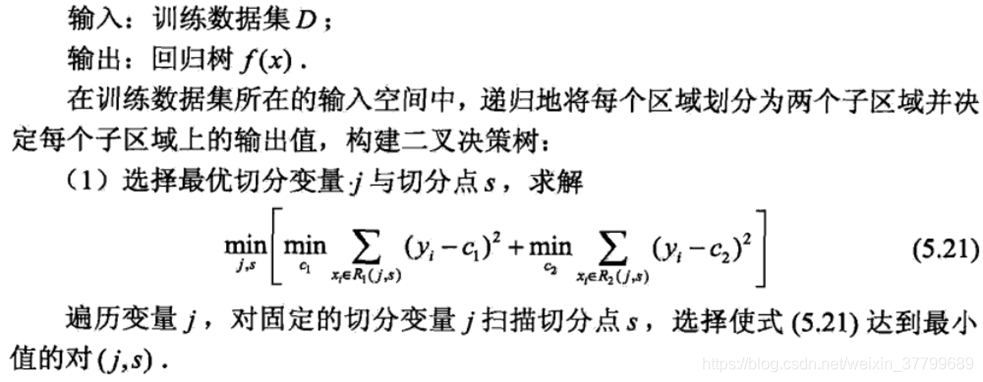
3)算法流程 (找到最优属性的最优划分值)
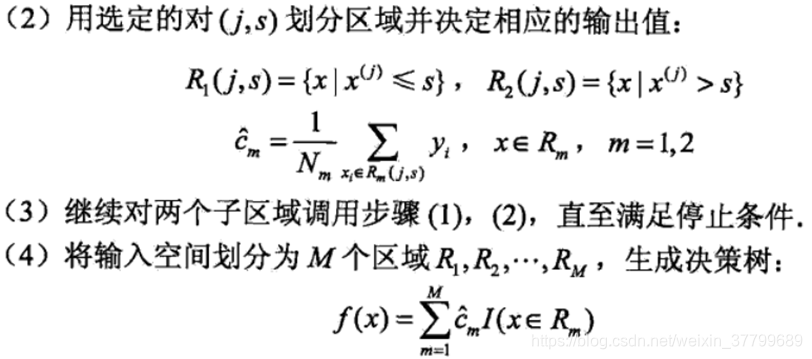
4)举例
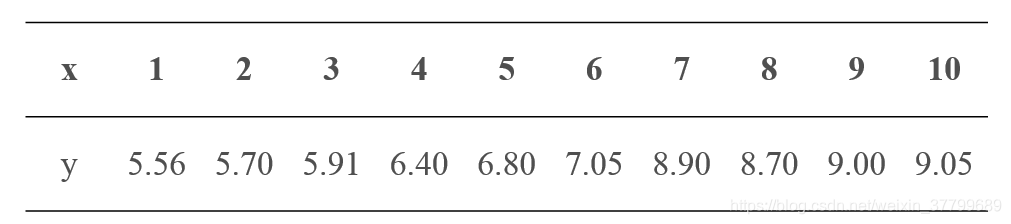
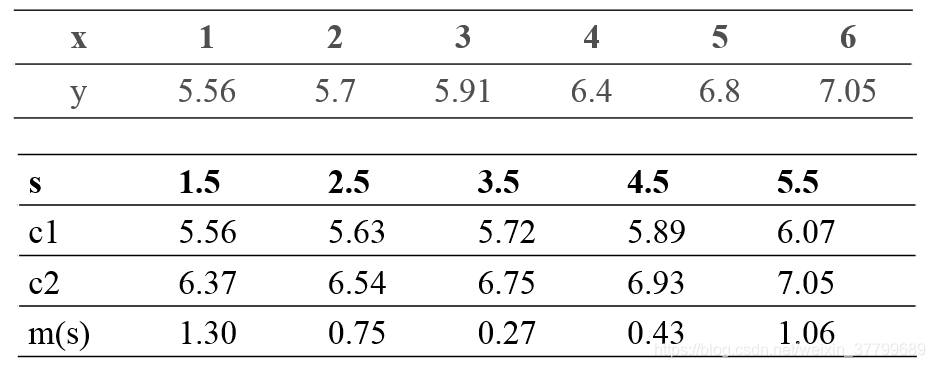
题干:根据以下数据进行回归
(1)设置切分点并计算均值
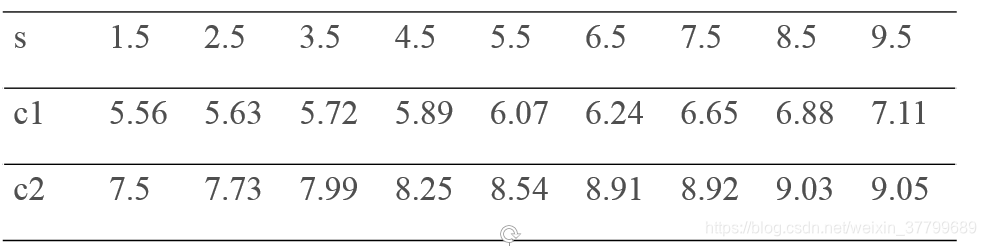
例如,取 s=1.5,s=1.5。此时 R1={1},R2={2,3,4,5,6,7,8,9,10} 。这两个区域的输出值分别为: c1=5.56;c2=1/9*(5.7+5.91+6.4+6.8+7.05+8.9+8.7+9+9.05) =7.50
(2)计算均方误差值
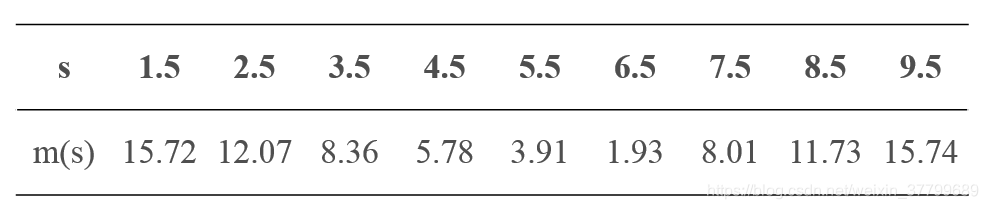
如:m(1.5)=0+15.72=15.72。显然取 s=6.5时,m(s)最小。因此,第一个划分变量j=x,s=6.5。两个区域分别是:R1={1,2,3,4,5,6},R2={7,8,9,10};输出值:c1=6.24,c2=8.91
(3)对R1重复上述步骤,s=3.5时损失最小
(4)生成回归树
假设在生成3个区域之后停止划分,那么最终生成的回归树形式如下:
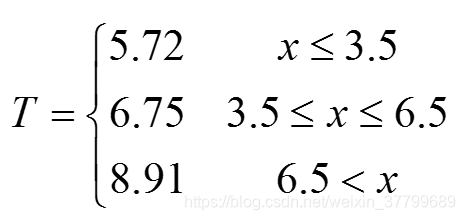
5)代码 参考链接
from numpy import *

def loadDataSet(fileName):      #general function to parse tab -delimited floats
    dataMat = []                #assume last column is target value
    fr = open(fileName)
    for line in fr.readlines():
        curLine = line.strip().split('\t')
        fltLine = map(float,curLine) #map all elements to float()
        dataMat.append(fltLine)
    return dataMat

def binSplitDataSet(dataSet, feature, value):
    mat0 = dataSet[nonzero(dataSet[:,feature] > value)[0],:][0]
    mat1 = dataSet[nonzero(dataSet[:,feature] <= value)[0],:][0]
    return mat0,mat1


def createTree(dataSet, leafType=regLeaf, errType=regErr, ops=(1,4)):#assume dataSet is NumPy Mat so we can array filtering
    feat, val = chooseBestSplit(dataSet, leafType, errType, ops)#choose the best split
    if feat == None: return val #if the splitting hit a stop condition return val
    retTree = {}
    retTree['spInd'] = feat
    retTree['spVal'] = val
    lSet, rSet = binSplitDataSet(dataSet, feat, val)
    retTree['left'] = createTree(lSet, leafType, errType, ops)
    retTree['right'] = createTree(rSet, leafType, errType, ops)
    return retTree
def regLeaf(dataSet):#returns the value used for each leaf
    return mean(dataSet[:,-1])

def regErr(dataSet):
    return var(dataSet[:,-1]) * shape(dataSet)[0]


def chooseBestSplit(dataSet, leafType=regLeaf, errType=regErr, ops=(1,4)):
    tolS = ops[0]; tolN = ops[1]
    #if all the target variables are the same value: quit and return value
    if len(set(dataSet[:,-1].T.tolist()[0])) == 1: #exit cond 1
        return None, leafType(dataSet)         #如果所有值相等则退出
    m,n = shape(dataSet)
    #the choice of the best feature is driven by Reduction in RSS error from mean
    S = errType(dataSet)
    bestS = inf; bestIndex = 0; bestValue = 0
    for featIndex in range(n-1):
        for splitVal in set(dataSet[:,featIndex]):
            mat0, mat1 = binSplitDataSet(dataSet, featIndex, splitVal)
            if (shape(mat0)[0] < tolN) or (shape(mat1)[0] < tolN): continue
            newS = errType(mat0) + errType(mat1)
            if newS < bestS:
                bestIndex = featIndex
                bestValue = splitVal
                bestS = newS
    #if the decrease (S-bestS) is less than a threshold don't do the split
    if (S - bestS) < tolS:
        return None, leafType(dataSet)   #如果过误差减少不大则退出
    mat0, mat1 = binSplitDataSet(dataSet, bestIndex, bestValue)
    if (shape(mat0)[0] < tolN) or (shape(mat1)[0] < tolN):  #exit cond 3
        return None, leafType(dataSet)
    return bestIndex,bestValue  #如果切分出的数据集很小则退出
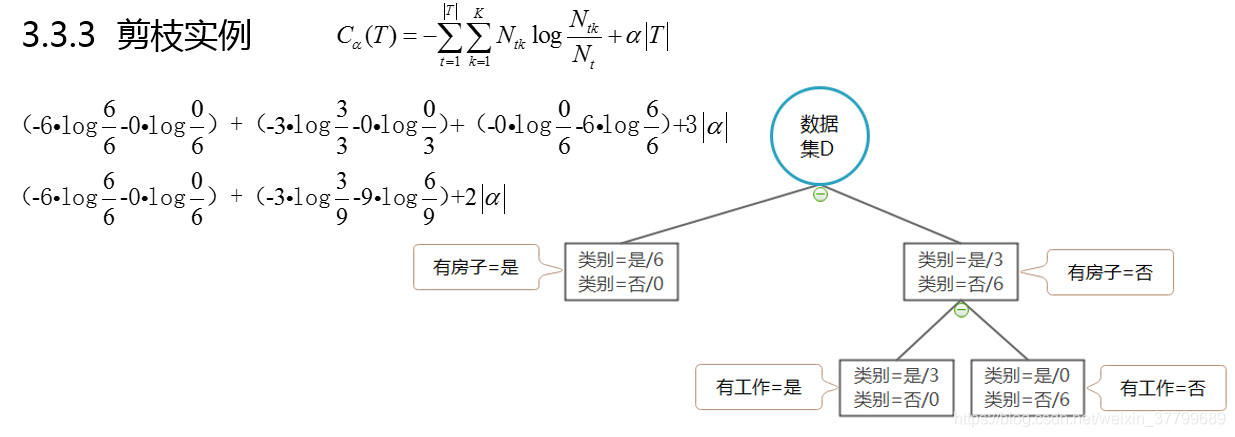
三、剪枝
1、背景
剪枝是决策树学习算法对付“过拟合”的主要手段。在决策树学习中,为了尽可能正确分类训练样本,结点划分过程将不断重复,有时会造成决策树分支过多,这时就可能因训练样本学得“太好”了,以致于把训练集自身的一些 特点当作所有数据都具有的一般性质而导致过拟合。因此,可通过主动去掉一些分支来降低过拟合的风险。
2、策略
预剪枝是指在决策树生成过程中,对每个结点在划分前先进行估计,若当前结点的划分不能带来决策树泛化性能提升,则停止划分并将当前结点标记为叶结点;
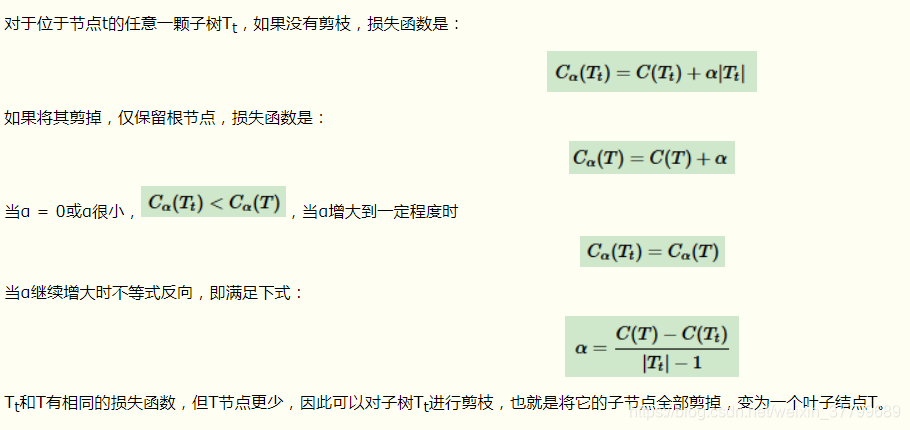
后剪枝则是先从训练集生成一棵完整的决策树,然后自底向上地对非叶结点进行考察,若将该结点对应的子树替换为叶结点能带来决策树泛化性能提升,则将子树替换为叶结点。
3、损失函数(本质是叶子节点的信息熵)
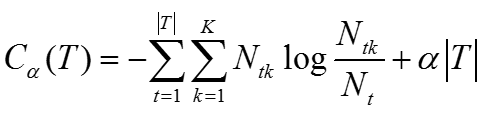
4、步骤
5、例子 (题干见书)

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)