周志华机器学习(更新中)
第一章 绪论
1.1机器学习定义
通过计算,利用经验改善系统自身性能,“经验”以“数据”形式存在
学习算法:从数据产生“模型”算法
1.2基本术语
- 数据集:记录的集合
- 每条记录对应一个事件或对象,反应时间或对象在某方面的表现或性质
例:西瓜的色泽" "根蒂" "敲声",称为"属性" (attribute) 或"特征" (feature);
属性上的取值,例如"青绿" "乌黑",称为"属性值" (attribute value).
属性张成的空间称为"属性空间" (attribute space) "样本空间" (samp1e space)或"输入 空间"
- 把"色泽" "根蒂" "敲声"作为三个坐标轴,则它们张成一个用于描述西瓜的三维空间,每个西瓜都可在这个空间中找到自己的坐标位 置.由于空间中的每个点对应一个坐标向量,因此我们也把一个示例称为一个 "特征向量" (feature vector).有几个属性就有多少”维数" (dimensionality)。
例:(色泽=青绿;根蒂=蜷缩;敲声=浊响),3个属性,3维
- 训练过程中,每一条记录称为一个“训练样本”,同时在训练好模型后,我们希望使用新的样本来测试模型的效果,则每一个新的样本称为一个“测试样本”。
- 训练集:训练样本的集合
- 测试集:测试样本的集合
-
预测值为离散值的问题为:分类(classification)。
-
预测值为连续值的问题为:回归(regression)。
-
聚类:对训练集西瓜分成若干类,每组称为一个"簇",簇可能对应一些潜在的概念划分,这些的概念我们事先是不知道的
-
监督学习(supervised learning):训练数据有标记信息;分类和回归
-
无监督学习(unsupervised learning):训练数据有无标记信息;聚类和关联规则。
学得模型适用于新样本的能力,称为"泛化" (generalization)能力.
1.3 假设空间
- 归纳(induction):是从特殊到一般的"泛化" (generalization)过程(具体的事实总结一般性规律)
- 横绎(deduction):从一般到特殊的"特化" (specialization)过程(从基础原理推演出具体状况)
- "概念学习":从训练数据中学得概念
- 布尔概念学习:"是" "不是"这样的可表示 为 0/1 布尔值
1.4 归纳偏好
- 学习算法在面对多个可能的假设时,倾向于选择某种类型的假设的倾向。这种偏好会影响最终模型的选择和性能。
- 倾向曲线光滑而非太过复杂,提高泛化能力
第2章 模型评估与选择
2.1 经验误差与过拟合
- m个样本,a个分类错误 错误率: E=a/m
- 精度=1-E=1-a/m
- 误差:预测输出与样本的真实输出之间的差异
- 在训练集上的误差称为训练误差(training error)或经验误差(empirical error)。
- 在测试集上的误差称为测试误差(test error)。
- 学习器在所有新样本上的误差称为泛化误差(generalization error)
-
过拟合:骄傲了
-
欠拟合:谦虚了
2.2 评估方法
- 测试集上的测试误差
2.2.1 留出法
- 将数据集 D 划分为两个互斥的集合,其中一个集合作为训练集S,另一个作为测试集T
- 训练/测试集的划分要尽可能保持数据分布的一致性
例:对 D 进行分层采样而获得含 70% 样本的训练集S和含 30% 样本的测试集T
D包含500个正例、 500个反例,则分层采样得到的 S 应包含350个正例、350个反例而T 则包含150个正例和 150个反例;
若 S、 T 中样本类别比例差别很大,则误差估计将由于训练/测试数据分布的差异 而产生 偏差.
- 先正例或先反例仍有差别,故多次随即划分,重复实验评估后取平均值作为评估结果
- 常见做法是将大约 2/3~4/5 的样本用于训练,剩余样本用于测试
2.2.2 交叉验证法
- 将数据集 D 划分为 k 个大小相似的互斥子集,每个子集 Di 都 尽可能保持数据分布的一致性;每次用 k-1 个子集的并集作为训练集,余下的那个子集作为测试集;
这样就可获得k组训练/测试集,从而可进行k次训练和测试,最终返回的是这k个测试结果的均值.
交叉验证法评估结果的稳定性和保真性在很大程度上取决于k的取值,k最常用的取值是 10.
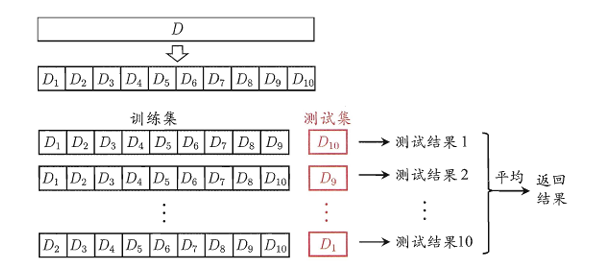
- 与留出法相似,为减小因样本划分不同而引入的差别,k折交叉验证通常要随机使用不同的划分重复p次,最终的评估结果是这p次k折交叉验证结果的均值.
- 特殊地当划分的k个子集的每个子集中只有一个样本时,称为“留一法”,显然,留一法的评估结果比较准确,但对计算机的消耗也是巨大的。
2.2.3 自助法
我们希望评估的是用D训练出的模型.但在留出法和交叉验证法中,由于保留了一部分样本用于测试,因此实际评估的模型所使用的训练集比D小。
- 给定包含 m 个样本的数据集D,每次随机从D 中挑选一个样本,将其拷贝放入D' 然后再将该样本放回初始数据集D中,使得该样本在下次采样时仍有可能被采到;
这个过程重复执行m次后,我们就得到了包含m个样本的数据集D',这就是自助采样的结果.
可以做一个简单的估计,样本在m次采样中始终不被采到的概率是, 取极限得到
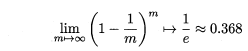
通过自助来样,初始数据集D中约有36.8%的样本未出现在采样数据集D' 中.于是我们可将 D'用作训练集,D\D'用作测试集;
实际评估的模型与期望评估的模型都使用m个训练样本,而我们仍有数据总量约 1/3 的没在训 练集中出现的样本用于测试.这样的测试结果,亦称"包外估计"
-
使用场景:
自助法在数据集较小、难以有效划分训练/测试集时很有用;
此外,能产生多个不同的训练集,对集成学习有益;
然而,改变了原始分布,引入估计偏差.因此,在初始数据量足够时,留出法和交叉验证法更常用一些.
2.2.4 调参与最终模型
算法都有些参数需要设定,参数配置不同,学得模型的性能往往有显著差别.
- 调参与算法选择本质上没什么区别:不同配置的到不同的模型,把对应最好的模型参数作为结果.
实际操作中,参数选定是一个范围加一个变换步长.如在 [0,0.2] 范围内以 0.05 为步长,有0,0.05,0.1,0.15,0.2这5种参数选择.这已经是计算开销和性能估计的折中.
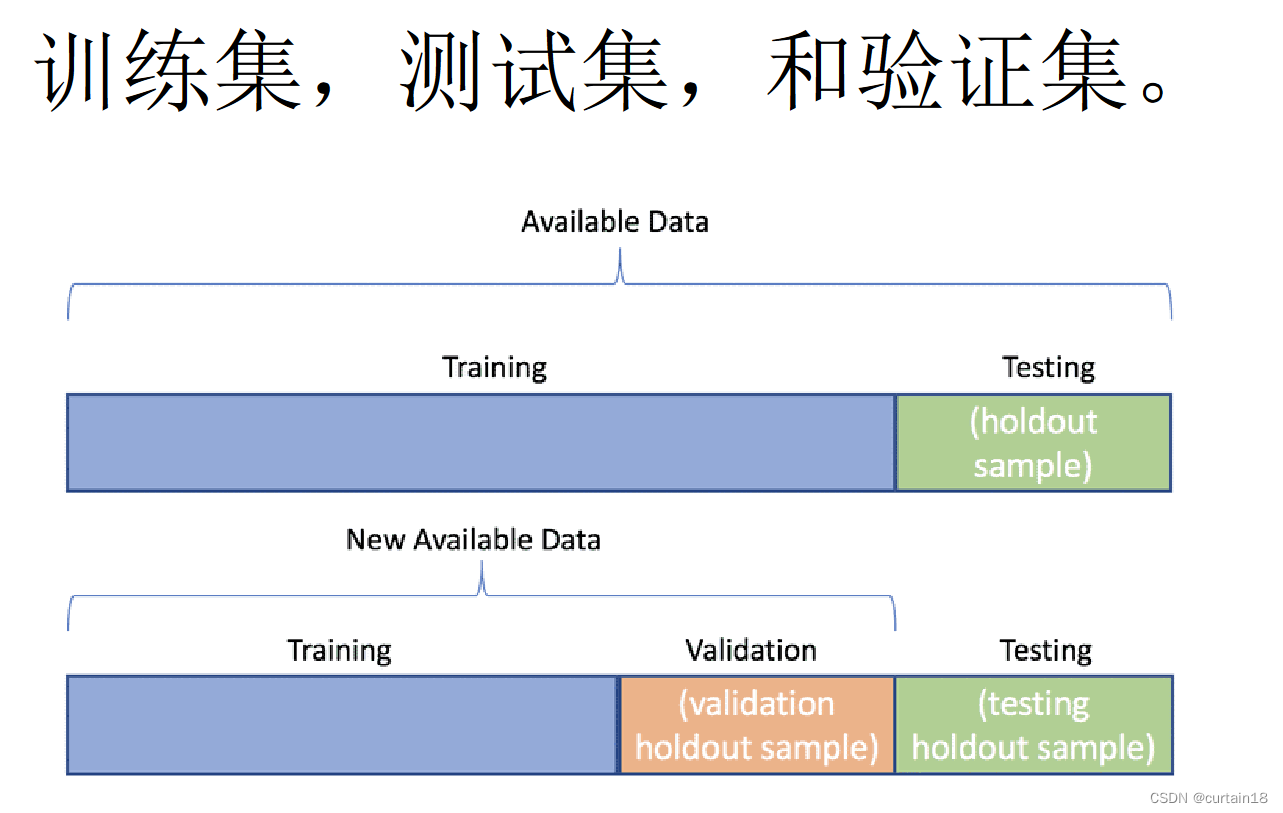
然而,假定3个参数,每个参数有5种选择,模型将有125中需要对比. - 在研究对比不同算法的泛化性能时,我们用测试集上的判别效果来估计模型在实际使用时的泛化能力,而把训练数据另外划分为训练集和验证集,基于验证集上的性能来进行模型选择和调参.
2.3 性能度量
- 用来衡量模型泛化能力的评价标准.
- 性能度量反映了任务需求,在对比不同模型的能力时,使用不同的性能度量往往会导致不同的评判结果;模型的"好坏"是相对的.
- 预测任务中,样例集D= {(X1, Y1), (X2,Y2), . . . , (Xm, Ym)}, 其中Yi 是示例Xi 的真实标记.要评估学习器F 的性能,就要把学习器预测结果F(x) 与真实标记Y进行比较
回归任务最常用的性能度量是"均方误差"
更一般的,对于数据分布D概率密度函数p(.), 均方误差可描述为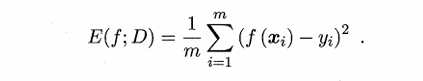
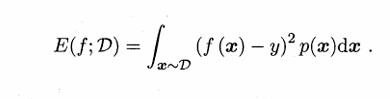
2.3.1 错误率与精度 -
最常用的两种性能度量
对样例集D:
错误率是分类错误占的比例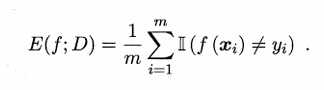
精度是分类正确占的比例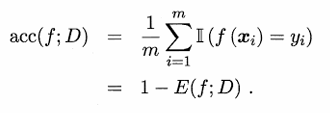
- 更一般表示方法:数据分布D,概率密度p(.)
错误率: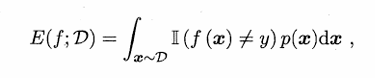
精度: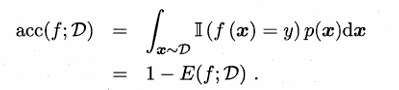
2.3.2 查准率、查全率与F1
错误率和精度虽常用,但并不能满足所有任务需求.例如用户关心“多少是好瓜,比例是多少?”
- 对于二分类问题,可将样例根据其真实类别与学习器预测类别的组合划分为
真正例(true positive)、假正例(false positive)、真反例(true negative)、 假反例(false negative)
TP+FP+TN+FN=样例总数
查准率P 与查全率R 分别定义为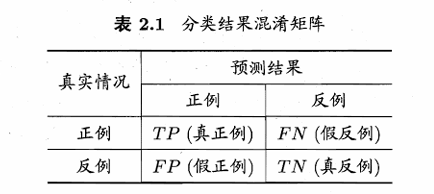
例:一组D=[100A,100B]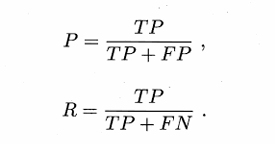
预测结果:D'[120A,80B]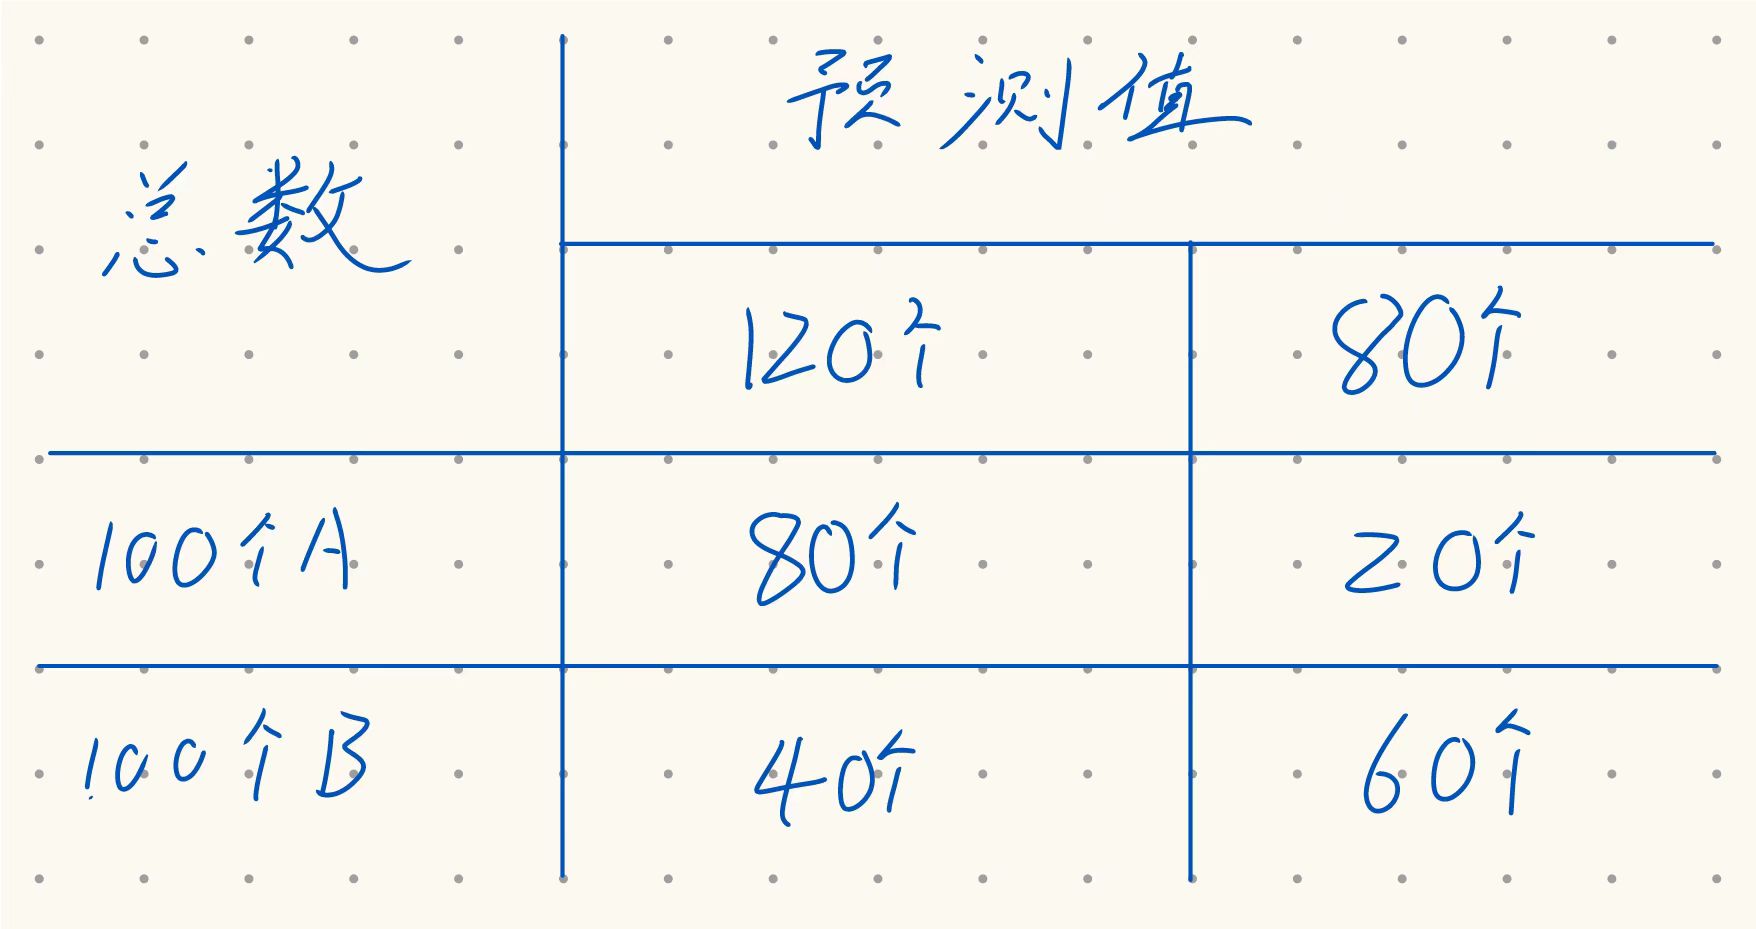
120A中实际有80个A,40个B;80B中有20个A,60个B
查准率P=80/80+40(准不准)竖向加 测了120个A,有80个对了
查全率R=80/80+20(全不全)横向加 实际有100个A,查对的有80个 - 查准率和查全率是一对矛盾的度量.
一般来说,查准率高时,查全率往往偏低;而查全率高时,查准率往往偏低.
只有在一些简单任务中,才能使查准率和查全率都很高 - 在很多情形下,我们可根据学习器的预测结果对样例进行排序,排在前面的是"最可能"是正例的样本,排在最后的则是"最不可能"是正例的样本.
按此顺序逐个把样本作为正例进行预测,计算P ,R 值得到“P-R曲线”,称为“P-R图”
若一个学习器的P-R 曲线被另一个学习器的曲线完全"包住" , 则可断言后者的性能优于前者,如A>C,而AB需要具体情况具体分析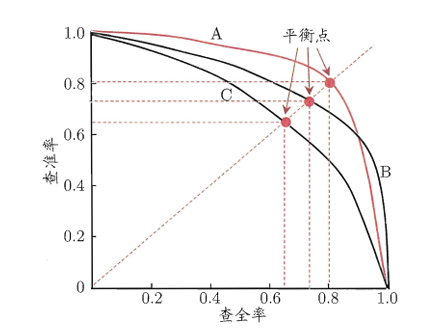
若硬要比较,比较合理的判据是比较P-R 曲线下面积的大小,但不好估算,故设计3个综合考虑查准率、 查全率的性能度量
平衡点:BEP,“查准率=查全率”的取值
F1度量:基于查准率与查全率的调和平均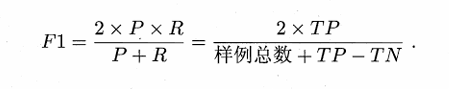
F1度量更一般形式——:能体现对查准率和查全率不同偏好,加权调和平均
其中B>0度量查全率对查准率的相对重要性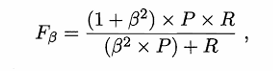
B=1,退化为F1
B>1,查全率更重要;B<1,查准率更重要 - 很多时候我们寄多个二分类混淆矩阵(2.1表),例:多次训练/测试,多个数据集训练/测试
我们希望在n个二分类混淆矩阵上综合考察查准率和查全率
最直接的做法:先在各混淆矩阵上分别计算出查准率和查全率,记为 (Pl,R1), (P2,R2),..., (Pn, Rn),在计算平均值,得到"宏查准率" (macro-P)、 "宏查全率" (macro-R),以及相应的"宏F1" (macro-F1):
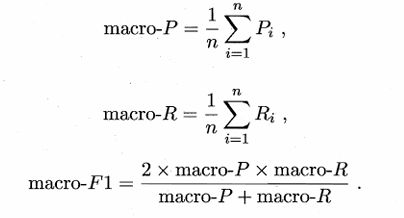
还可以将各混淆矩阵的对应元素平均,再基于这些平均值计算出"微查准率"(micro-P)、 "徽查全率" (micro-R)和"微F1" (micro-F1):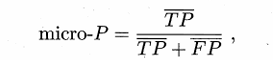
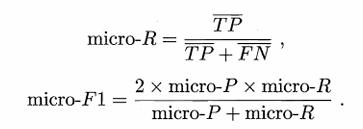
2.3.3 ROC与AUC
很多学习器是为测试样本产生一个实值或概率预测,将预测值与阈值进行比较,大于阈值为正类,小于为反类
根据这个实值或概率预测结果排序,"最可能"是正例的排在最前面, "最不可能"是正例的排在最后面,分类过程就相当于在这个排序中以 某个"截断点" (cut point)将样本分为两部分
- 不同的应用任务中,根据任务需求来采用不同的截断点;
若我们更重视"查准率",则可选择排序中靠前的位置进行截断;若更重视"查全率",则可选择靠后的位置进行截断. - 与2.3.2的 P-R 曲线相似,根据学习器的预测结果对样例进行排序,逐个把样本作为正例进行预测
与P卫-R 曲线使用查准率、查全率为纵、横轴不同,ROC 曲线的纵轴是"真正例率" (True Positive Rate,简称 TPR),横轴是"假正例率" (False Positive Rate,简称 FPR)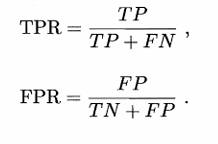
- 图2.4(a)给出了一个示意图,显然, 对角线对应于 "随机猜测" 模型,而点(0, 1)则对应于将所有正例排在所有反例之前的"理想模型"
现实任务中通常是利用有限个测试样例来绘制ROC图,只能绘制出如图2.4(b)所示的近似ROC 曲线.
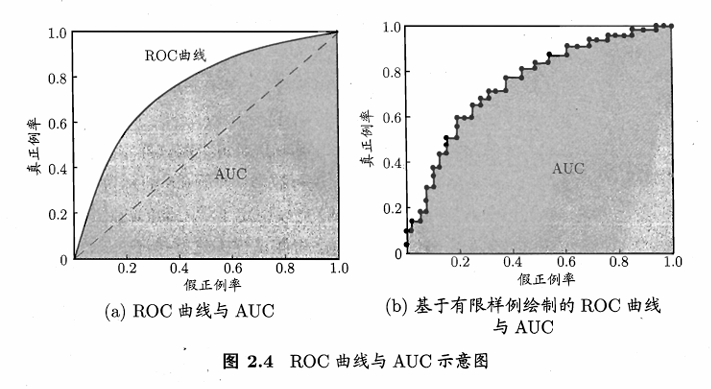
绘图过程:
给定 m+ 个正例和 m- 个反例,根据学习器预测结果对样例进行排序,然后把分类阔值设为最大, 即把所有样例均预测为反例,此时真正例率和假正例率均为0, 在坐标(0,0) 处标记一个点;
将分类阐值依次设为每个样例的预测值,即依次将每个样例划分为正例.
设前一个标记点坐标为 (x,y),当前若为真正例,坐标为
当前若为假正例,坐标为
用线段连接相邻点即得. - 比较时与P-R图相似,ROC 曲线被另一个的曲线完全"包住", 则可断言后者的性能优于前者
若发生交叉,则分情况,较为合理的判据是比较ROC 曲线下的面积,即AUC
给定m+个正例和m 个反例,令D+和D-分别表示正、反例集合, 则排序"损失" (loss)定义为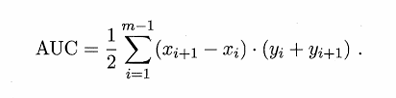
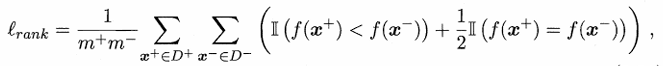
对应的是 ROC 曲线之上的面积:若 一个正例在ROC 曲线上对应标记点的坐标为 (X,y), 则x恰是排序在其之前的反例所占的比例,即假正例率.因此有
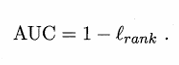

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)