hive函数及其性能优化
一、函数的分类
从输入输出角度分类
标准函数:一行数据中的一列或多列为输入,结果为单一值
聚合函数:多行的零列到多列为输入,结果为单一值
表生成函数:零个或多个输入,结果为多列或多行
从实现方式分类
内置函数
自定义函数
UDF:自定义标准函数
UDAF:自定义聚合函数
UDTF:自定义表生成函数
二、Hive内置函数
Hive提供大量内置函数供开发者使用
- 标准函数
- 字符函数
- 类型转换函数
- 数学函数
- 日期函数
- 集合函数
- 条件函数
- 聚合函数
- 表生成函数
这里整理了一些常用的函数:
2.1字符函数
- lower(String A)/Upper(String A) :将字符串A 的所有字母转换成小写/大写字母
- length(String A):返回字符串的长度
- concat(字符串A,字符串B):字符串拼接A+B
2.2数学函数
- **round(double a,int d)😗*返回对a四舍五入并保留d位小数位的值
2.3日期函数
-
date_format(date/timestamp/string ts, string fmt): 按指定格式返回时间date
如:date_format(“2016-06-22”,“MM-dd”)=06-22 -
**datediff(string enddate, string startdate)😗*计算开始时间到结束时间相差的天数
-
current_timestamp:返回当前时间戳
2.4条件函数 -
nvl(T value, T default_value):value为NULL返回default_value,否则返回value
-
if(boolean testCondition, T valueTrue,
T valueFalseOrNull):
如果testCondition
为true就返回valueTrue,否则返回valueFalseOrNull
三、UDF开发流程
-
继承UDF类或GenericUDF类
-
重写evaluate()方法并实现函数逻辑
-
编译打包为jar文件
-
复制到正确的HDFS路径
-
调用函数
具体实现的步骤:
1.java继承UDF类编写udf函数(evaluate())(一个类一个方法)
2.打fat包(包括所有依赖文件)
3.把jar包梵高linux上
–临时Udf函数
4.在hive命令行李使用add jar jar包路径即可加载到临时系统中
5.create temporary function 函数名 as ‘方法的全类名’;
–永久Udf函数
4.在Linux命令行使用Hdfs命令把Jar包上传到hdfs的路径
5.create function 函数名 as '方法的全类名’;
using jar ‘jar包的hdfs路径’;
hdfs -put –f df-hiveudf-1.0-SNAPSHOT.jar /apps/hive/functions
-- beeline中create函数并使用
CREATE FUNCTION str_lower AS 'cn.kgc.hiveudf.udf.StringLower'
USING JAR 'hdfs:////apps/hive/functions/df-hiveudf-1.0-SNAPSHOT.jar';
select str_lower(name), work_place from employee;
四、hive事务
事务(Transaction )指一组单元化操作,这些操作要么都执行,要么都不执行。
4.1:ACID特性
- Atomicity:原子性
- Consistency:一致性
- Isolation:隔离性
- Durability:持久性
4.2:特点和局限性
支持INSERT、DELETE、UPDATE(v2.2.0开始支持Merge);
文件格式只支持ORC。
局限性:
- 表必须是bucketed表
- 需要消耗额外的时间、资源和空间
- 不支持开始、提交、回滚、桶或分区列上的更新
- 锁可以为共享锁或排它锁(串联的而不是并发)
- 不允许从一个非ACID连接读写ACID表
- 使用较少
五、hive的优化设计
- 使用分区表、桶表
- 使用索引
- 使用适当的文件格式,如orc, avro, parquet
- 使用适当的压缩格式,如snappy
- 考虑数据本地化 - 增加一些副本
- 避免小文件
- 使用Tez引擎代替MapReduce
- 使用Hive LLAP(在内存中读取缓存)
- 考虑在不需要时关闭并发
查询优化
自动启动Map端Join
防止数据倾斜
set hive.optimize.skewjoin=true;
启用CBO(Cost based Optimizer)
set hive.cbo.enable=true;
set hive.compute.query.using.stats=true;
set hive.stats.fetch.column.stats=true;
set hive.stats.fetch.partition.stats=true;
启动Vectorization(矢量化)
set hive.vectorized.execution.enabled = true;
set hive.vectorized.execution.reduce.enabled = true;
六、压缩算法
1.减少传输数据量,会极大提升MapReduce性能
- 采用数据压缩是减少数据量的很好的方式
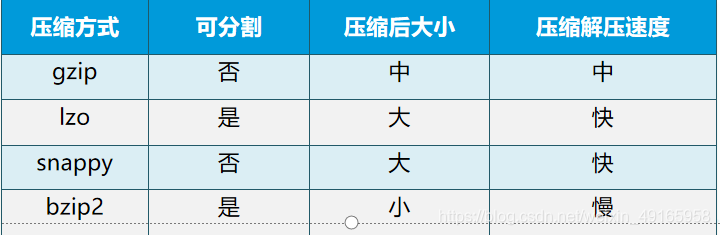
2.常用压缩方法对比

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)