登录社区云,与社区用户共同成长
邀请您加入社区
每一个 stack 版本在ambari 节点上都有对应的目录,里面存放着 hdp 各服务,像 hdfs、yarn、 mapreduce、 spark、hbase 这些,stack 版本高的, 服务相对多些。将自定义服务放到指定目录下,只需重启 ambari server 就能在添加服务界面加载出来的自定义服务,ambari 在安装自定义服务的过程中,会将 python 开发的自定义服务脚本分发到
ambari安装和常用报错,一些可适配的大数据组件
如果不想 Ambari 管理主机到机架信息,可以使用自定义到拓扑脚本。要做到这一点,必须创建自己的拓扑脚本管理分布脚本到所有主机。注意,也因为Ambari 不能访问到主机机架信息,Ambari Web 中的 heatmaps 不能显示机架。使用自定义脚本设置 Rack ID:步骤:① 浏览到 Services > HDFS > Configs② 修改 net.topology.script.fil
1、软件环境:OpenSUSE 13.1 x64MySQL 5.6.20 x642、采用RPM包安装MySQL 5.6.20[python] viewplain copy# rpm -ivh MySQL-server-5.6.20-1.sles11.x86_64.rpm # rpm -ivh MySQL
基于docker安装ambari+hdp环境,适用于测试环境;
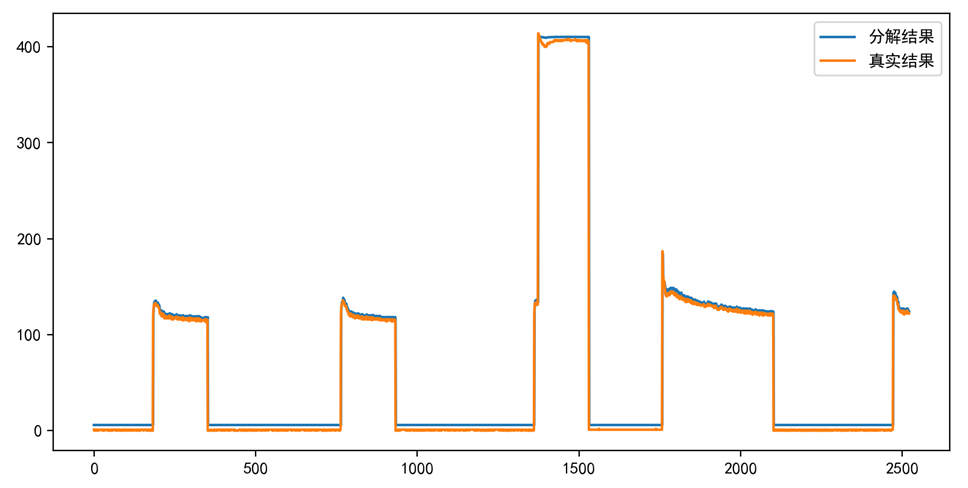
实测下来,完整模型在冰箱识别任务上F1-score比纯CNN高18.7%,但训练时间多了3倍。最后说个坑:REDD里微波炉和电炉的功率特征容易混淆,建议在预处理时加入电压谐波特征。今天咱们拿REDD数据集开刀,手把手搞个能打的组合模型,顺便拆开看看各个模块的真实作用。基于自注意力机制与粒子群算法优化的CNN-LSTM模型实现负荷分解(1DCNN-LSTM-attention-PSO)可自行删除cn
点击卡片“大数据实战演练”,选择“设为星标”或“置顶”回复“资料”可领取独家整理的大数据学习资料!回复“Ambari知识库”可领取独家整理的Ambari学习资料!Ambari 一键可视化部署新版 Apache Hadoop,跟随 Apache 各社区版本,适配国产化系统,持续迭代更新,您的不二选择!十年专业积淀,为您的数据价值保驾护航专注大数据架构和运维十年,我们拥有丰富的实战经验和强大的技术实力
现象:Ats-hbase 作为 yarn 的一个服务已正常起来。但一直存在告警The HBase application reported a 'STARTED' state in 1.773s原因:未知解决:1,su - yarn-ats2,yarn app -destroy ats-hbase3,hadoop fs -rm -R /user/yarn-ats/3.1.4.0-315/*(备注:
ansible 自动化安装ambari
基于Ambari构建大数据平台
AI 分析功能是 **DataLight**通过集成先进的第三方大模型,为用户提供智能化的数据分析和配置优化服务。通过这一功能,您可以更深入地了解您的平台运维情况,从而做出更明智的业务决策。