登录社区云,与社区用户共同成长
邀请您加入社区
XLNet是基于Transformer架构的预训练语言模型,由Google和CMU的研究团队在2019年提出。与BERT等模型相比,XLNet采用了Permutation Language Modeling(PLM)策略,能够更好地处理序列依赖性,从而在多项NLP任务上展现出更优的性能。XLNet的预训练过程不仅考虑了双向上下文,还通过自回归的方式,实现了对序列的灵活建模。
XLNet是一种基于Transformer架构的预训练语言模型,由Google和CMU的研究人员提出。与BERT等模型相比,XLNet在预训练阶段采用了自然语言的顺序性,通过双向Transformer和Permutation Language Modeling(PLM)策略,能够更好地捕捉文本的长期依赖关系和语境信息。情感强度(Sentiment Intensity)是指文本中表达的情感的强烈程度
多模态数据指的是包含多种类型信息的数据集,例如文本、图像、音频或视频等。在情感分析领域,多模态数据能够提供更全面的上下文信息,帮助模型更准确地理解情感表达。例如,一段视频中的情感不仅可以通过人物的言语内容(文本模态)来判断,还可以通过人物的表情(视觉模态)和语气(音频模态)来辅助理解。XLNet是一种基于Transformer的预训练语言模型,它通过双向训练和掩码语言建模,能够更好地理解文本的上下
在自然语言处理(NLP)领域,语言模型的发展经历了从基于统计的方法到基于深度学习的模型的转变。2018年,Google的BERT模型通过双向Transformer架构实现了对自然语言的深度理解,极大地推动了NLP技术的进步。然而,BERT在预训练阶段采用的Masked Language Model(MLM)机制,虽然能够处理双向上下文,但其在预测时的条件独立性假设限制了模型的性能。为了解决这一问题
一.Xlnet概述Xlnet,自BERT预训练-微调模式开创以来,这个自然语言处理NLP中的又一重大进展。Xlnet融合了自回归(AR,单向语言模型)、自编码(AE,双向语言模型)等语言模型特征,采用最先进的transformer特征提取器(transformer-xl,利用分割循环机制和相对位置编码进行高并发-超长文本处理),开创性地提出了排列语言模型(Permutation...
1.背景介绍1. 背景介绍自然语言处理(NLP)是人工智能领域的一个重要分支,旨在让计算机理解和生成人类自然语言。在过去的几年里,自然语言处理技术取得了显著的进展,尤其是在语言模型、机器翻译、情感分析等方面。这些成果可以追溯到2017年Google Brain团队提出的Transformer架构,后来被BERT、GPT-2、GPT-3等模型所继承和改进。在2019年,一位来自Googl...
1.背景介绍自然语言处理(NLP)是计算机科学和人工智能的一个分支,旨在让计算机理解和生成人类语言。自然语言处理的一个重要任务是文本分类,即根据文本内容将其分为不同的类别。传统的文本分类方法通常使用手工设计的特征,但这种方法的效果受限于特征的选择和提取。近年来,深度学习技术的发展使得自然语言处理取得了巨大进展。特别是,自注意力机制的出现使得模型能够捕捉到长距离的上下文信息,从而提高了文本分...
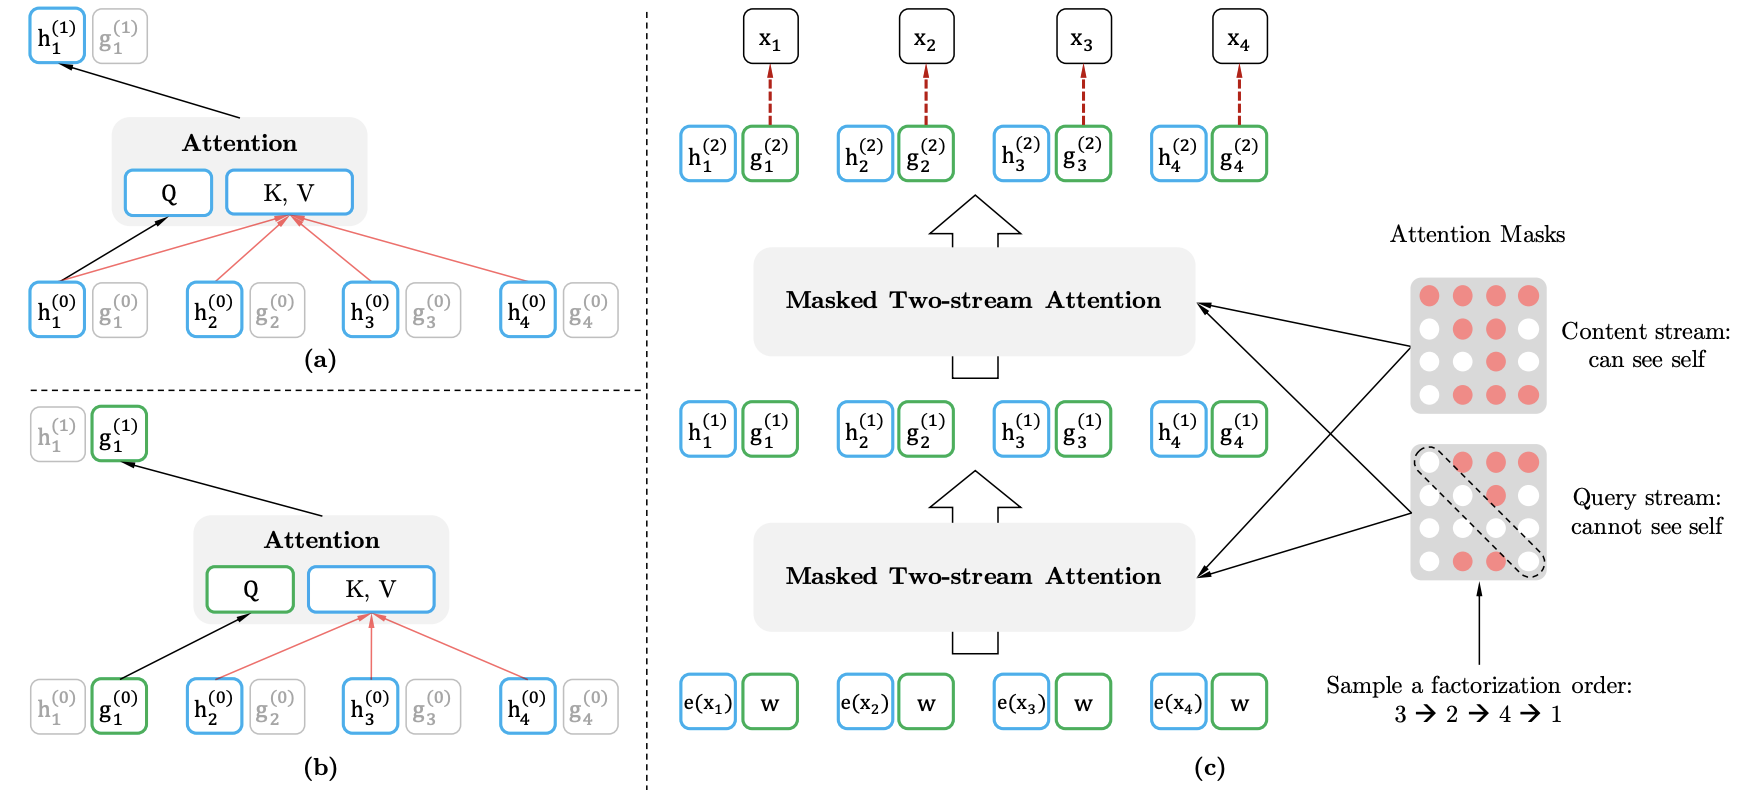
从宏观来看,XLNet 实现了站在巨人 BERT 肩膀上的新的突破,将 AR 模型和双向训练有机地结合在一起。从微观来看,XLNet 引入的几个改进方法各有所长:Permutation LM 使得语言模型在训练时可以充分利用上下文的信息;Two-stream encoding 很好地区分了预测目标和非预测目标的 attention 的计算使结果更训练更加合理;