笔记分享: 西安交通大学COMP561605自然语言理解——02. 语言模型(词袋模型)
有关 Github \text{Github} Github仓库欢迎来 Star \text{Star} Star, 期末考题
0. \textbf{0. } 0. 写在前面
1️⃣本课程总体结构
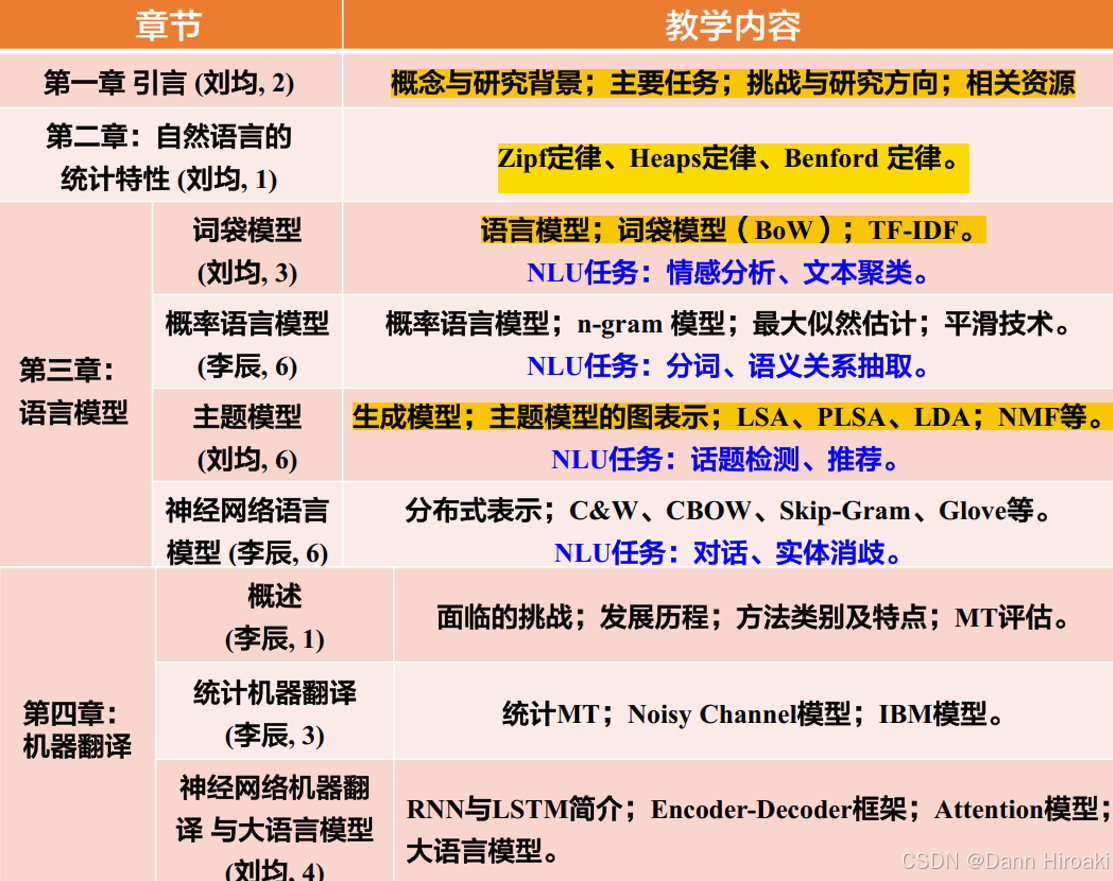
- 这门课由于由两位老师授课,个人感觉结构比较混乱
- 由于时间紧任务重经费无,所以笔记还是按 PPT \text{PPT} PPT内容和以上结构展开,即使有很多不合理的地方
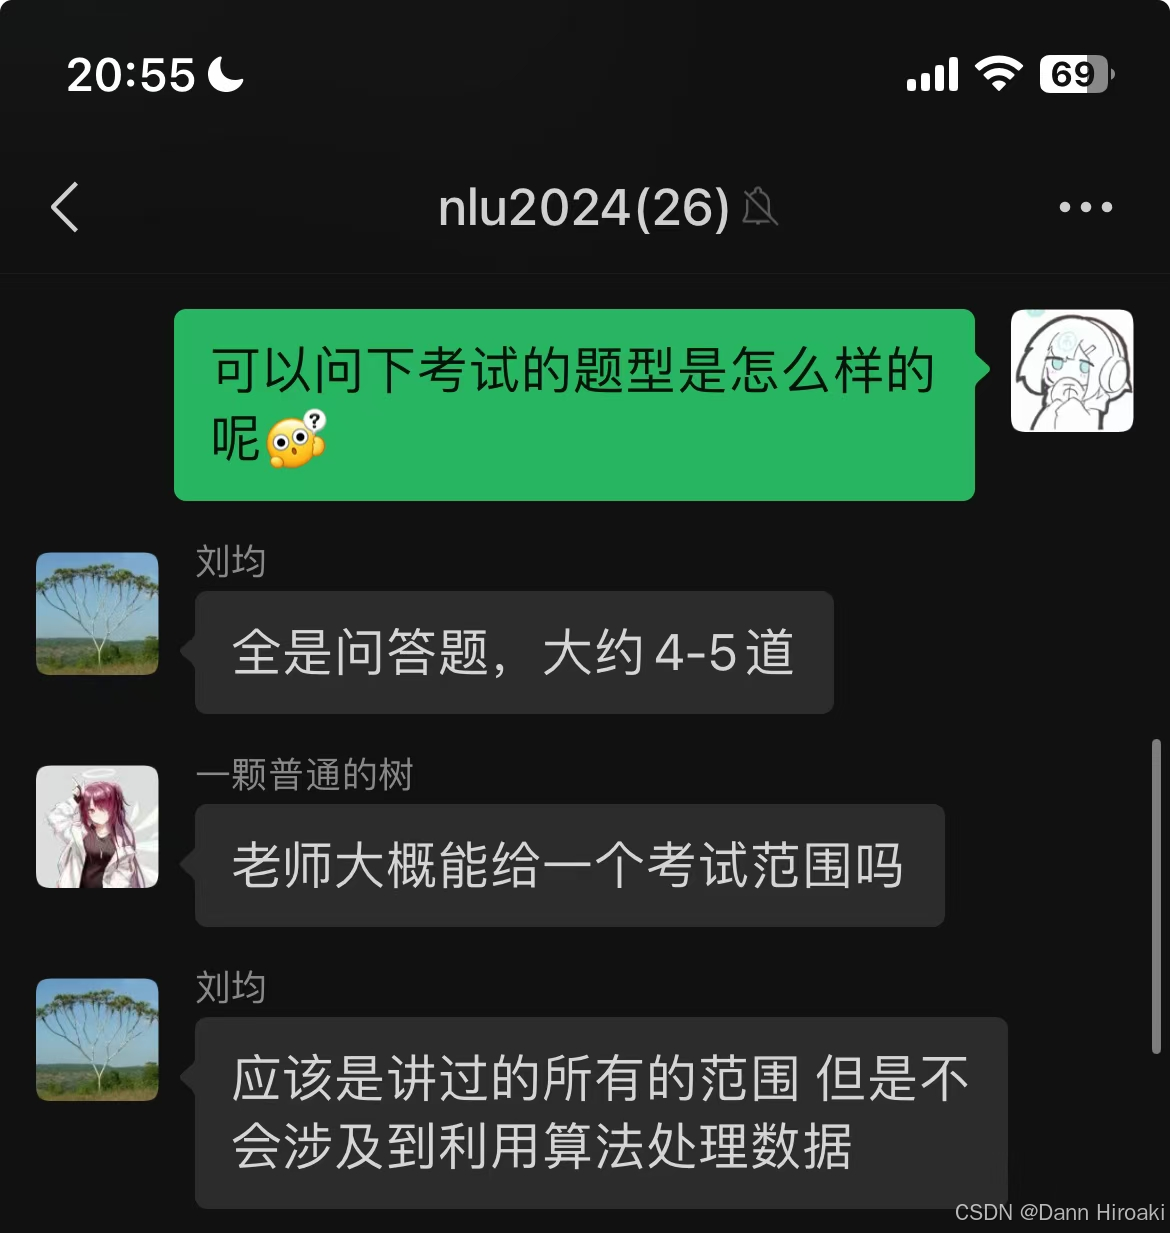
2️⃣考试有关事项
1. \textbf{1. } 1. 关于语言模型的预备知识
1.1. \textbf{1.1. } 1.1. 语言模型概念
1️⃣含义:自然语言在不同语言单位上的数学模型 → \text{→} →实现自然语言的可计算性
2️⃣类型概览
模型 含义 词袋语言模型 用文中词汇表示文本 概率语言模型 根据给定词汇序列来预测下一个词汇的概念 主题语言模型 利用非监督方法获得文档中隐含的主题 神经网络语言模型 利用神经网络学习词汇 / / /句子 / / /字符 1.2. \textbf{1.2. } 1.2. 语言模型的评价指标
1️⃣召回率与精确度
- 真假性 & \text{\&} &阴阳性:

实际\预测 C 1 \mathbf{C}_1 C1 ¬ C 1 \neg \mathbf{C}_1 ¬C1 C 1 \mathbf{C}_1 C1 True Positives(TP) \text{True Positives(TP)} True Positives(TP)真阳性 False Negatives(FN) \text{False Negatives(FN)} False Negatives(FN)假阴性 ¬ C 1 \neg \mathbf{C}_1 ¬C1 False Positives(FP) \text{False Positives(FP)} False Positives(FP)假阳性 True Negatives(TN) \text{True Negatives(TN)} True Negatives(TN)真阴性 - 召回率与精确率
- Recall= TP TP+FN \text{Recall}\text{=}\cfrac{\text{TP}}{\text{TP+FN}} Recall=TP+FNTP:表示真实阳性中/被预测为阳性的比率
- Precision= TP TP+FP \text{Precision}\text{=}\cfrac{\text{TP}}{\text{TP+FP}} Precision=TP+FPTP:表示被预测为阳性中/真实阳性的比率,一词多义会使之降低
- F1-score = 2 × Precision × Recall Precision + Recall \displaystyle\text { F1-score =}2 \text{×} \cfrac{\text { Precision } \text{×} \text { Recall }}{\text { Precision +} \text { Recall }} F1-score =2× Precision + Recall Precision × Recall :二者的调和平均
- 一词多义 & \& &一义多词
- 一词多义 → \text{→} →多义间不相关的含义被认为相关 → \text{→} →假阳性增加 →Precision \text{→Precision} →Precision降低
- 一义多词 → \text{→} →多词间相同的含义被认为是不同 → \text{→} →假阴性增加 →Recall \text{→Recall} →Recall降低
2️⃣困惑度
- 含义:反应不确定性,即困惑度越低 → \text{→} →模型预测下一个元素时选择更少 → \to →预测越准确
- 公式: Perplexit= 2 Cross-Entropy = exp ( − 1 N ∑ i = 1 N ln P ( w i ∣ w 1 i − 1 ) ) \displaystyle{}\text { Perplexit=}2^{\text {Cross-Entropy}}\text{=}\exp \left(-\cfrac{1}{N} \sum_{i=1}^N \ln P\left(w_i | w_1^{i-1}\right)\right) Perplexit=2Cross-Entropy=exp(−N1i=1∑NlnP(wi∣w1i−1))
- P ( w i ∣ w 1 i − 1 ) P\left(w_i | w_1^{i-1}\right) P(wi∣w1i−1)是谟型给定前序 w 1 i − 1 w_1^{i-1} w1i−1条件下,预测词 w i w_i wi的概率
1.3. \textbf{1.3. } 1.3. 自然语言的统计特性
1.3.1. Zipf \textbf{1.3.1. Zipf} 1.3.1. Zipf定律
1️⃣ Zipf \text{Zipf} Zipf定律
- 内容:令出现频率第 r r r高的词汇出现频率为 f ( r ) f(r) f(r),则有 f ( r ) = Const r s f(r)\text{=}\cfrac{\text{Const}}{r^{s}} f(r)=rsConst其中 s ≈ 1 s\text{≈}1 s≈1
- 含义:对于词频分布,最常见词的分布极为普遍 + + +大多数词出现频率极低
- 解释:
解释模型 含义 米勒猴实验 胡乱生成的带有字母 + + +空格的序列,词频和排名也符合幂律关系 最小努力原则 通过词频差异最小化交流的成本 优先连接机制 网络结构中,新节点倾向于连接度数更大的点,与 Zipf \text{Zipf} Zipf类似 2️⃣ Zipf \text{Zipf} Zipf定律的实验
- 符合程度: f ( r ) = Const r s → log f ( r ) = log C − s log r f(r)\text{=}\cfrac{\text{Const}}{r^{s}}\to{}\log{f(r)\text{=}}\log{C}-s\log{r} f(r)=rsConst→logf(r)=logC−slogr故可通过检测后者线性程度
- 实验结论:幂律分布很常见 + + +排名靠中间的术语会更符合
3️⃣ Zipf \text{Zipf} Zipf定律与索引
- 倒排索引:用于快速全文检索的数据结构,示例如下
- 文档
Doc1: fat cat rat rat Doc2: fat cat Doc3: fat- 构建的倒排索引
fat: Doc1 Doc2 Doc3 cat: Doc1 Doc2 rat: Doc1- 词频太高/太低的词都不适合索引,会导致返回太多/太少的文档,适中的才最有价值
- 基于 Zipf \text{Zipf} Zipf定律,去处高频 Stopword \text{Stopword} Stopword能优化倒排索引时空开销,如下为倒排索引的一个实例
1.3.2. Heaps \textbf{1.3.2. Heaps} 1.3.2. Heaps定律
1️⃣ Heaps \text{Heaps} Heaps定律

- 内容:词汇表大小 V V V与文本词数 n n n满足 V = K n β V\text{=}Kn^{\beta} V=Knβ
- 参数: 10 ≤ K ≤ 100 10\text{≤}K\text{≤}100 10≤K≤100且 0.4 ≤ β ≤ 0.6 0.4\text{≤}\beta\text{≤}0.6 0.4≤β≤0.6,当 K = 44 K\text{=}44 K=44与 β = 0.49 \beta\text{=}0.49 β=0.49最匹配
2️⃣用途:预测随文本增长词汇表 & \& &倒排索引大小的变化
1.3.1. Benford \textbf{1.3.1. Benford} 1.3.1. Benford定律(第一数字法则)
1️⃣ Benford \text{Benford} Benford定律
- 背景:在许多社会现象中,数据首位数往往分布不均(为 1 1 1概率最大 → 依次递减 \xrightarrow{依次递减} 依次递减为 9 9 9概率最小)
- 定律:令数据集中 d d d作为首字母的概率 P ( d ) = lg ( 1 + 1 d ) P(d)=\lg{\left(1+\cfrac{1}{d}\right)} P(d)=lg(1+d1), d > 9 d\text{>}9 d>9及非十进制时依旧适用
2️⃣对 Benford \text{Benford} Benford定律的一些思考
- 适用:跨数量级变化的数据集,如财务数据和自然现象
- 应用:检测数据造假、异常值、验证财务报告真实性
- 成因:还不具备完全的可解释性,大概是因为数据在对数尺的分布


2. \textbf{2. } 2. 词袋语言模型
2.1. BoW \textbf{2.1. BoW} 2.1. BoW模型
1️⃣基本步骤:以句 I love machine learning \text{I love machine learning} I love machine learning以及 Machine learning is fun \text{Machine learning is fun} Machine learning is fun为例
步骤 示例 分词 I love machine learning Machine learning is fun \text{I \\ love \\ machine \\ learning \\ }\text{Machine \\ learning \\ is \\ fun} I love machine learning Machine learning is fun 词汇表 V =[I, love, machine,lerning, is, fun] V\text{=[I, love, machine,lerning, is, fun]} V=[I, love, machine,lerning, is, fun] 向量化 第一句变为 A 1 =[1,1,1,1,0,0] A_1\text{=[1,1,1,1,0,0]} A1=[1,1,1,1,0,0]第二局变为 A 2 =[0,0,1,1,1,1] A_2\text{=[0,0,1,1,1,1]} A2=[0,0,1,1,1,1] 2️⃣特点
- 原理上:完全忽略了语法/词序,默认词与词间的概率分布独立
- 效果上:
- 优点:实现极其简单,但高效且应用广泛
- 缺点:无法区分 & \text{\&} &一义多词,如同义词替换后的两文档相似度低于实际值
2.2. TF-IDF \textbf{2.2. TF-IDF} 2.2. TF-IDF模型
1️⃣ TF-IDF \text{TF-IDF} TF-IDF值
- 计算: TF-IDF ( t , d ) =TF ( t , d ) ×IDF( t ) → { 词频TF ( t , d ) = 词 t 在文档 d 出现次数 文档 d 总词数 逆文档频IDF(t)= log 文档总数 DF ( t ) ( 包含 t 的文档数 ) + 1 \text{TF-IDF}(t,d)\text{=TF}(t,d)\text{×IDF(}t)\text{→}\begin{cases}词频\text{TF}(t,d)=\cfrac{词t在文档d出现次数}{文档d总词数}\\\\逆文档频\text{IDF(t)=}\log\cfrac{文档总数}{\text{DF}(t)(包含t的文档数)\text{+}1}\end{cases} TF-IDF(t,d)=TF(t,d)×IDF(t)→⎩ ⎨ ⎧词频TF(t,d)=文档d总词数词t在文档d出现次数逆文档频IDF(t)=logDF(t)(包含t的文档数)+1文档总数
- 含义: TF-IDF ( t , d ) \text{TF-IDF}(t,d) TF-IDF(t,d)越高,代表词 t t t对文档 d d d越重要
2️⃣ TF-IDF \text{TF-IDF} TF-IDF值改进:原始词频值往往不是所需的
- 对原始词频 TF ( t , d ) \text{TF}(t,d) TF(t,d)的改进
词频类型 公式 意义 对数 1 + log ( TF ( t , d ) ) 1\text{+}\log (\text{TF}(t,d)) 1+log(TF(t,d)) 压缩较高词频,减少其对相关性影响的夸大 增强 0.5 + 0.5 ×TF ( t , d ) max t TF ( t , d ) \displaystyle{}0.5\text{+}\cfrac{0.5 \text{×}\text{TF}(t,d)}{\max _{\mathrm{t}}\text{TF}(t,d)} 0.5+maxtTF(t,d)0.5×TF(t,d) 映射词频到 0.5 →1 0.5\text{→1} 0.5→1,防止高频词权重过大 布尔 { 1 if TF ( t , d ) > 0 0 otherwise \begin{cases}1 \,\text{ if } \text{TF}(t,d)>0 \\0 \,\text{ otherwise }\end{cases} {1 if TF(t,d)>00 otherwise 不关注具体的词频值,仅表示是否出现 平均对数 1 + log ( TF ( t , d ) ) 1 + log ( a v e t ∈ d , ( TF ( t , d ) ) ) \cfrac{1+\log \left(\text{TF}(t,d)\right)}{1+\log \left(\mathrm{ave}_{\mathrm{t∈d}}, \left(\text{TF}(t,d)\right)\right)} 1+log(avet∈d,(TF(t,d)))1+log(TF(t,d)) 使词频高的词与低的词之间的差距不会过大 - 对文档频率 DF ( t ) \text{DF}(t) DF(t)的改进: N N N是文档总数
文档频率 DF ( t ) \text{DF}(t) DF(t) 公式 意义 逆文档频率 IDF ( t ) \text{IDF}(t) IDF(t) 即 log N DF ( t ) \log{}\cfrac{N}{\text{DF}(t)} logDF(t)N者 log N DF ( t ) +1 \log{}\cfrac{N}{\text{DF}(t)\text{+1}} logDF(t)+1N 衡量词在文档集合中的稀有性 概率文档频率 ProbDF( t ) \text{ProbDF(}t) ProbDF(t) max { 0 , log N − DF ( t ) DF ( t ) } \max\left\{0,\log\cfrac{N-\text{DF}(t)}{\text{DF}(t)}\right\} max{0,logDF(t)N−DF(t)} 通过概率角度评估词的稀有性 - 归一化:对于 TF-IDF = [ TF-IDF ( t 1 , d 1 ) TF-IDF ( t 1 , d 2 ) ⋯ TF-IDF ( t 1 , d n ) TF-IDF ( t 2 , d 1 ) TF-IDF ( t 2 , d 2 ) ⋯ TF-IDF ( t 2 , d n ) ⋮ ⋮ ⋱ ⋮ TF-IDF ( t m , d 1 ) TF-IDF ( t m , d 2 ) ⋯ TF-IDF ( t m , d n ) ] \textbf{TF-IDF}\text{=}\begin{bmatrix} \text{TF-IDF}(t_1,d_1) & \text{TF-IDF}(t_1,d_2) & \cdots & \text{TF-IDF}(t_1,d_n) \\ \text{TF-IDF}(t_2,d_1) & \text{TF-IDF}(t_2,d_2) & \cdots & \text{TF-IDF}(t_2,d_n) \\ \vdots & \vdots & \ddots & \vdots \\ \text{TF-IDF}(t_m,d_1) & \text{TF-IDF}(t_m,d_2) & \cdots & \text{TF-IDF}(t_m,d_n) \\ \end{bmatrix} TF-IDF= TF-IDF(t1,d1)TF-IDF(t2,d1)⋮TF-IDF(tm,d1)TF-IDF(t1,d2)TF-IDF(t2,d2)⋮TF-IDF(tm,d2)⋯⋯⋱⋯TF-IDF(t1,dn)TF-IDF(t2,dn)⋮TF-IDF(tm,dn)
归一类型 公式 意义 余弦归一 TF-IDF × 1 ∑ i = 1 m ∑ j = 1 n [ TF-IDF ( t i , d j ) ] 2 \textbf{TF-IDF}\text{×}\cfrac{1}{\displaystyle{}\sqrt{\sum_{i=1}^{m}\sum_{j=1}^{n}[\text{TF-IDF}(t_i,d_j)]^{2}}} TF-IDF×i=1∑mj=1∑n[TF-IDF(ti,dj)]21 用于计算文档间的余弦相似度 基准归一 TF-IDF × 1 m n \textbf{TF-IDF}\text{×}\cfrac{1}{mn} TF-IDF×mn1 消除文档集合大小对权重的影响 字长归一 TF-IDF × 1 (CharLen) α \textbf{TF-IDF}\text{×}\cfrac{1}{\text{(CharLen)}^{\alpha}} TF-IDF×(CharLen)α1 适用于不同长度的文档,且 α < 1 \alpha\text{<}1 α<1 3️⃣基于 TF-IDF \text{TF-IDF} TF-IDF的余弦相似度
- TF-IDF \text{TF-IDF} TF-IDF值:对于文档 d 1 d_1 d1和 d 2 d_2 d2,词汇表长为 m m m
- TF-IDF = [ TF-IDF ( t 1 , d 1 ) TF-IDF ( t 1 , d 2 ) TF-IDF ( t 2 , d 1 ) TF-IDF ( t 2 , d 2 ) ⋮ ⋮ TF-IDF ( t m , d 1 ) TF-IDF ( t m , d 2 ) ] → 余弦归一化 [ tf-idf ( t 1 , d 1 ) tf-idf ( t 1 , d 2 ) tf-idf ( t 2 , d 1 ) tf-idf ( t 2 , d 2 ) ⋮ ⋮ tf-idf ( t m , d 1 ) tf-idf ( t m , d 2 ) ] \textbf{TF-IDF}\text{=}\begin{bmatrix} \text{TF-IDF}(t_1,d_1)&\text{TF-IDF}(t_1,d_2)\\ \text{TF-IDF}(t_2,d_1)&\text{TF-IDF}(t_2,d_2)\\ \vdots & \vdots \\ \text{TF-IDF}(t_m,d_1) & \text{TF-IDF}(t_m,d_2)\\ \end{bmatrix}\xrightarrow{余弦归一化}\begin{bmatrix} \text{tf-idf}(t_1,d_1)&\text{tf-idf}(t_1,d_2)\\ \text{tf-idf}(t_2,d_1)&\text{tf-idf}(t_2,d_2)\\ \vdots & \vdots \\ \text{tf-idf}(t_m,d_1) & \text{tf-idf}(t_m,d_2)\\ \end{bmatrix} TF-IDF= TF-IDF(t1,d1)TF-IDF(t2,d1)⋮TF-IDF(tm,d1)TF-IDF(t1,d2)TF-IDF(t2,d2)⋮TF-IDF(tm,d2) 余弦归一化 tf-idf(t1,d1)tf-idf(t2,d1)⋮tf-idf(tm,d1)tf-idf(t1,d2)tf-idf(t2,d2)⋮tf-idf(tm,d2)
- 两文档余弦值:
- 未归一化表示: sim ( d 1 , d 2 ) = ∑ j = 1 m TF-IDF ( t j , d 1 ) ⋅ TF-IDF ( t j , d 2 ) ∑ j = 1 m ( TF-IDF ( t j , d 1 ) ) 2 ⋅ ∑ j = 1 m ( TF-IDF ( t j , d 2 ) ) 2 \text{sim}(d_1, d_2) = \cfrac{\displaystyle{}\sum_{j=1}^m \text{TF-IDF}(t_j, d_1) \cdot \text{TF-IDF}(t_j, d_2)}{\displaystyle{}\sqrt{\sum_{j=1}^m (\text{TF-IDF}(t_j, d_1))^2} \cdot \sqrt{\sum_{j=1}^m (\text{TF-IDF}(t_j, d_2))^2}} sim(d1,d2)=j=1∑m(TF-IDF(tj,d1))2⋅j=1∑m(TF-IDF(tj,d2))2j=1∑mTF-IDF(tj,d1)⋅TF-IDF(tj,d2)
- 归一化表示 : sim ( d 1 , d 2 ) = ∑ j = 1 m tf-idf ( t j , d 1 ) ⋅ tf-idf ( t j , d 2 ) \displaystyle{}\text{sim}(d_1, d_2) = \sum_{j=1}^m \text{tf-idf}(t_j, d_1) \cdot \text{tf-idf}(t_j, d_2) sim(d1,d2)=j=1∑mtf-idf(tj,d1)⋅tf-idf(tj,d2)

魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 20
 0
- 0


 已为社区贡献3条内容

所有评论(0)