登录社区云,与社区用户共同成长
邀请您加入社区
MCTS 中文文本简化数据集* Big-Math 强化学习数学数据集* HAR 15 种人体动作识别数据集* DexGraspVLA 机器人抓握数据集* Fortune Telling 中文风水占卜数据集* QwQ-32B* 一键部署 YOLOv12* 一键部署 Janus-Pro-7B* Wan 2.1 文/图生视频双杀 Demo。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型,实现基于单张图像和音频生成高质量数字人视频。用户可快速搭建虚拟主播、在线教学等应用场景,显著提升内容创作效率与交互体验。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型镜像,通过LoRA微调技术实现高效个性化定制。该镜像可应用于视频制作场景,如生成高精度数字人讲话视频,适用于虚拟主播、在线教育等内容创作领域。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型,实现语音驱动的高保真面部动画生成。该镜像支持实时音频到表情的端到端映射,典型应用于虚拟主播、远程教育等需口型同步与微表情交互的视频制作场景,显著提升数字人表现力与沉浸感。
本文介绍了如何在星图GPU平台上自动化部署WAN2.2-文生视频+SDXL_Prompt风格镜像,实现高效中文提示驱动的短视频生成。依托平台能力,用户可快速完成环境配置与工作流加载,典型应用于短视频脚本分镜、电商产品动态展示等轻量级AI视频创作场景。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型,实现上传照片与音频即可生成高拟真度虚拟形象的能力。该镜像适用于企业宣传视频制作、AI讲师课程生成等典型场景,显著降低数字人内容创作门槛。
选择「NVIDIA GeForce RTX 4090」以及「PyTorch」镜像,OpenBayes 平台上线了新的计费方式,大家可以按照需求选择「按量付费」或「包日/周/月」,点击「继续执行」。进入 Demo 界面后,在「Upload your audio」处上传音频,在「Your Character」处上传视频,「Seed」可设置随机种子数。最后点击「Generate Video」生成。稍等片
三维场景生成旨在为沉浸式媒体、机器人技术、自动驾驶和具身人工智能等应用合成空间结构化、语义丰富且逼真的环境。早期基于程序规则的方法虽然提供了可扩展性,但多样性有限。近年来,深度生成模型(如GANs、扩散模型)和三维表示(如NeRF、三维高斯分布)的进步使得学习真实世界场景分布成为可能,提高了保真度、多样性和视角一致性。最近的进展如扩散模型通过将生成问题重新定义为图像或视频合成问题,弥合了三维场景生
本文介绍了如何在星图GPU平台上自动化部署Heygem数字人视频生成系统批量版webui版 二次开发构建by科哥镜像,实现本地化、高安全的AI数字人视频制作。用户无需公网上传数据,即可批量生成带唇形同步的个性化数字人讲解视频,适用于企业培训、政务播报与在线教育等场景。
SoulX-LiveTalk提出了一种14B参数的实时音频驱动虚拟形象框架,通过创新的双向蒸馏策略和全栈优化实现高效生成。该框架摒弃传统单向范式,采用双向注意力机制增强运动连贯性,结合多步自校正机制防止长周期误差累积。通过混合序列并行、并行VAE等优化技术,系统在8个H800节点上实现0.87秒启动延迟和32FPS吞吐量。实验表明,该框架在视觉质量、唇音同步和长期稳定性上均优于现有方法,训练效率提
本文介绍了如何在星图GPU平台上自动化部署WAN2.2-文生视频+SDXL_Prompt风格镜像,高效实现高质量长时长视频生成。该镜像支持最长8秒连贯视频输出,适用于广告创意、短视频内容制作等典型场景,依托首段奠基+智能续写机制保障动作与场景稳定性。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型,实现基于单张人像照片与语音输入生成口型同步、风格可控的说话视频。该镜像适用于企业宣传、在线课程讲解等典型数字人视频制作场景,显著降低高质量数字人内容的开发与部署门槛。
本文介绍了如何在星图GPU平台上自动化部署TurboDiffusion清华大学等推出的视频生成加速框架文生视频图生视频基于wan2.1wan2.2 二次webui开发构建by科哥镜像,实现文本/图像到短视频的一键生成。用户无需配置环境,开箱即用,适用于社交媒体短视频制作、产品动态展示等典型场景,显著降低AI视频创作门槛。
摘要:谢赛宁团队提出新型RAE(表示自动编码器)替代传统VAE,显著提升图像生成质量与效率。RAE采用预训练语义模型(如DINO)作为编码器,相比VAE具有三大优势:1)保留全局语义信息;2)支持更高维度表示;3)计算速度提升3-6倍。配合改进的DiT模型(调整网络宽度、噪声策略等),在ImageNet测试中取得FID 1.13的突破性成绩,训练速度较传统方法快47倍。该技术通过"语义优
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型,实现高质量说话视频生成。该镜像支持输入人物图像、语音及英文提示词,一键输出带自然微表情与肢体动作的高清视频,典型应用于企业宣传、在线课程讲解等标准化视频内容生产场景。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型,实现基于语音驱动的数字人视频生成功能。用户只需上传一张照片和一段音频,即可生成口型同步、表情自然的高清视频,适用于短视频创作、虚拟主播等场景,显著提升内容生产效率。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型镜像,实现端到端的文本+图像+音频驱动数字人视频生成功能。用户无需手动配置环境,即可快速生成表情丰富、口型精准的动态数字人视频,适用于虚拟主播、在线教育讲解、企业宣传等典型场景。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型镜像,实现基于语音和图像输入的实时数字人视频生成功能。用户可通过该平台快速搭建高性能推理环境,典型应用于虚拟主播、AI讲师等场景,显著提升内容创作效率与交互体验。
本文介绍了如何在星图GPU平台上自动化部署Live Avatar阿里联合高校开源的数字人模型,实现基于单张人像照片与音频输入的实时数字人视频生成。用户可快速构建可交互的数字人应用,适用于企业虚拟主播、在线教育讲师、AI客服等典型场景,显著降低高质量数字人内容生产门槛。
AIGC文生视频的调研
EchoMimic 是一个由阿里巴巴蚂蚁集团开发的开源 AI 数字人项目,通过可编辑地标调节实现逼真的音频驱动肖像动画,它能够将静态图像转化为具有动态语音和表情的数字人像 。本文将详细介绍该模型如何实现本地部署。
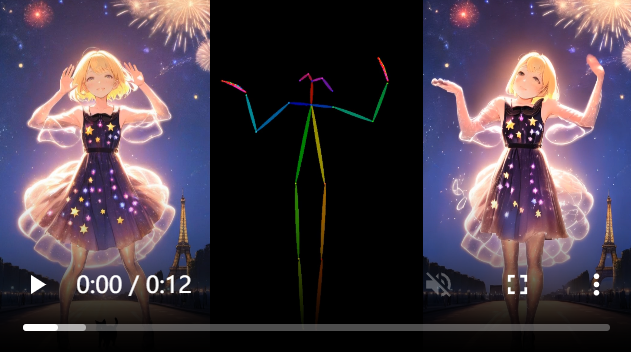
MusePose是一个基于扩散和姿势引导的虚拟人视频生成框架。该模型能够根据给定的姿势序列,生成参考图中人物的舞蹈视频。本文将带领大家一步步实现该模型的本地部署。
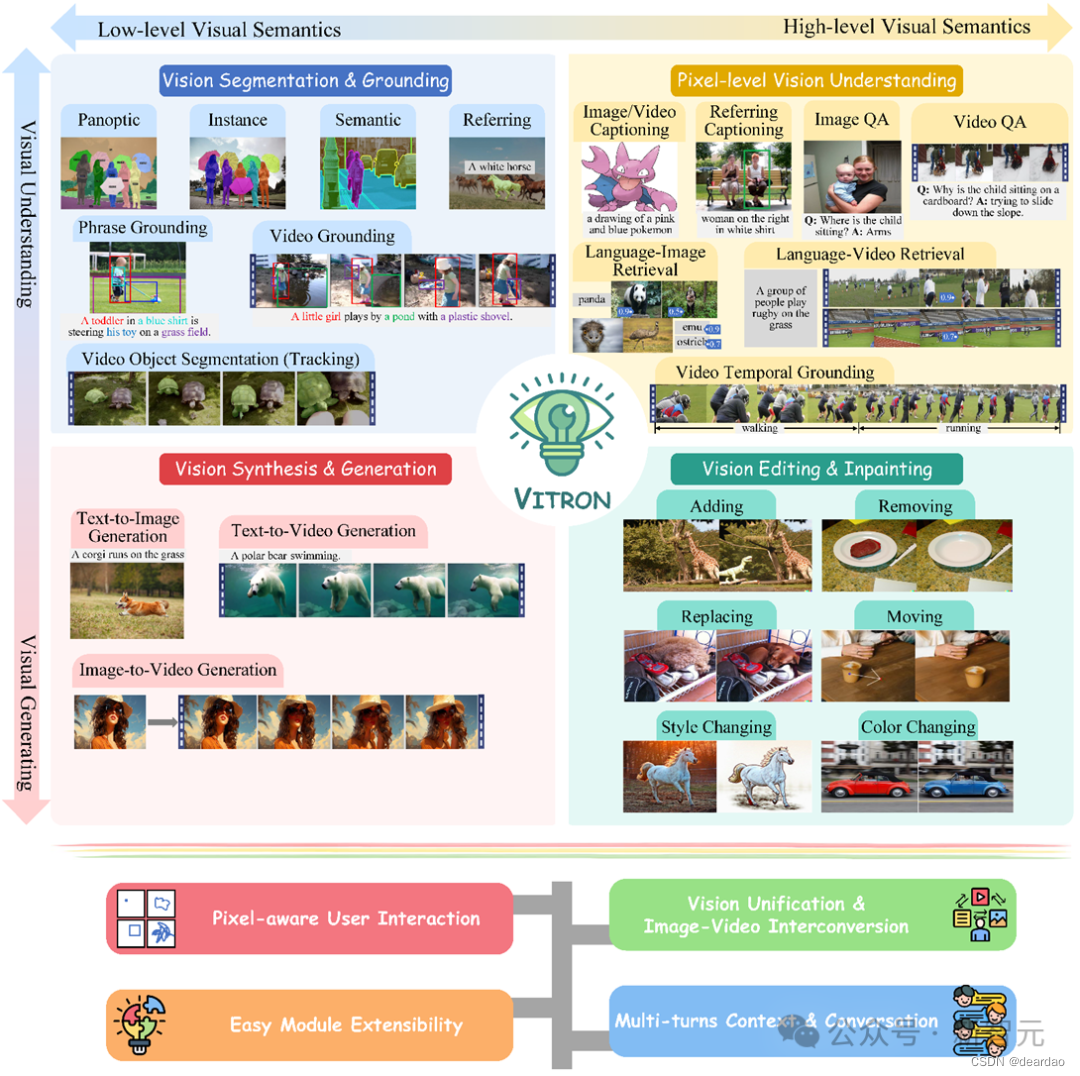
一方面,研究人员尝试深化MLLMs对视觉的理解,从粗略的实例级理解过渡到对图像的像素级细粒度理解,从而实现视觉区域定位(Regional Grounding)能力,如GLaMM、PixelLM、NExT-Chat和MiniGPT-v2等。部分研究已经开始研究让MLLMs不仅理解输入视觉信号,还能支持生成输出视觉内容。Vitron作为一个统一的像素级视觉多模态大语言模型,实现了从低层次到高层次的视觉
EasyAnimate 是阿里云推出的基于 DiT 的高质量长视频生成框架,具备视频预处理、VAE 训练、DiT 训练、LoRA 训练、模型推理与评估等功能。通过少量图片进行 LoRA 微调,实现视频风格转换,增强系统扩展性和完整性。
Open-Sora是一个开源的视频生成模型,旨在生成高保真度的视频内容。它支持广泛的视觉生成任务,包括文本到图像、文本到视频和图像到视频的生成。该模型利用先进的深度学习架构和训练/推理技术,能够生成长达15秒、分辨率达720p、任意宽高比的灵活视频。其中的关键创新包括空间-时间扩散变换器(STDiT)和高度压缩的3D自编码器。通过这个项目,研究人员希望促进AI内容创作领域的创新、创造力和包容性。开