登录社区云,与社区用户共同成长
邀请您加入社区
Align-DS-V是DeepSeek-R1-Distill-Llama-8B中的一个实验性视觉语言模型,由PKU-Alignment团队和香港科技大学共同开发,重点是通过全模态对齐增强推理能力。
MCTS 中文文本简化数据集* Big-Math 强化学习数学数据集* HAR 15 种人体动作识别数据集* DexGraspVLA 机器人抓握数据集* Fortune Telling 中文风水占卜数据集* QwQ-32B* 一键部署 YOLOv12* 一键部署 Janus-Pro-7B* Wan 2.1 文/图生视频双杀 Demo。
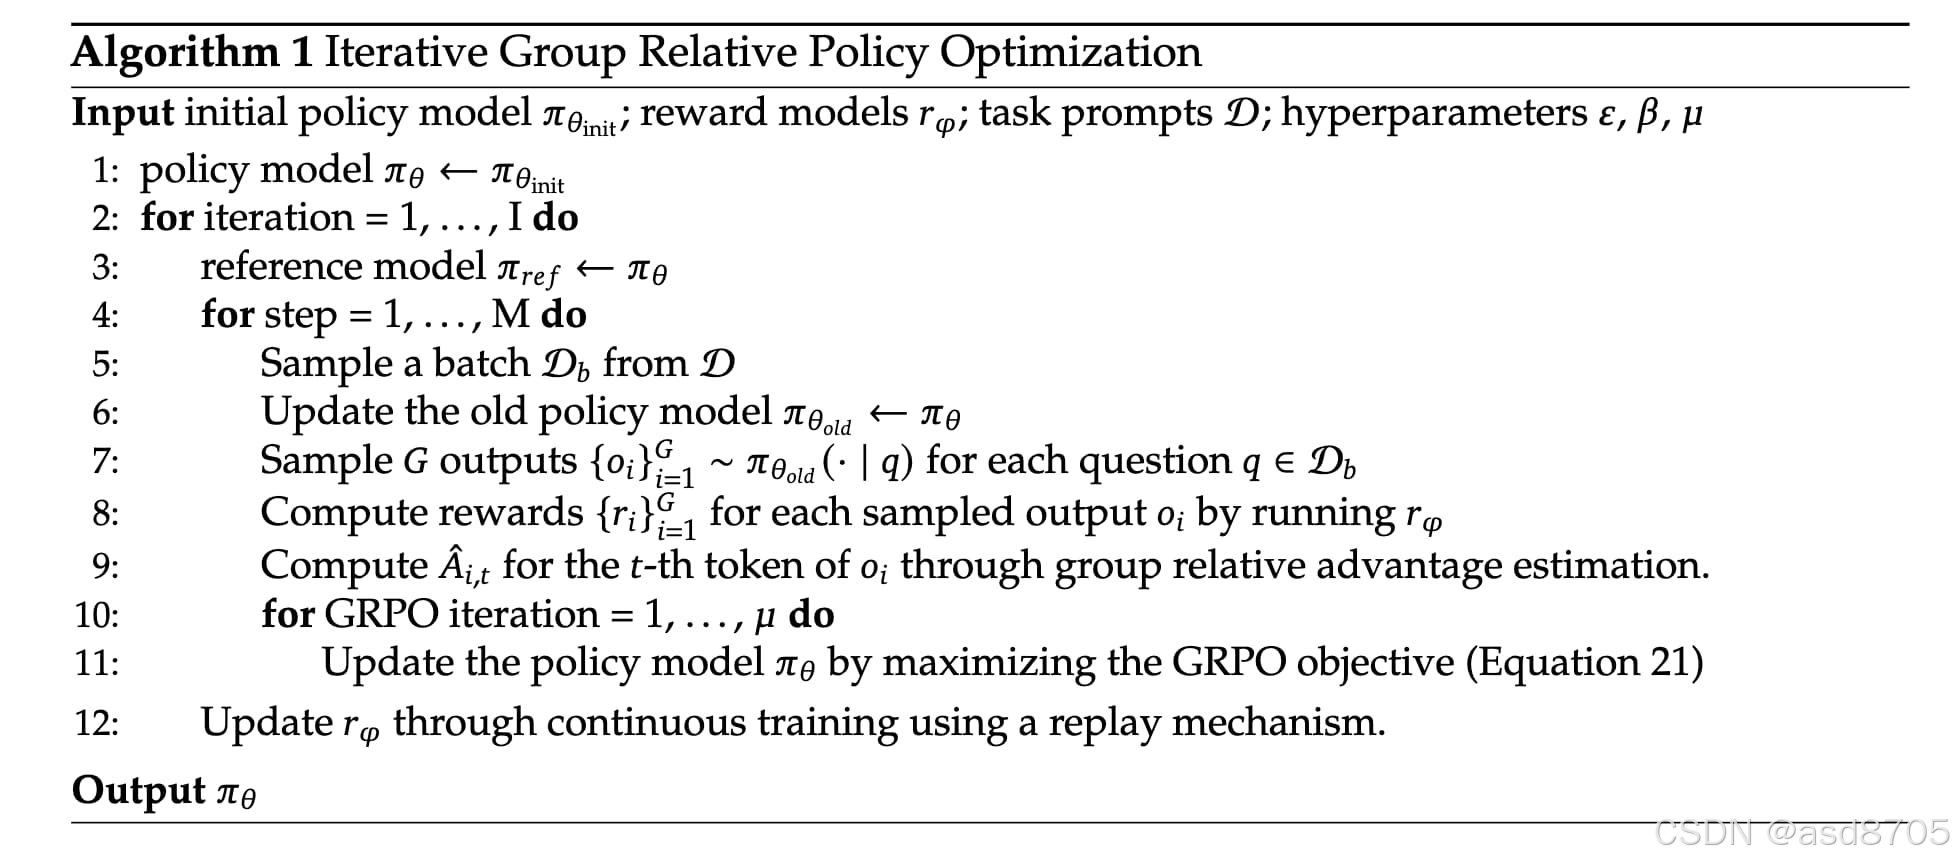
在我们的迷你R1实验中,我们使用了GRPO,并采用了两个基于规则的奖励,但已经需要大量的计算资源:4块H100 GPU运行6小时,才能完成一个30亿参数模型的450个训练步骤。在这个阶段,DeepSeek-R1-Zero(DeepSeek-R1的首次测试)学会了在没有任何人类反馈或描述如何进行操作的数据的情况下,通过重新评估其初始方法,为问题分配更多的思考时间。模型开始学习一种新的“格式”,它以类
此外,在设备故障预测和维护方面,DeepSeek 能够根据设备运行过程中的历史数据和实时状态,学习到设备故障发生的模式和规律,提前预测可能出现的故障,并采取相应的维护措施,降低设备停机时间,保障生产的连续性。例如,在复杂的物流调度场景中,传统强化学习算法可能需要经过数千次甚至数万次的尝试才能找到一个较为合理的调度方案,而 DeepSeek 利用其高效的感知模块和策略网络,能够在短时间内分析大量的物
连接Dify与DeepSeek大模型时,合理的网络架构至关重要。通过HTTPS加密、IP白名单、反向代理和流式支持等配置,确保通信安全稳定。避免常见问题如超时、空响应和单点故障,结合API网关与监控体系,实现高效、可扩展的AI应用部署。
DeepSeek的MLA(多头潜在注意力)机制通过创新性的压缩存储方式大幅降低显存占用。与传统MHA(多头注意力)需要存储完整的K/V值不同,MLA将输入压缩为2个数的"压缩包"存储,利用矩阵结合律实现计算时无需还原原始数据。这种设计将显存占用降至MHA的1/4,同时保持相近性能表现。在初始化方面,预训练阶段采用标准初始化保证模型学习能力,而微调阶段则采用LoRA的特殊初始化策
本文介绍了如何在星图GPU平台上自动化部署【ollama】DeepSeek-R1-Distill-Qwen-7B镜像,构建RAG增强问答系统。通过集成LangChain与本地知识库(如PDF技术文档),该模型可实现精准、可溯源的中文技术问答,适用于企业内部文档智能检索与客服应答等典型场景。
DeepSeek大模型曾以低成本、高性能、开源挑战全球AI巨头,后陷入技术争议、数据泄露、安全攻击等困境。文章分析其当前处境与东山再起之路,包括技术创新、商业模式探索和信任重建。作为中国AI产业代表,DeepSeek的成败关乎整个中国AI能否突破,其故事值得所有技术人关注和学习。
泛微公司全面接入DeepSeek大模型,通过其数智大脑Xiaoe.AI为客户构建"大模型+小模型+智能体"解决方案,提升组织管理智能化水平。
文章详细介绍了如何使用Docker+Dify+DeepSeek组合本地部署大模型并构建私有知识库的完整流程。从Docker安装、Dify部署、DeepSeek本地配置,到知识库创建和应用搭建,为读者提供了详细的步骤指导。通过这种方式,用户可以将自己的专业知识资料融入大模型,创建个性化的AI助手,实现高效的信息查询和知识管理,无需依赖公有云服务。
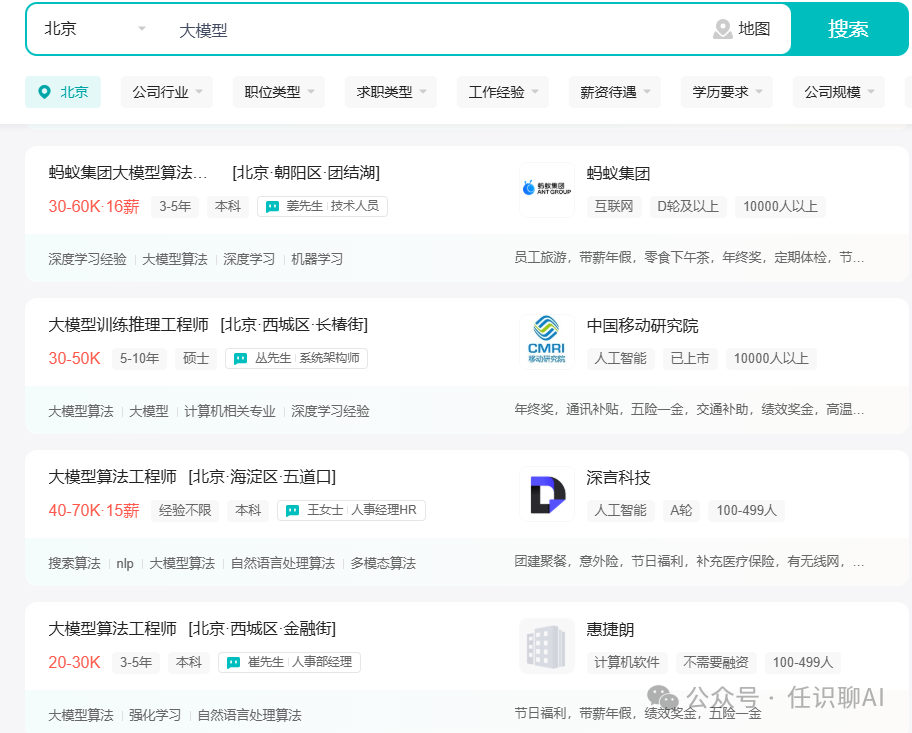
最近有朋友说,想转行ai赛道,做大模型之类的工作,不知道有哪些岗位。今天就来聊聊,AI大模型有哪些方向,新人怎么转行大模型赛道,让大家少走弯路,早日在AI领域如鱼得水!其实,在招聘网站上搜搜 “大模型”,看看那些招聘要求,就能大概了解大模型工程师都有哪些方向了。主要分为下面这四类:数据治理方向:大模型数据工程师,主要负责爬虫、数据清洗、ETL、Data Engine、Pipeline 这些工作。简
DeepSeek通过多语言情感分析技术提升跨境客服体验,结合XLM-R模型与工程化实践,实现情绪精准识别与服务优化。
本文介绍了如何在星图GPU平台上自动化部署DeepSeek-R1-Distill-Llama-8B镜像,高效支撑中医学知识推理任务。该轻量级大模型可本地运行,典型应用于GPQA风格的中医证候辨证分析,如肝胆湿热证的多证据交叉验证与治法方剂推导,助力专业领域可解释AI辅助诊断。
2025年,中国AI公司DeepSeek凭借低成本高性能的大模型技术惊艳全球,创始人梁文锋低调行事引发关注。公司通过财务独立性、前瞻性算力储备和极致工程效率,在算力受限环境下实现技术突破。其开源策略虽未积极商业化,却意外推动了中国AI应用市场爆发,被《自然》评为年度十大人物,估值超万亿。DeepSeek证明技术本身可以成为最佳传播媒介,为中国AI产业提供了全新发展路径。从现象级爆红到创始人刻意低调
DeepSeek图像生成技术通过多模态融合与扩散模型,实现广告素材的高效智能生产,支持批量生成、品牌一致性控制及自动化流程集成,显著提升创意效率与投放效果。
基于华为昇腾910B和vllm-ascend镜像,完成DeepSeek-R1-Distill-Qwen-32B大模型的容器化部署。涵盖环境准备、镜像拉取、Ascend Docker Runtime安装、模型挂载及docker-compose启动全流程,支持多卡并行与高内存利用率推理。
这三个代码案例展示了DeepSeek在智能开发领域的强大功能,包括代码生成、代码审查和代码优化。这些功能不仅能够显著提高开发效率,还能提升代码质量和系统性能,是现代软件开发中不可或缺的工具。
AOne零信任终端强势搭载DeepSeek R1-671B、R1-70B大模型,确保用户享受最先进的AI技术,无需本地部署,即开即用,极致的交互体验,助力用户高效完成任务。即日起,AOne用户升级客户端至最新版本即可免费体验全栈自主可控的国产化DeepSeek 671B满血版、70B版大模型!基于AOne优质的边缘网络TB级资源和全球应用安全加速能力,构建AI专属传输通道。万卡级异构资源池动态扩容
之前有写过一些生成ppt、xmind的结合北京大学、清华大学等也是出了好多使用的操作使用链接:https://pan.quark.cn/s/0ddc32416ae3。
文章摘要:本文全面探讨了大模型(LLMs)的基础、进阶、微调及LangChain应用等多个方面。基础部分涉及主流开源模型体系、prefix LM与causal LM的区别、涌现能力及大模型架构。进阶部分讨论了LLMs的复读机问题、模型选择、长文本处理等。微调部分详细介绍了全参数微调、SFT指令微调、领域模型训练等技术与挑战。LangChain部分则涵盖了文档对话、模型幻觉处理、核心概念及使用技巧。
MaxCompute MaxFrame正式推出AI Function功能,一键调用大模型处理海量数据!AI Function引入开箱即用的Qwen 2.5 和 Deepseek-R1-Distill-Qwen 等系列大模型,直接调用接口就可以对 MaxCompute表中的海量数据使用大模型进行离线处理。
DeepSeek 再次抛出重磅炸弹:Engram 架构。这不只是一个新的模型参数(27B),而是一种对 Transformer 底层逻辑的“外科手术”。它指出大模型 70% 的参数都在“死记硬背”事实,极其浪费。Engram 的核心是“条件记忆(Conditional Memory)”,复活了古老的 N-gram 技术,把死知识从昂贵的 GPU 计算中剥离,扔进廉价的内存(RAM)里查表。这不仅是
DeepSeek视频分析技术融合时空注意力网络与端边云协同架构,通过轻量化模型、多模态融合和高效推理引擎实现安防场景的高精度实时行为识别与跨摄像头跟踪。
本文介绍了如何在星图GPU平台上自动化部署🧠 DeepSeek-R1 (1.5B) - 本地逻辑推理引擎镜像,实现无需GPU的轻量级本地逻辑推理。该镜像专为CPU优化,可在20GB内存设备上稳定运行,典型应用于数学解题、代码生成与逻辑谬误识别等需要清晰思维链的场景,助力教育、开发与研究场景高效落地。
本地电脑部署主要适用于以下5种场景第一、设备性能较强,配备独立显卡,能够支撑高效运行。第二、需要处理敏感数据,对数据安全性有较高要求,以防泄露。第三、需要与本地工作流程紧密结合,应对频繁或复杂的任务处理。第四、日常频繁使用,且 API 调用成本较高,本地部署有助于降低成本。第五、希望在开源模型基础上,进行个性化定制和优化。
大语言模型(LLM)API调用是边缘智能的关键能力,其本质是基于HTTP/HTTPS协议的RESTful服务集成。理解TLS握手、JSON解析、流式响应(SSE)处理及内存受限环境下的网络可靠性设计,是MCU接入云AI服务的核心原理。该技术具备低硬件门槛、高部署灵活性和强工程可维护性,广泛应用于智能终端、工业HMI、教育开发板等嵌入式场景。本文聚焦ESP32-S2/S3平台,详解如何在FreeRT
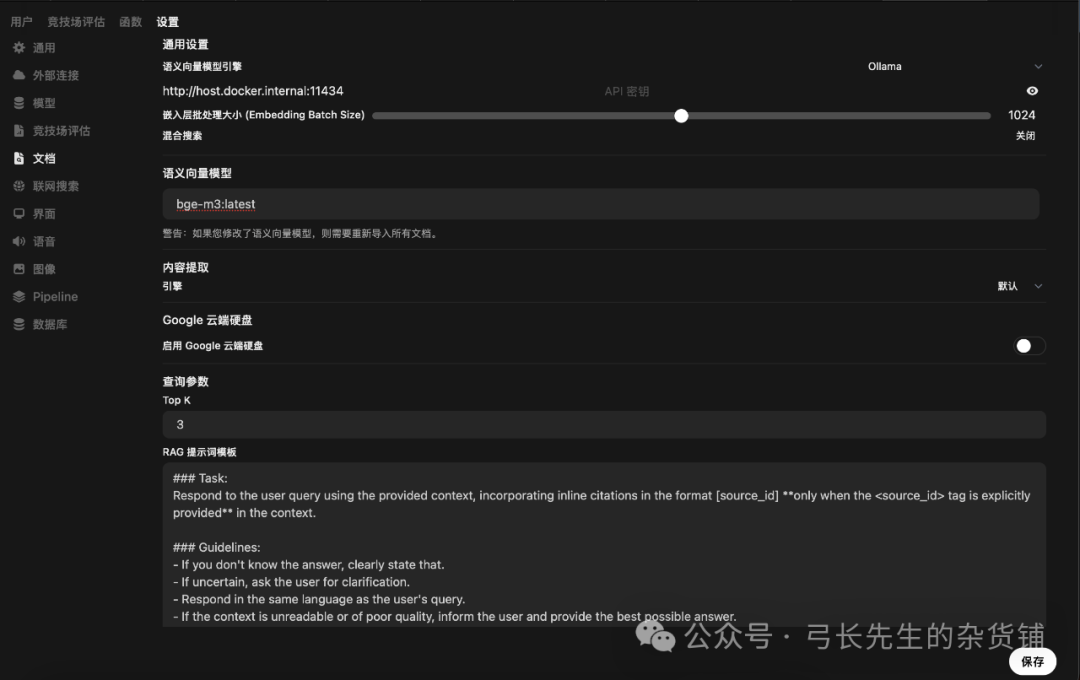
上篇文章介绍了如何通过 Ollama 在本地部署 LLM,以及如何通过 Open WebUI 更友好地使用大模型。实际使用中,我发现 DeepSeek R1 的 14B 模型在文字处理方面已经能够提供很好的体验,对系统资源占用也较小,是一个不错的平衡选择。但有时,我希望能够指定一些特定信息,辅助模型进行更精准的回答,也希望模型能够对特定文档进行分析和整理,这时我们就需要一个知识库系统来提供支持。
随着人工智能技术的快速发展,大语言模型如ChatGPT和DeepSeek在科研领域的应用正在为科研人员提供强大的支持。这些模型通过深度学习和大规模语料库训练,能够帮助科研人员高效地筛选文献、生成论文内容、进行数据分析和优化机器学习模型。