笔记分享: 西安交通大学COMP561605自然语言理解——08. NLU任务(机器翻译)
文章目录
有关 Github \text{Github} Github仓库欢迎来 Star \text{Star} Star, 期末考题
0. \textbf{0. } 0. 写在前面
1️⃣本课程总体结构
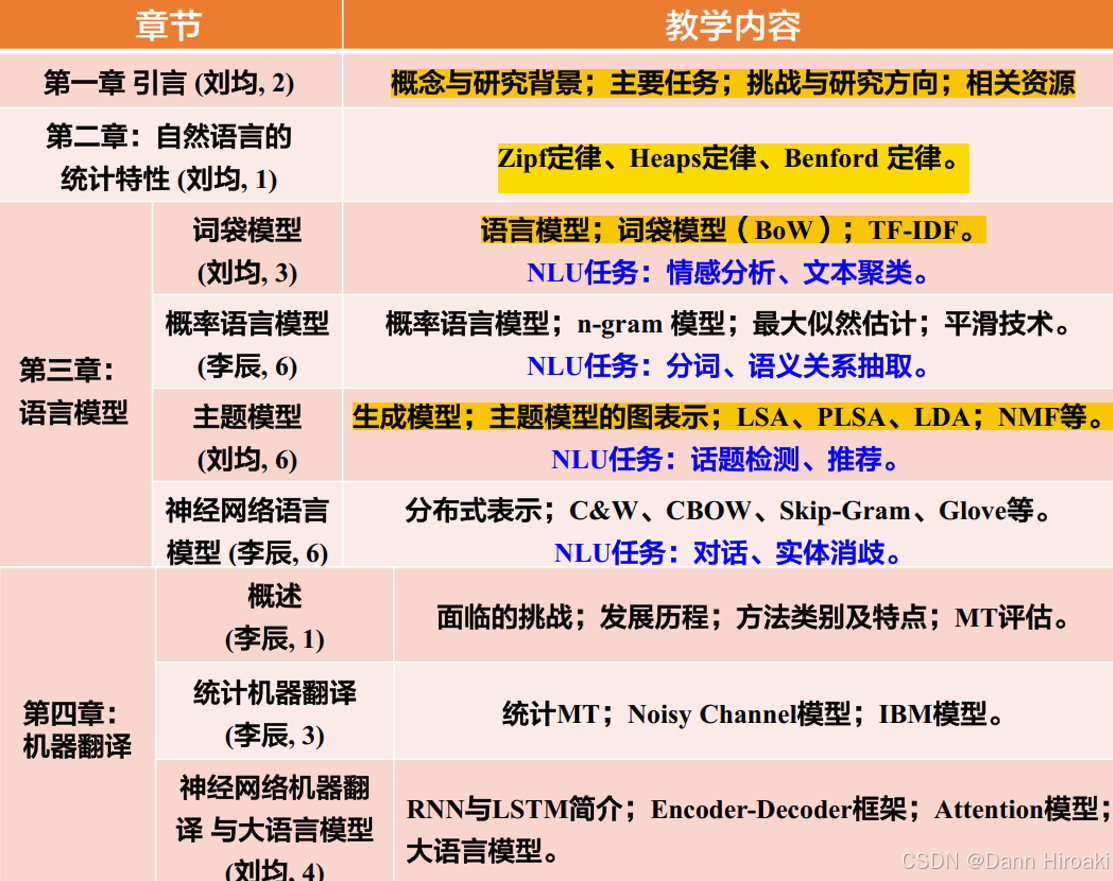
- 这门课由于由两位老师授课,个人感觉结构比较混乱
- 由于时间紧任务重经费无,所以笔记还是按 PPT \text{PPT} PPT内容和以上结构展开,即使有很多不合理的地方
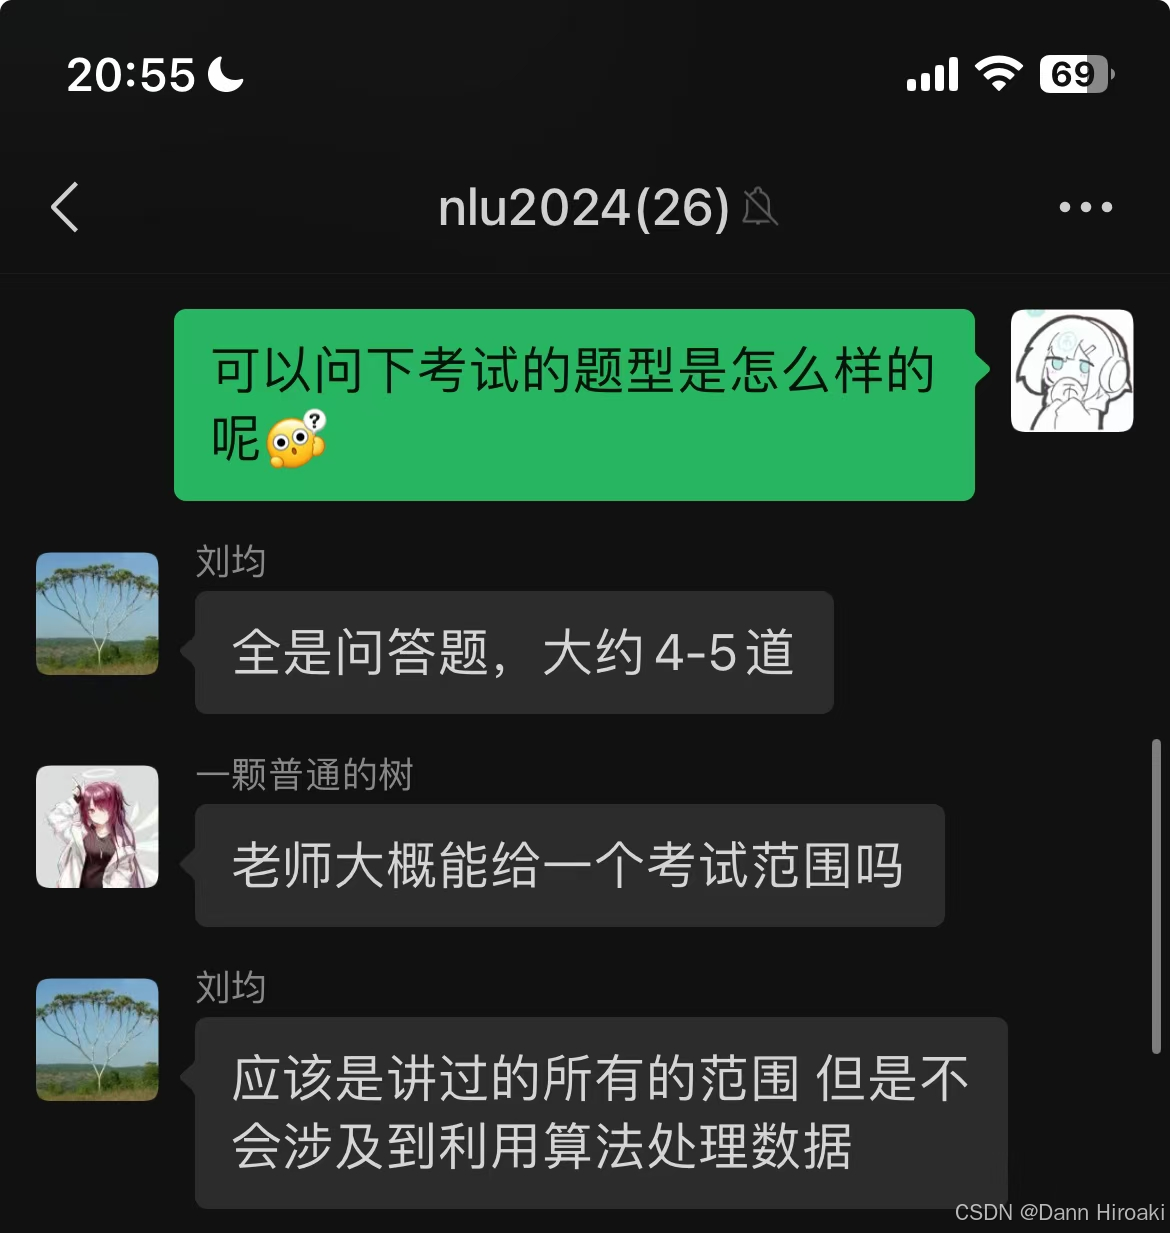
2️⃣考试有关事项
1. \textbf{1. } 1. 概述与统计机器翻译
1️⃣基于规则的机器翻译 (RBMT) \text{(RBMT)} (RBMT)
- 结构:规则库(词法 + + +句法 + + +语义),词典(源-目标语言的对应关系)
- 流程:分析 → 词法 / 句法 / 语义分析 \xrightarrow{词法/句法/语义分析} 词法/句法/语义分析中间表示(如中间树) → 目标转换 \xrightarrow{目标转换} 目标转换生成
2️⃣基于统计的机器翻译 (SMT) \text{(SMT)} (SMT)
- 含义:
- 目标:给定源语言句子 → \text{→} →找到目标语言中最可能的翻译
- 原理:基于 P ( TL ∣ OL ) = P ( OL ∣ TL ) P ( TL ) P(\text{TL}|\text{OL})\text{=}P(\text{OL}|\text{TL})P(\text{TL}) P(TL∣OL)=P(OL∣TL)P(TL),从而构建以下两个模型并最大化 P ( OL ∣ TL ) P(\text{OL}|\text{TL}) P(OL∣TL)
Item \textbf{Item} Item 含义 释义 P ( TL ) P(\text{TL}) P(TL) 语言模型的概率 表示目标语言句子在目标语言中的自然性 P ( OL ∣ TL ) P(\text{OL}|\text{TL}) P(OL∣TL) 翻译模型的概率 表示从目标语言句子生成源语言句子的概率 - 几种 SMT \text{SMT} SMT:
- Noisy Channel \text{Noisy Channel} Noisy Channel模型:认为源语言 ← 噪声信道处理 \xleftarrow{噪声信道处理} 噪声信道处理目标语言,而翻译为该过程逆向
- IBM \text{IBM} IBM模型:核心在于对齐机制,通过最大化对齐概率以找到源 ↔ \xleftrightarrow{} 目标的最佳对应
2. RNN \textbf{2. RNN} 2. RNN与 LSTM \textbf{LSTM} LSTM
2.0. \textbf{2.0. } 2.0. 一些前情提要
1️⃣关于隐状态
- 含义:对当前 x t → 认为基于过去的观测 x t ∼ P ( x t ∣ x t - 1 , … , x 1 ) → 将过去观测总结为 h t - 1 x t ∼ P ( x t ∣ h t - 1 ) x_t\xrightarrow{认为基于过去的观测}x_t\sim{}P\left(x_t| x_{t\text{-}1},\ldots,x_1\right)\xrightarrow{将过去观测总结为h_{t\text{-}1}}x_t\sim{}P\left(x_t| h_{t\text{-}1}\right) xt认为基于过去的观测xt∼P(xt∣xt-1,…,x1)将过去观测总结为ht-1xt∼P(xt∣ht-1)
- 更新:当前隐含状态就是当前值 + + +上一隐藏状态,即 h t = f ( x t , h t - 1 ) h_t\text{=}f(x_t,h_{t\text{-}1}) ht=f(xt,ht-1)
2️⃣无隐藏状态的神经网络
- 输入层:给定一批的 n n n个 d d d维样本 X ∈ R n × d \textbf{X}\text{∈}\mathbb{R}^{n\text{×}d} X∈Rn×d
- 隐藏层: X ∈ R n × d → 定激活函数 ϕ , h 个隐藏单元 权重参数 W x h ∈ R d × h , 偏置参数 b h ∈ R 1 × h \textbf{X}\text{∈}\mathbb{R}^{n\text{×}d}\xrightarrow[定激活函数\phi,\,h个隐藏单元]{权重参数\textbf{W}_{xh}\text{∈}\mathbb{R}^{d\text{×}h},\,偏置参数\textbf{b}_h\text{∈}\mathbb{R}^{1\text{×}h}} X∈Rn×d权重参数Wxh∈Rd×h,偏置参数bh∈R1×h定激活函数ϕ,h个隐藏单元输出 H = ϕ ( XW x h + b h ) ∈ R n × h \textbf{H}\text{=}\phi(\textbf{XW}_{xh}\text{+}\textbf{b}_h)\text{∈}\mathbb{R}^{n\text{×}h} H=ϕ(XWxh+bh)∈Rn×h
- 输出层:
- 原始输出: H ∈ R n × h → q 个隐藏单元 权重参数 W h q ∈ R h × q , 偏置参数 b q ∈ R 1 × q \textbf{H}\text{∈}\mathbb{R}^{n\text{×}h}\xrightarrow[q个隐藏单元]{权重参数\textbf{W}_{hq}\text{∈}\mathbb{R}^{h\text{×}q},\,偏置参数\textbf{b}_q\text{∈}\mathbb{R}^{1\text{×}q}} H∈Rn×h权重参数Whq∈Rh×q,偏置参数bq∈R1×qq个隐藏单元输出 O = ( HW h q + b q ) ∈ R n × q \textbf{O}\text{=}(\textbf{HW}_{hq}\text{+}\textbf{b}_q)\text{∈}\mathbb{R}^{n\text{×}q} O=(HWhq+bq)∈Rn×q
- Softmax \text{Softmax} Softmax输出: Softmax ( O ) R n × q → \text{Softmax}(\textbf{O})\mathbb{R}^{n\text{×}q}\text{→} Softmax(O)Rn×q→为概率分布(矩阵所有元素和为 1 1 1)
2.1. \textbf{2.1. } 2.1. 有隐藏状态的神经网络: RNN \textbf{RNN} RNN
1️⃣ RNN \text{RNN} RNN结构
- 输入层:输入序列在时间步 t t t处的 n n n个样本 X t ∈ R n × d \textbf{X}_t\text{∈}\mathbb{R}^{n\text{×}d} Xt∈Rn×d
- 隐藏层:全连接 + + +带激活函数 ϕ \phi ϕ,输出 H t = ϕ ( X t W x h + H t - 1 W h h + b h ) ∈ R n × h \textbf{H}_t\text{=}\phi(\textbf{X}_t\textbf{W}_{xh}\text{+}\textbf{H}_{t\text{-}1}\textbf{W}_{hh}\text{+}\textbf{b}_h)\text{∈}\mathbb{R}^{n\text{×}h} Ht=ϕ(XtWxh+Ht-1Whh+bh)∈Rn×h
- W h h ∈ R h × h \textbf{W}_{hh}\text{∈}\mathbb{R}^{h\text{×}h} Whh∈Rh×h权重参数:描述了如何在当前时间步,使用上一时间步隐藏变量
- 另一个关注点: X t W x h + H t - 1 W h h \textbf{X}_t\textbf{W}_{xh}\text{+}\textbf{H}_{t\text{-}1}\textbf{W}_{hh} XtWxh+Ht-1Whh相当于 ( X t ↔ 拼接 H t - 1 ) × ( W x h ↔ 拼接 W h h ) (\textbf{X}_t\xleftrightarrow{拼接}\textbf{H}_{t\text{-}1})\text{×}(\textbf{W}_{xh}\xleftrightarrow{拼接}\textbf{W}_{hh}) (Xt拼接 Ht-1)×(Wxh拼接 Whh)
- 输出层:输出 O t = ( H t W h q + b q ) ∈ R n × q \textbf{O}_t\text{=}(\textbf{H}_t\textbf{W}_{hq}\text{+}\textbf{b}_q)\text{∈}\mathbb{R}^{n\text{×}q} Ot=(HtWhq+bq)∈Rn×q
- 循环机制:
- 参数上: W x h ∈ R d × h / W h h ∈ R h × h / W h q ∈ R h × q / b q ∈ R 1 × q / b h ∈ R 1 × h \textbf{W}_{xh}\text{∈}\mathbb{R}^{d\text{×}h}/\textbf{W}_{hh}\text{∈}\mathbb{R}^{h\text{×}h}/\textbf{W}_{hq}\text{∈}\mathbb{R}^{h\text{×}q}/\textbf{b}_q\text{∈}\mathbb{R}^{1\text{×}q}/\textbf{b}_h\text{∈}\mathbb{R}^{1\text{×}h} Wxh∈Rd×h/Whh∈Rh×h/Whq∈Rh×q/bq∈R1×q/bh∈R1×h每个时间步相同
- 隐藏态:每个时间步隐藏态的使用方式一样,当前时间步 H t \textbf{H}_t Ht也会用于下一时间步 H t \textbf{H}_t Ht的计算
2️⃣基于 RNN \text{RNN} RNN的字符级语言模型
- 结构:用当前字符预测下一个字符 → \text{→} →批大小 = 1 \text{=}1 =1时当前时间步标签为下一字符(原始序列右移一位)
- 输出/误差:对每个时间步进行 Softmax \text{Softmax} Softmax,并用交叉熵计算其与标签的误差
- 隐藏状态:隐藏状态 O t \textbf{O}_t Ot由 t t t时间步及其之前的文本序列决定
3️⃣ RNN \text{RNN} RNN的通过时间反向传播( BBTT \text{BBTT} BBTT)
- 损失计算:每一时间步输出与标签的(交叉熵)损失 L t → L_t \text{→} Lt→累计每一时间步损失 L = ∑ t = 1 T L t \displaystyle{}L\text{=}\sum_{t=1}^T L_t L=t=1∑TLt
- 计算梯度:将每一个时间步展开为一个前馈神经网络
- 输出层:每时间步 ∂ L ∂ W h q = ∑ t = 1 T ∂ L t ∂ O t ⋅ ∂ O t ∂ W h q \displaystyle{}\cfrac{\partial L}{\partial \mathbf{W}_{h q}}\text{=}\sum_{t\text{=}1}^T \cfrac{\partial L_t}{\partial \mathbf{O}_t} \cdot \cfrac{\partial \mathbf{O}_t}{\partial \mathbf{W}_{h q}} ∂Whq∂L=t=1∑T∂Ot∂Lt⋅∂Whq∂Ot以及 ∂ L ∂ b q = ∑ t = 1 T ∂ L t ∂ O t ⋅ ∂ O t ∂ b q \displaystyle{}\cfrac{\partial L}{\partial \mathbf{b}_q}\text{=}\sum_{t\text{=}1}^T \cfrac{\partial L_t}{\partial \mathbf{O}_t} \cdot \cfrac{\partial \mathbf{O}_t}{\partial \mathbf{b}_q} ∂bq∂L=t=1∑T∂Ot∂Lt⋅∂bq∂Ot
- 隐藏层:每时间步 ∂ L ∂ H t = ∑ k = t T ∂ L k ∂ H t → 沿时间步展开 ∂ L k ∂ H t = ∂ L k ∂ O k ⋅ ∂ O k ∂ H k ⋅ ∏ j = t + 1 k ∂ H j ∂ H j − 1 \displaystyle{}\cfrac{\partial L}{\partial \mathbf{H}_t}\text{=}\sum_{k=t}^T \cfrac{\partial L_k}{\partial \mathbf{H}_t}\xrightarrow{沿时间步展开}\cfrac{\partial L_k}{\partial \mathbf{H}_t}\text{=}\cfrac{\partial L_k}{\partial \mathbf{O}_k} \cdot \cfrac{\partial \mathbf{O}_k}{\partial \mathbf{H}_k} \cdot \prod_{j=t+1}^k \cfrac{\partial \mathbf{H}_j}{\partial \mathbf{H}_{j-1}} ∂Ht∂L=k=t∑T∂Ht∂Lk沿时间步展开∂Ht∂Lk=∂Ok∂Lk⋅∂Hk∂Ok⋅j=t+1∏k∂Hj−1∂Hj
- 更新隐藏层参数:
- 反向累积: ∂ L ∂ W h h = ∑ t = 1 T ∂ L ∂ H t ⋅ ∂ H t ∂ W h h \displaystyle{}\cfrac{\partial L}{\partial \mathbf{W}_{h h}}\text{=}\sum_{t=1}^T \cfrac{\partial L}{\partial \mathbf{H}_t} \cdot \cfrac{\partial \mathbf{H}_t}{\partial \mathbf{W}_{h h}} ∂Whh∂L=t=1∑T∂Ht∂L⋅∂Whh∂Ht以及 ∂ L ∂ b h = ∑ t = 1 T ∂ L ∂ H t ⋅ ∂ H t ∂ b h \displaystyle{}\cfrac{\partial L}{\partial \mathbf{b}_h}\text{=}\sum_{t=1}^T \cfrac{\partial L}{\partial \mathbf{H}_t} \cdot \cfrac{\partial \mathbf{H}_t}{\partial \mathbf{b}_h} ∂bh∂L=t=1∑T∂Ht∂L⋅∂bh∂Ht在时间维度累积
- 参数更新:累加所有时间步的梯度后,(使用 SND/Adam \text{SND/Adam} SND/Adam)更新权重参数
⚠️ BBTT \text{BBTT} BBTT存在梯度消失/爆炸的问题,即梯度因反复相乘而剧烈减小/增大,而 LSTM \text{LSTM} LSTM则有效解决之2.2. LSTM \textbf{2.2. LSTM} 2.2. LSTM结构: 门控记忆元
1️⃣各单元结构:对于输入 X t ∈ R n × d \mathbf{X}_t \text{∈} \mathbb{R}^{n \text{×} d} Xt∈Rn×d和隐状态 H t - 1 ∈ R n × h \mathbf{H}_{t\text{-}1}\text{∈}\mathbb{R}^{n \text{×} h} Ht-1∈Rn×h
单元类型 计算方法 输入权重 隐藏权重 偏置 F t ∈ R n × h {}\mathbf{F}_t\text{∈}\mathbb{R}^{n \text{×} h} Ft∈Rn×h σ ( X t W x f + H t - 1 W h f + b f ) {}\sigma\left(\mathbf{X}_t \mathbf{W}_{x f}+\mathbf{H}_{t\text{-}1} \mathbf{W}_{h f}+\mathbf{b}_f\right) σ(XtWxf+Ht-1Whf+bf) W x f ∈ R d × h {}\mathbf{W}_{x f} \text{∈} \mathbb{R}^{d \text{×} h} Wxf∈Rd×h W h f ∈ R h × h {}\mathbf{W}_{h f} \text{∈} \mathbb{R}^{h \text{×} h} Whf∈Rh×h b f ∈ R 1 × h {}\mathbf{b}_f \text{∈} \mathbb{R}^{1 \text{×} h} bf∈R1×h I t ∈ R n × h {}\mathbf{I}_t\text{∈}\mathbb{R}^{n \text{×} h} It∈Rn×h σ ( X t W x i + H t - 1 W h i + b i ) {}\sigma\left(\mathbf{X}_t \mathbf{W}_{x i}+\mathbf{H}_{t\text{-}1} \mathbf{W}_{h i}+\mathbf{b}_i\right) σ(XtWxi+Ht-1Whi+bi) W x i ∈ R d × h {}\mathbf{W}_{xi} \text{∈} \mathbb{R}^{d \text{×} h} Wxi∈Rd×h W h i ∈ R h × h {}\mathbf{W}_{h i} \text{∈} \mathbb{R}^{h \text{×} h} Whi∈Rh×h b i ∈ R 1 × h {}\mathbf{b}_i \text{∈} \mathbb{R}^{1 \text{×} h} bi∈R1×h O t ∈ R n × h {}\mathbf{O}_t\text{∈}\mathbb{R}^{n \text{×} h} Ot∈Rn×h σ ( X t W x o + H t - 1 W h o + b o ) {}\sigma\left(\mathbf{X}_t \mathbf{W}_{x o}+\mathbf{H}_{t\text{-}1} \mathbf{W}_{h o}+\mathbf{b}_o\right) σ(XtWxo+Ht-1Who+bo) W x o ∈ R d × h {}\mathbf{W}_{x o} \text{∈} \mathbb{R}^{d \text{×} h} Wxo∈Rd×h W h o ∈ R h × h {}\mathbf{W}_{h o} \text{∈} \mathbb{R}^{h \text{×} h} Who∈Rh×h b o ∈ R 1 × h {}\mathbf{b}_o \text{∈} \mathbb{R}^{1 \text{×} h} bo∈R1×h C ~ t ∈ R n × h {}\tilde{\mathbf{C}}_t\text{∈}\mathbb{R}^{n \text{×} h} C~t∈Rn×h tanh ( X t W x c + H t - 1 W h c + b c ) {}\text{tanh}\left(\mathbf{X}_t \mathbf{W}_{x c}+\mathbf{H}_{t\text{-}1} \mathbf{W}_{h c}+\mathbf{b}_c\right) tanh(XtWxc+Ht-1Whc+bc) W x c ∈ R d × h {}\mathbf{W}_{x c} \text{∈} \mathbb{R}^{d \text{×} h} Wxc∈Rd×h W h o ∈ R h × c {}\mathbf{W}_{h o} \text{∈} \mathbb{R}^{h \text{×} c} Who∈Rh×c b c ∈ R 1 × h {}\mathbf{b}_c \text{∈} \mathbb{R}^{1 \text{×} h} bc∈R1×h 2️⃣记忆元: C t = F t ⊙ C t - 1 + I t ⊙ C ~ t \mathbf{C}_t\text{=}\mathbf{F}_t\text{⊙}\mathbf{C}_{t\text{-}1}\text{+}\mathbf{I}_t \text{⊙}\tilde{\mathbf{C}}_t Ct=Ft⊙Ct-1+It⊙C~t
操作 含义 F t ⊙ C t - 1 \mathbf{F}_t\text{⊙}\mathbf{C}_{t\text{-}1} Ft⊙Ct-1 忘掉多少过去的记忆元 C t - 1 ∈ R n × h \mathbf{C}_{t\text{-}1}\text{∈}\mathbb{R}^{n \text{×} h} Ct-1∈Rn×h I t ⊙ C ~ t \mathbf{I}_t \text{⊙}\tilde{\mathbf{C}}_t It⊙C~t 采纳多少当前的新数据 C ~ t ∈ R n × h {}\tilde{\mathbf{C}}_t\text{∈}\mathbb{R}^{n \text{×} h} C~t∈Rn×h
- 当遗忘门 F t = 1 n × h \mathbf{F}_t\text{=}\textbf{1}_{n \text{×} h} Ft=1n×h且输入门 I t = 0 n × h \mathbf{I}_t\text{=}\textbf{0}_{n \text{×} h} It=0n×h时,表示过去的记忆元 C t - 1 \mathbf{C}_{t\text{-}1} Ct-1完全传递到当前步
3️⃣隐状态: H t = O t ⊙ tanh ( C t ) → H t ∈ ( − 1 , 1 ) \mathbf{H}_t\text{=}\mathbf{O}_t\text{⊙}\tanh \left(\mathbf{C}_t\right)\text{→}\mathbf{H}_t\text{∈}(-1,1) Ht=Ot⊙tanh(Ct)→Ht∈(−1,1),即只要输出门保持 1 → 1\text{→} 1→效传递记以更新隐状态
2.3. Encoder-Decoder \textbf{2.3. Encoder-Decoder} 2.3. Encoder-Decoder架构

结构 功能 举例 编码器 变长序列 → 编码 \xrightarrow{编码} 编码定长向量(隐含状态) 原始文本 → 编码 \xrightarrow{编码} 编码🤪🤪🤪 解码器 定长向量 → 解码 \xrightarrow{解码} 解码变长序列 🤪🤪🤪 → 解码 \xrightarrow{解码} 解码翻译文本


3. \textbf{3. } 3. 注意力机制与 Transformer \textbf{Transformer} Transformer
3.1. \textbf{3.1. } 3.1. 注意力机制
1️⃣生物学中的注意力提示
类型 含义 基础 非自主提示( Bottom-up \text{Bottom-up} Bottom-up) 自然而然地注意到环境中显眼的物体 物体的突出性 自主性提示( Top-down \text{Top-down} Top-down) 由自我意识主关推动的对于某事物的注意 自主性提示 2️⃣注意力机制的要素
- Query/Key/Value \text{Query/Key/Value} Query/Key/Value架构

Item \textbf{Item} Item 相当于 含义 Value \text{Value} Value 感官输入 实际输入的信息(感官) Key \text{Key} Key 非自主提示 每个输入感官都有的非自住性提示 ( Value ↔ 一一对应 Key ) (\text{Value}\xleftrightarrow{一一对应}\text{Key}) (Value一一对应 Key) Query \text{Query} Query 自主性提示 引导注意力机制聚焦于最相关的感官输入 - 注意力汇聚函数: f ( x ) = ∑ i = 1 n α ( x , x i ) × y i \displaystyle{}f(x)\text{=}\sum_{i=1}^n \alpha(x,x_i) \text{×} y_i f(x)=i=1∑nα(x,xi)×yi
汇聚示例 输出 注意力评分函数 平均汇聚 f ( x ) = ∑ i = 1 n 1 n y i f(x)\text{=}\displaystyle{} \sum_{i=1}^n \cfrac{1}{n}y_i f(x)=i=1∑nn1yi N/A \text{N/A} N/A 非参数汇聚 f ( x ) = ∑ i = 1 n Softmax ( − 1 2 ( x − x i ) 2 ) y i f(x)\text{=}\displaystyle{}\sum_{i=1}^n \text{Softmax}\left(-\cfrac{1}{2}\left(x-x_i\right)^2 \right) y_i f(x)=i=1∑nSoftmax(−21(x−xi)2)yi − 1 2 ( x − x i ) 2 -\cfrac{1}{2}\left(x-x_i\right)^2 −21(x−xi)2 参数汇聚 f ( x ) = ∑ i = 1 n Softmax ( − 1 2 ( ( x − x i ) w ) 2 ) y i f(x)\text{=}\displaystyle{}\sum_{i=1}^n \text{Softmax}\left(-\cfrac{1}{2}\left(\left(x-x_i\right) w\right)^2\right) y_i f(x)=i=1∑nSoftmax(−21((x−xi)w)2)yi − 1 2 ( ( x − x i ) w ) 2 -\cfrac{1}{2}\left(\left(x-x_i\right) w\right)^2 −21((x−xi)w)2
- x / k i x/k_i x/ki接近 →Softmax \text{→}\text{Softmax} →Softmax(权)值变大 → v i \text{→}v_i →vi对结果贡献变大(获得更多注意力)
3️⃣注意力评分函数:对于 q ∈ R q / k i ∈ R k / v i ∈ R v \mathbf{q} \text{∈} \mathbb{R}^q/\mathbf{k}_i \text{∈} \mathbb{R}^k/\mathbf{v}_i \text{∈} \mathbb{R}^v q∈Rq/ki∈Rk/vi∈Rv有
- 数学模型:
- 评分函数: a ( q , k i ) ∈ R a(\mathbf{q}, \mathbf{k}_i)\text{∈} \mathbb{R} a(q,ki)∈R
- 权值函数: α ( q , k i ) = Softmax ( a ( q , k i ) ) = e a ( q , k i ) ∑ j = 1 n e a ( q , k i ) ∈ R \displaystyle{}\alpha\left(\mathbf{q}, \mathbf{k}_i\right)\text{=}\operatorname{Softmax}\left(a\left(\mathbf{q}, \mathbf{k}_i\right)\right)\text{=}\cfrac{e^{a(\mathbf{q}, \mathbf{k}_i)}}{\displaystyle{}\sum_{j\text{=}1}^n e^{a(\mathbf{q}, \mathbf{k}_i)}} \text{∈} \mathbb{R} α(q,ki)=Softmax(a(q,ki))=j=1∑nea(q,ki)ea(q,ki)∈R,其中 ∑ i = 1 n α ( q , k i ) = 1 \displaystyle{}\sum_{i=1}^{n}\alpha\left(\mathbf{q}, \mathbf{k}_i\right)\text{=}1 i=1∑nα(q,ki)=1
- 汇聚函数: f ( q , ( k 1 , v 1 ) , … , ( k n , v n ) ) = ∑ i = 1 n α ( q , k i ) v i ∈ R v \displaystyle{}f\left(\mathbf{q},\left(\mathbf{k}_1, \mathbf{v}_1\right), \ldots,\left(\mathbf{k}_n, \mathbf{v}_n\right)\right)\text{=}\sum_{i\text{=}1}^n \alpha\left(\mathbf{q}, \mathbf{k}_i\right) \mathbf{v}_i \text{∈} \mathbb{R}^v f(q,(k1,v1),…,(kn,vn))=i=1∑nα(q,ki)vi∈Rv
- 关于 Softmax \text{Softmax} Softmax:
- 本质:本质上得到的是概率分布 → 与 v i 相乘 v i \xrightarrow{与\textbf{v}_i相乘}\textbf{v}_i 与vi相乘vi的加权平均
- 掩码:由于 Softmax(-∞)=0 \text{Softmax(-∞)=0} Softmax(-∞)=0,故可 Softmax ( A ) → A → 部分位设为-∞ 忽略不必要元素 ( 如无用词元 ) A ′ Softmax ( A ′ ) \text{Softmax}(\textbf{A})\xrightarrow{\large\textbf{A}\xrightarrow[部分位设为\text{-∞}]{忽略不必要元素(如无用词元)}\textbf{A}^{\prime}}\text{Softmax}(\textbf{A}^{\prime}) Softmax(A)A忽略不必要元素(如无用词元)部分位设为-∞A′Softmax(A′)
- 缩放点积:可高效计算的评分函数
- 单查询:对 q ∈ R d \mathbf{q}\text{∈}\mathbb{R}^d q∈Rd和 k ∈ R d \mathbf{k}\text{∈}\mathbb{R}^d k∈Rd(注意二者维度要相同),有 a ( q , k ) = q ⊤ k d ∈ R a(\mathbf{q}, \mathbf{k})\text{=}\cfrac{\mathbf{q}^{\top} \mathbf{k} }{\sqrt{d}}\text{∈} \mathbb{R} a(q,k)=dq⊤k∈R
- 批查询:对 n n n个查询 Q ∈ R n × d \mathbf{Q}\text{∈}\mathbb{R}^{n\text{×}d} Q∈Rn×d和 m m m个键值对 { K ∈ R m × d V ∈ R m × v → \begin{cases}\mathbf{K}\text{∈}\mathbb{R}^{m\text{×}d}\\\\\mathbf{V}\text{∈}\mathbb{R}^{m\text{×}v}\end{cases}\text{→} ⎩ ⎨ ⎧K∈Rm×dV∈Rm×v→有 Softmax ( Q K ⊤ d ) V ∈ R n × v \text{Softmax}\left(\cfrac{\mathbf{Q K}^{\top}}{\sqrt{d}}\right) \mathbf{V} \text{∈} \mathbb{R}^{n \text{×} v} Softmax(dQK⊤)V∈Rn×v
3.2. Transformer \textbf{3.2. Transformer} 3.2. Transformer注意力: 编码 → 输入 \xrightarrow{输入} 输入自注意力 → 组合 \xrightarrow{组合} 组合多头
1️⃣位置编码
- 流程:对含 n n n个词元的 d d d维嵌入 X ∈ R n × d → 位置嵌入矩阵 P ∈ R n × d X + P \textbf{X}\text{∈}\mathbb{R}^{n\text{×}d}\xrightarrow[位置嵌入矩阵]{\textbf{P}\text{∈}\mathbb{R}^{n\text{×}d}}\textbf{X}\text{+}\textbf{P} X∈Rn×dP∈Rn×d位置嵌入矩阵X+P,且 { p i , 2 j = sin ( i 1000 0 2 j / d ) p i , 2 j + 1 = cos ( i 1000 0 2 j / d ) \begin{cases}p_{i, 2 j}\text{=}\sin \left(\cfrac{i}{10000^{2 j / d}}\right)\\\\p_{i, 2 j+1}\text{=}\cos \left(\cfrac{i}{10000^{2 j / d}}\right)\end{cases} ⎩ ⎨ ⎧pi,2j=sin(100002j/di)pi,2j+1=cos(100002j/di)
- 意义:捕获绝对位置信息 + \text{+} +学习相对位置信息
2️⃣自注意力机制
- 自注意力结构: QKV \textbf{QKV} QKV皆由词嵌入得到

- 词嵌入:输入序列 X ∈ R n × d x → ( 位置 ) 嵌入 A ∈ R n × d a \textbf{X}\text{∈}\mathbb{R}^{n\text{×}d_x}\xrightarrow{(位置)嵌入}\textbf{A}\text{∈}\mathbb{R}^{n\text{×}d_a} X∈Rn×dx(位置)嵌入A∈Rn×da
- 线性变换: [ Q ∈ R n × d q K ∈ R n × d k V ∈ R n × d v ] = [ A W q A W k A W v ] 其中 { W q ∈ R d a × d q W k ∈ R d a × d k W v ∈ R d a × d v →皆为可学习参数 \begin{bmatrix} \textbf{Q}\text{∈}\mathbb{R}^{n\text{×}d_q}\\\textbf{K}\text{∈}\mathbb{R}^{n\text{×}d_k}\\\textbf{V}\text{∈}\mathbb{R}^{n\text{×}d_v} \end{bmatrix}\text{=}\begin{bmatrix} \textbf{A}\textbf{W}^{q}\\\textbf{A}\textbf{W}^{k}\\\textbf{A}\textbf{W}^{v} \end{bmatrix}其中\begin{cases}\textbf{W}^{q}\text{∈}\mathbb{R}^{d_a\text{×}d_q}\\\textbf{W}^{k}\text{∈}\mathbb{R}^{d_a\text{×}d_k}\\\textbf{W}^{v}\text{∈}\mathbb{R}^{d_a\text{×}d_v}\end{cases}\text{→}皆为可学习参数 Q∈Rn×dqK∈Rn×dkV∈Rn×dv = AWqAWkAWv 其中⎩ ⎨ ⎧Wq∈Rda×dqWk∈Rda×dkWv∈Rda×dv→皆为可学习参数
- 计算注意力:注意力分布 A =Softmax ( Q K ⊤ d k ) ∈ R n × n → 加权求和 与 V 线性变换 \mathcal{A}\text{=}\text{Softmax}\left(\cfrac{\mathbf{Q K}^{\top}}{\sqrt{d_k}}\right)\text{∈} \mathbb{R}^{n \text{×} n}\xrightarrow[加权求和]{与\textbf{V}线性变换} A=Softmax(dkQK⊤)∈Rn×n与V线性变换加权求和输出 A ^ = A V ∈ R n × d v \hat{\mathcal{A}}\text{=}\mathcal{A}\mathbf{V} \text{∈} \mathbb{R}^{n \text{×} d_v} A^=AV∈Rn×dv
- 比较: CNN/RNN/ \text{CNN/RNN/} CNN/RNN/自注意力机制
模型 结构 备注 CNN \text{CNN} CNN 一次只能感知到一个卷积核大小范围(此处为 3 \text{3} 3) RNN \text{RNN} RNN 对于输入序列是顺序重复(串行)处理,无法并行 自注意力 每个词可感知到其它任何词 → \text{→} →可并行处理 3️⃣多头注意力机制
- 结构:多个注意力头连结然后线性变换

- 头汇聚:输出 ← 全连接层 W o [ h 1 ⋮ h h ] ← 线性变换 ( 连结 ) 可学习参数 W o ∈ R p o h i = f ( W i ( q ) q , W i ( k ) k , W i ( v ) v ) ∈ R p v \xleftarrow{全连接层}\mathbf{W}_o\left[\begin{array}{c} \mathbf{h}_1 \\ \vdots \\ \mathbf{h}_h \end{array}\right]\xleftarrow[线性变换(连结)]{可学习参数\mathbf{W}_o\text{∈}\mathbb{R}^{p_o}}\mathbf{h}_i\text{=}f\left(\mathbf{W}_i^{(q)} \mathbf{q}, \mathbf{W}_i^{(k)} \mathbf{k}, \mathbf{W}_i^{(v)} \mathbf{v}\right)\text{∈}\mathbb{R}^{p_v} 全连接层Wo h1⋮hh 可学习参数Wo∈Rpo线性变换(连结)hi=f(Wi(q)q,Wi(k)k,Wi(v)v)∈Rpv
- 注意头: h i = f ( W i ( q ) q , W i ( k ) k , W i ( v ) v ) ∈ R p v ← 汇聚函数 f { W i ( q ) q ← 全连接层 可学习参数 W i ( q ) ∈ R p q × d q q W i ( k ) k ← 全连接层 可学习参数 W i ( k ) ∈ R p k × d k k W i ( v ) v ← 全连接层 可学习参数 W i ( v ) ∈ R p v × d v v \mathbf{h}_i\text{=}f\left(\mathbf{W}_i^{(q)} \mathbf{q}, \mathbf{W}_i^{(k)} \mathbf{k}, \mathbf{W}_i^{(v)} \mathbf{v}\right)\text{∈}\mathbb{R}^{p_v}\xleftarrow{汇聚函数f}\begin{cases} \mathbf{W}_i^{(q)}\mathbf{q}\xleftarrow[全连接层]{可学习参数\mathbf{W}_i^{(q)}\text{∈}\mathbb{R}^{p_q\text{×}d_q}}\mathbf{q}\\\\ \mathbf{W}_i^{(k)}\mathbf{k}\xleftarrow[全连接层]{可学习参数\mathbf{W}_i^{(k)}\text{∈}\mathbb{R}^{p_k\text{×}d_k}}\mathbf{k}\\\\ \mathbf{W}_i^{(v)}\mathbf{v}\xleftarrow[全连接层]{可学习参数\mathbf{W}_i^{(v)}\text{∈}\mathbb{R}^{p_v\text{×}d_v}}\mathbf{v} \end{cases} hi=f(Wi(q)q,Wi(k)k,Wi(v)v)∈Rpv汇聚函数f⎩ ⎨ ⎧Wi(q)q可学习参数Wi(q)∈Rpq×dq全连接层qWi(k)k可学习参数Wi(k)∈Rpk×dk全连接层kWi(v)v可学习参数Wi(v)∈Rpv×dv全连接层v
- 意义:每个头关注输入的不同部分 → \text{→} →表示比简单加权平均值更复杂的函数
3.3. Transformer \textbf{3.3. }\textbf{Transformer} 3.3. Transformer架构

1️⃣编码器与解码器
- 编码器:
- 层结构: n × n\text{×} n×(多头自注意力层 + \text{+} +前馈网络层)
- 残差连接: Multihead( X ) / Forward( X ) + X → \text{Multihead(}\textbf{X})/\text{Forward(}\textbf{X})\text{+}\textbf{X}\text{→} Multihead(X)/Forward(X)+X→输入 Add-Norm \text{Add-Norm} Add-Norm,目的在于防止梯度消失
- 解码器:
- 层结构: n × n\text{×} n×(多头自注意力层 + \text{+} +编码解码注意力中间层 + \text{+} +前馈网络层)
- 中间层: Q \textbf{Q} Q来自解码层, KV \textbf{KV} KV来自编码层
- 掩码:使得解码器只能考虑所在位置之前的位置,从而实现了自回归
2️⃣其它结构
- 基于位置的前馈网络:就是一个两层的 MLP \text{MLP} MLP,将词元位置的隐藏表示 → 转化 \xrightarrow{转化} 转化同维度新向量
- 加法和规范化组件:完成残差连接与层归一化(均值 =0 \text{=0} =0/方差 =1 \text{=1} =1)



魔乐社区(Modelers.cn) 是一个中立、公益的人工智能社区,提供人工智能工具、模型、数据的托管、展示与应用协同服务,为人工智能开发及爱好者搭建开放的学习交流平台。社区通过理事会方式运作,由全产业链共同建设、共同运营、共同享有,推动国产AI生态繁荣发展。
更多推荐


 7
 0
- 0


 已为社区贡献3条内容

所有评论(0)