登录社区云,与社区用户共同成长
邀请您加入社区
MAC代表主机,在发送完寄存器地址后,想要读取对方的PHY芯片,此时主机方的数据线要拉成高阻态(挂一个上拉电阻),这样对对方PHY芯片没有影响,PHY芯片从高阻态拉低以后就可以传输数据。因为在FPGA中,时钟上升沿和数据改变是同沿的,不满足PHY芯片的时序关系,因此要在内部i_clk时钟有一个180°的反相,输出phy_MDC;通过MDIO(输入输出数据引脚,可以读取,也可以写入,需要三态门控制)
交互(Interaction)交互(Interaction)是一种具体的行为元素,它用对象之间消息传递的方式说明行为发生过程的顺序和互相传递的信息。对交互进行说明的图主要是序列图(Sequence Diagram,在UMLL标准中还有使用时间图、通讯图或交互概览图对其进行说明,SysML标准只使用序列图)。作为一种行为,交互也是具有行为的基本特征:具有输入参数、返回参数;它可以作为一个模块(Blo
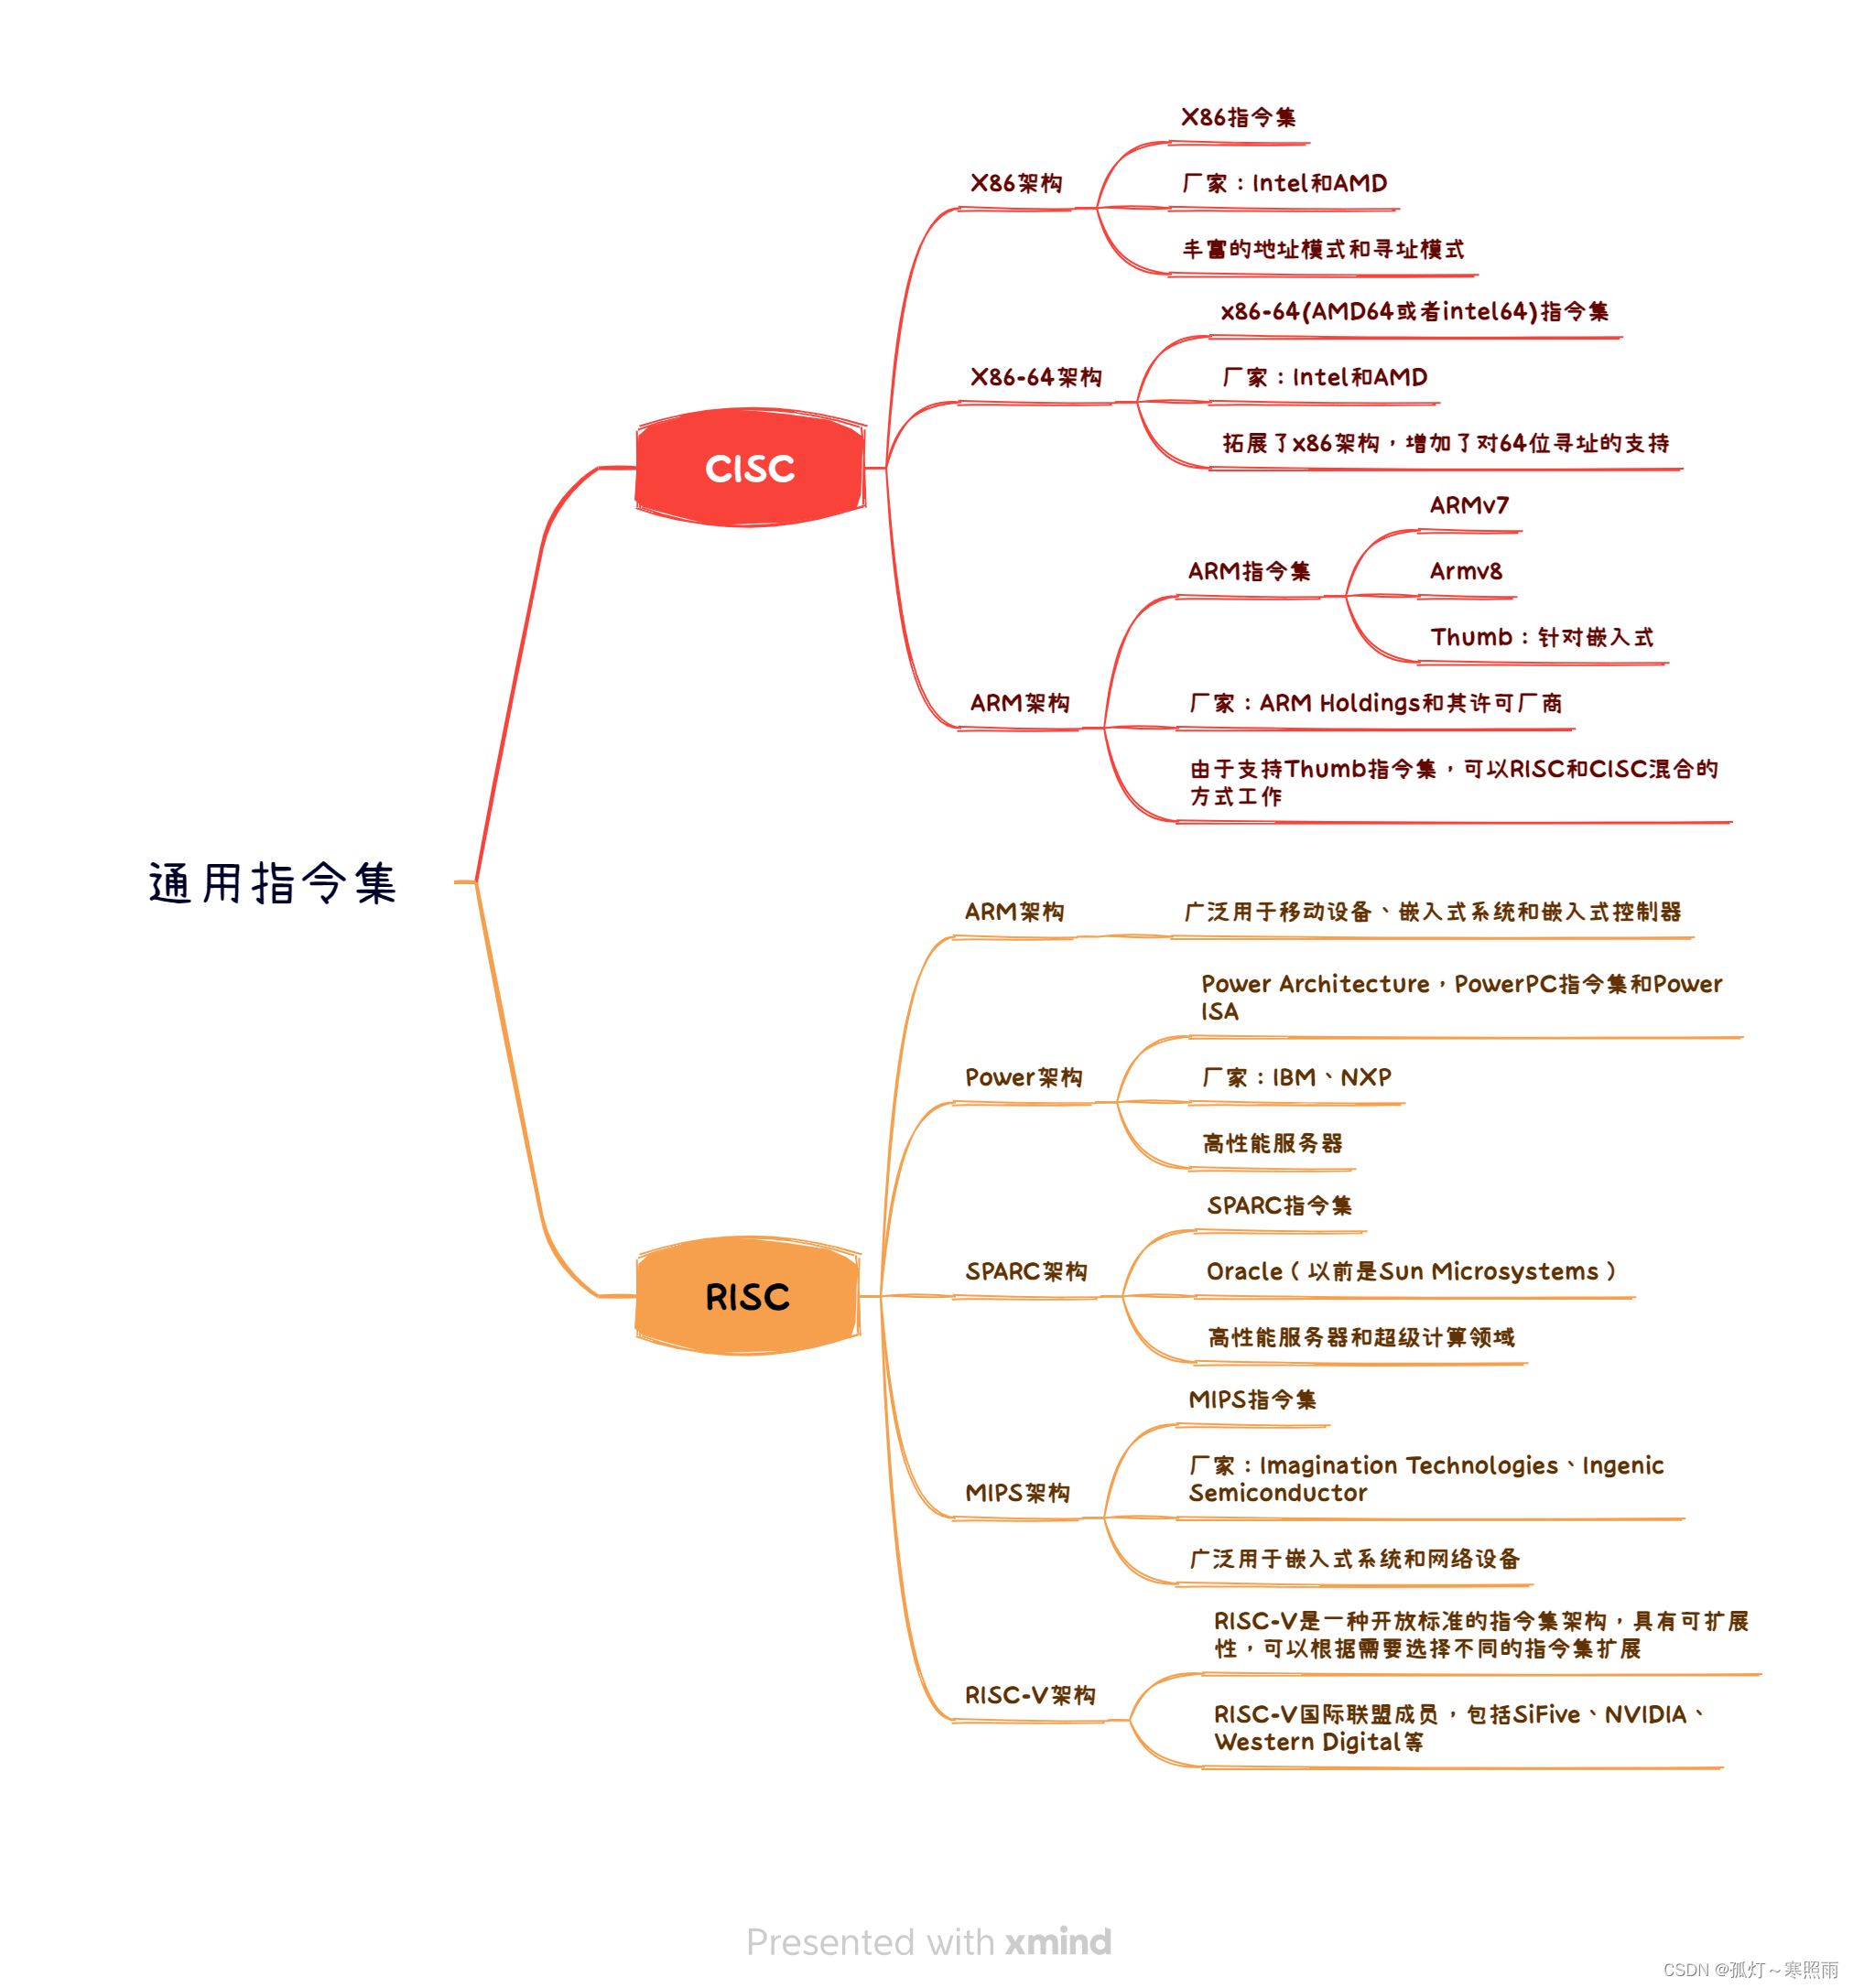
指令集与架构的关系
计算机体系结构课程作业
对于大多数图形渲染开发者,GPU是既熟悉又陌生的部件,熟悉的是每天都需要跟它打交道,陌生的是GPU就如一个黑盒,不知道其内部硬件架构,更无从谈及其运行机制。本文以NVIDIA作为主线,将试图全面且深入地剖析GPU的硬件架构及运行机制,主要涉及PC桌面级的GPU,不会覆盖移动端、专业计算、图形工作站级别的GPU。若要通读本文,要求读者有一定图形学的基础,了解GPU渲染管线,最好写过HLSL、GLSL
时钟树综合(CTS)主要通过命令操作实现,关键步骤包括:1)设置时钟树单元列表,确定可用缓冲器和反相器;2)通过ccopt配置文件优化时钟约束;3)生成时钟树规格并执行综合。完成CTS后可使用clock tree debugger查看延迟分布,并通过timingDesign检查时序,必要时用optDesign修复问题。CTS目标是构建低延迟、低偏斜的时钟网络,合理的约束配置直接影响综合效果。
随着物联网的发展,蓝牙已融入到我们生活的方方面面:手机、平板、手环、耳机、音响、智能灯泡、智能门铃、摄像机、冰箱、空调、洗衣机、血糖仪、键盘、鼠标等等。还有些非开源的蓝牙协议栈,它们主要由商业公司开发和维护,通常是为了提供更好的技术支持、认证、优化和专有功能,比如 windows 和苹果设备。关于蓝牙相关的芯片、协议栈、应用方案也因产品需求的不同而存在很大的差异,因而导致关于蓝牙相关的知识相对比较
plru最早是intel提出的,再此之前使用的有lru算法,lru算法中使用age_matrix记录了所有cache_wayage_matrix过于占面积了,4way的cache4*4=16bit,虽然可以压缩成3+2+1=6bit,但是plru在4way的cache只需要1+2=3bit,这个面积优势十分明显。cache line保存的plru表示最old的way_id的信号:plru_mess
玩这么多年电脑,其实用的CPU的好多东西都不知道,记录一下学到的。
对于开关电源中的Y电容在安规漏电流测试中的影响做了简要说明,并且提出了部分整改的思路,仅供大家作为参考。
常见安规认证测试之CE认证
本系列内容力求将nvdla的硬件设计和架构分析理清楚,如果有分析不对的请指出。前面已经分析了一篇信号和寄存器的文章,NVDLA硬件信号和架构设计整理一欢迎持续关注我对内核态代码的解读,链接分别如下:NVDLA内核态驱动代码整理一NVDLA内核态驱动代码整理二NVDLA内核态驱动代码整理三NVDLA内核态驱动代码整理四NVDLA内核态驱动代码整理五NVDLA内核态驱动代码整理六其中系列文章3有大量关
本文是对向往大神的文章的一个笔记。想阅读原文章移步博客园搜索向往原文章比较长,这是一个精简和自己的一些理解这篇文章要带着下面的问题去看1、GPU是如何与CPU协调工作的?2、GPU也有缓存机制吗?有几层?它们的速度差异多少?3、GPU的渲染流程有哪些阶段?它们的功能分别是什么?4、Early-Z技术是什么?发生在哪个阶段?这个阶段还会发生什么?会产生什么问题?如何解决?5、SIMD和SIMT是什么
Nvidia jetson nano硬件架构
裸机驱动(无操作系统)——由寄存器控制;Linux驱动。硬件:计算机系统:计算机架构:①冯诺依曼(指令、数据一起)②哈佛(指令、数据分开)
随着科技的发展与变革,闪存从SLC、MLC一直发展到了现在的TLC、QLC,自从TLC、QLC闪存进入大家视野开始,人们好像从未停止过对使用TLC闪存的固态硬盘寿命的担忧。为了亲自体验TLC闪存到底有多耐用,笔者花了19元从某宝购入了一块Ramaxel(记忆科技)的M.2 NGFF协议的2242尺寸的全新固态硬盘,我们一起来看看吧:买小容量的TLC固态硬盘真是煞费苦心,一方面要省钱,只能买小容量;
本系列内容力求将nvdla的硬件设计和架构分析理清楚,如果有分析不对的请指出。架构分析系列文章,链接分别如下:NVDLA内核态驱动代码整理三NVDLA硬件信号和架构设计整理一NVDLA硬件信号和架构设计整理二欢迎持续关注我对内核态代码的解读,链接分别如下:NVDLA内核态驱动代码整理一NVDLA内核态驱动代码整理二NVDLA内核态驱动代码整理三NVDLA内核态驱动代码整理四NVDLA内核态驱动代码
介绍了布线等长,差分等长的各个步骤与相关参数设置。
如果想更深入地了解GPU的设计细节、实现细节,可阅读GPU厂商定期发布的白皮书和各大高校、机构发布的论文。,虽然是多年前的视频,但比较系统、全面地讲解了GPU的机制和技术。
GPGPU architecture
声明:本文创作内容含代码均为个人创作所得,允许学习、传阅,不得用于商业用途##本文包含SHA-3从算法到硬件实现的全部#
获取虚拟机,包括软件。获取虚拟机,包括软件。
ARM64架构栈帧回溯简介以及demo演示
另外,如果单颗SOC算力不够,需要多颗SOC共同处理的话,则需要考虑多颗SOC的片间通讯,涉及到数据带宽的计算,高带宽的物理通道一般会选择以太网、PCIE等。是智驾域的核心控制器,对于分布在整车车身各处的各类传感器(如前后向摄像头,侧视摄像头,环视360摄像头、前后毫米波雷达、角雷达,前后激光雷达、补盲激光雷达,超声波雷达,惯导IMU、GNNS/RTK导航等)的数据都要汇集给智驾域控制器,由它进行
关于AD中logo的自制与导入各位访客们好! 这是我第一次使用 csdn 来发表一些东西,虽然我已加入csdn近两年了,但我习惯性将平日里的一些知识存在自己的脑海。最近偶尔回顾以往的学习经历,发现有一些知识脉络、操作步骤已不再清晰,为此我打算尽可能整一些笔记在csdn上,来记录我的成长。不干唠了,直接进入正题,目前我所知的将logo整入AD的PCB文件的方式共有四种,分别是使用AD.21版本、运行
北向接口是指与计算机网络中的核心设备(如路由器、交换机等)相连接的接口。它们通常位于网络的内部,从而将网络的内部设备连接起来,并允许数据在网络中传输。南向接口是指与计算机网络中的客户端设备(如个人电脑、服务器等)相连接的接口。它们通常位于网络的外部,从而将网络的外部设备连接起来,并允许数据在网络中传输。本文介绍了北向接口和南向接口的定义,以及它们之间的差异。北向接口通常位于网络的内部,其主要功能是
前言本来是用幕布写的,后来发现CSDN不用考虑资源大小的优点,重新编写一下,但格式还是幕布的格式,各位看官将就一下,另外本文全借鉴了一些大佬的文章,也在此列出,EFT●(脉冲群)EFT干扰的特点与实质●EFT由电感性负载(如继电器、接触器产生的传导干扰、高压开关切换产生的辐射干扰等)在断开时,由于开关触点间隙的绝缘击穿或触点弹跳等原因,在断开处产生的暂态骚扰。当电感性负载多次重复开关,则脉冲群又会
本系列力求将硬件模块设计方法和相关信号理清楚,便于后续改造。由于在《NVDLA内核态驱动代码整理三》中开坑开出来四个外部接口模块IRQCSBSRAMIFDBBIF,在阅读发现有大量信号介绍的部分,同时有大量的内部的寄存器方案,因此决定先把这部分整理完。以的架构作为开篇,引出外部接口。外部接口模块功能NVDLA中的某些状态要求向正在命令NVDLA的处理器异步报告,这些状态包括操作完成和错误条件。外部
1.哈佛结构是一种将程序指令的存储与数据的存储分开的存储器结构。首先,CPU在程序指令存储器中读取程序指令内容,解码后获得数据地址,然后在相应的数据存储器中读取数据,并进行下一步操作。除了上述Microchip公司的PIC系列芯片外,摩托罗拉公司的MC68系列、Zilog公司的Z8系列、ATMEL公司的AVR系列和安谋公司的ARM9、ARM10、ARM11、51单片机也属于哈佛结构。(2)、哈佛结
AFE指集成了ADC、放大器、基准源、激励电路、调制解调电路等的模拟系统,可以广泛应用于各类高精度测量领域,相对于ADC,AFE的集成度更高、功能更强大,一般与MCU共同使用。在处理链的最前面,即输入端,进行模拟信号的处理的电路。
USB2.0一致性测试方法_高速示波器
目录一、导言1.1 为何要了解GPU?1.2 内容要点1.3 带着问题阅读二、GPU概述2.1 GPU是什么?2.2 GPU历史2.2.1 NV GPU发展史2.2.2 N...
存储资源盘活系统通过提高资源利用率,优化资源成本,助力企业用户实现绿色转型。它是纯软件的存储控制器,能够安装在任意Linux服务器上,可以把各服务器中分散的磁盘整合成高性能的存储资源池,通过分布式双控制器架构保证了低延迟、高可用、易拓展的特性;通过完善的控制台、命令行与API来统一调度管理所有存储资源;通过强大的兼容性和独特的硬件异构特性充分利用全部存储资源。存储资源盘活系统的架构体系有两个核心:
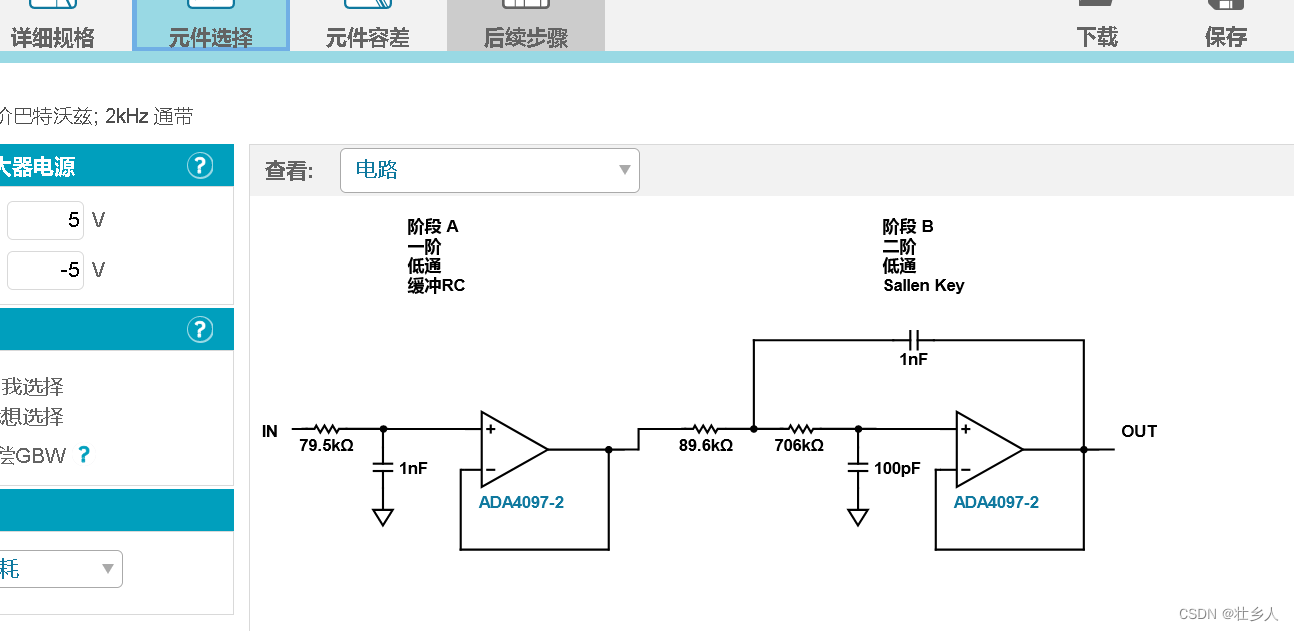
2022年全国大学生电子设计竞赛C题有源二分频音频放大器LTspice仿真电路分享
看来,通过双目摄像头提前扫描前方路面,获得图像及3D点云,结合元橡自主打造的MO-NET神经网络及DeepFusion技术架构,对车辆前方行驶路面的平整度和凹凸异物进行检测,输出高可靠高精度的方位、尺寸和高程信息,将相关结构化结果数据输出给车辆底盘主动悬架控制系统,从而实现减震和驾驶模式自动调节功能,达到全面提升车辆的驾乘舒适性和底盘安全性。反而由于稠密点云的输出(覆盖到150-200m的范围、精
USB4.0硬盘盒m2雷电4硬盘盒40G-nvme USB2.0扩展坞音频改装万兆网卡ASM2564。
VS100TX-A0VS100RX-A
芯片组一般由2块超大规模集成电路组成:芯片和南桥芯片。北桥芯片是存储控制中心( Memory Controller Hub ,MCH ),用于高速连接 CPU 、内存条、显卡,并与南桥芯片互连。南桥芯片是I/O控制中心(I/O Controller Hub , ICH ),主要与 PCI 总线槽、 USB 接口、硬盘接口、音频编解码器、 BIOS 和 CMOs 存储器等连接,并借助 SuperI/
首先我们要知道主存的地址空间,这个到底是什么东西,这个地址要能够描述主存空间的所有地址,所以这里MAR应该是64MB而不是32MB,所以MAR应该等于64MB也就是2的26次方位;
FPGA常见重要知识点积累,包括处理器和硬件编程语言Verilog等方面,以及在量子计算领域的应用
丽晶微电子国产替代
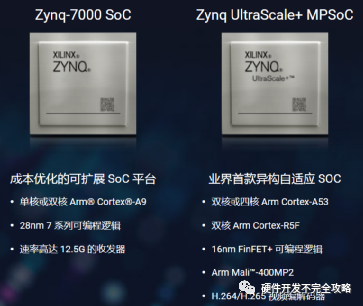
Zynq Ultrascale+ MPSOC硬件开发之与Zynq7000芯片资源对比说明及开发资料介绍官网关于Zynq Ultrascale+ MPSOC和Zynq7000两种器件对比介绍,Zynq Ultrascale+MPSOC(后边简称MPSOC)的APU处理器升级为Cortex-A53(ARM v8架构),增加实时处理内核RPU(Cortex-R5F),增加有GPU(Arm Mali™-
http://www.360doc.com/content/17/1206/21/48293593_710616459.shtml
这种情况下,就应该利用“面积换速度”的思想,至少复制 3 个处理模块,首先将输入数据进行串并转换,然后利用这三个模块并行处理分配的数据,然后将处理结果“并串变换”,就完成数据速率的要求。我们在整个处理模块的两端看,数据速率是 350Mb/s,而在 FPGA 的内部看,每个子模块处理的数据速率是 150Mb/s,其实整个数据的吞吐量的保障是依赖于 3 个子模块并行处理完成的,也就是说占用了更多的芯片
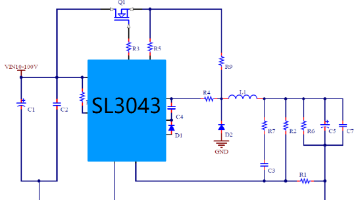
SL3043是一款高性能降压型开关稳压器芯片,具有10-120V超宽输入范围和10A大电流输出能力,转换效率超过90%。该芯片采用ESOP8封装,支持-40°C至+85°C工作温度,内置多重保护机制,适用于电动车、工业设备等高压场景。设计时需注意PCB布局优化和元件选型,特别适合48V/24V转12V/5V等高压降压应用。
特征•三个独立的低端/高端可配置通道•集成半桥功率级•R_ON(最大值)=250 mΩ@Tj=150°C•带内部TCR补偿的集成感测电阻器•负载电流测量范围=0 mA至1500 mA(典型)•当前设定点分辨率=11位•电流控制精度负载电流小于500 mA时为+/-5mA负载电流大于500毫安时为+/-1%•对大负载电源电压变化具有良好的抗扰性•集成的振幅和频率可编程的抖动发生器•用于输出控制、诊断
1. 如何判断新的巨头在哪里?产业选择:必须有大算力的产业,比如AI平台。技术优势:要有算法,数据带来的巨大优势,软硬件结合。协作能力:必须是一个开放的平台,不断演化。异构计算(英语:Heterogeneous computing),又译异质运算,主要是指使用不同类型指令集和体系架构的计算单元组成系统的计算方式。常见的计算单元类别包括CPU、GPU等协处理器、DSP、ASIC、FPGA等。异构计算
linux 查看内核版本号