登录社区云,与社区用户共同成长
邀请您加入社区
OMLSA算法推导LSA估计增益贝叶斯定理估计条件语音存在概率DD准则估计先验信噪比通过先验信噪比的软决策估计先验语音缺失概率MCRA方法估计底噪递归平滑最小值控制语音存在概率OM-LSA(Optimally-modified log-spectral amplitude)是经典的降噪算法,这里做一个学习总结,把中间的一些公式推导一下,写一些自己的想法,水平有限,欢迎指正。LSA估计增益OM-LS
ROS下实现语音交互-使用sound_play功能包
使用python实现的MFCC算法,用于比较音频之间的特征,结合DTW可以判断两音频是否相似。
测试用例评审总结:1、微信语音聊天功能测试 2、随便拿 一个物体进行测试。1、确定需求,解决需求疑问。2、了解被测试功能 的全过程,从细节了解每一个步骤和点。小任务:按住说话,每一个步骤 操作写成文字。5分钟。1、选择….2、进入聊天界面底部,单点左下角的小喇叭,出现【按住 说话】按钮,左下角变成3、长按 【按住说话】说出想要的话语,松开后自动提交录音信息到当前界面(时间,长度,秒),在录入信息的
近日,普林斯顿大学的研究人员开发了一种新算法HIFI-GAN,可以将低质量的录音转换为高质量的录音室音质音频。以往的人工智能音频处理方法通常只能改善录音音质的某一方面,如过滤背景噪音或去除混响,而这种新方法是一种多功能工具。“先前的方法主要集中在改善录音的可懂度,但就改善音质来说并不是很有优势”,论文的第一作者Jiaqi Su说。研究人员希望将他们的框架应用于实现完全自动化的实时语音增强。新算法H
封装了一个类代码如下。
event模块实现了事件循环,支持IO、timer、idle等功能,不同的平台有不同的实现,例如Linux使用epoll,Windows使用IOCP、Mac使用kqueue、Solaris使用evport;· 精妙小巧跨平台,基于configure/cmake自动生成的平台宏和编译器宏实现了跨平台的hatomic原子操作、hthread线程、hmutex线程同步等;· 无论是开发基于HTTP的服务
vos系统是什么?vos网络电话系统怎样搭建?
1、内容简介略293-可以交流、咨询、答疑2、内容说明略一、 实验原理:傅里叶变换建立了信号频谱的概念。所谓傅里叶分析即分析信号的频谱(频率构成)、频带宽度等。要想合成出一段音乐,就要了解该段音乐的基波频率、谐波构成等。因此,必须采用傅里叶变换这一工具。对于连续时间信号,其傅里叶变换为:由于其变换两边的函数 和都是连续函数, 不适合于计算机处理。 MATLAB语言提供了符号函数FOURIER来实现
核心思想是将语音的提取特征的帧进行前后联系,展开。进行了扩展,使得网络看到的特征范围更广。关于transpose函数的理解。关于unfold函数的理解。
现今信息技术飞速发展,语音技术源源不断地融入到各个领域,语音信号处理是人机接口的关键技术,已广泛应用于直播、在线通话、智能音箱等产品中。(落地应用)随着语音产品广泛落地应用,语音行业飞速发...
1、安装respeaker驱动命令行输入:sudo apt-get update#源更新sudo apt-get upgrade#已安装软件更新git clone https://github.com/respeaker/seeed-voicecard.git#下载声卡驱动包cd seeed-voicecard#新建声卡驱动文件夹sud
车载蓝牙的测试点包括:连接性:检查车载蓝牙是否能够连接到手机或其他设备音频质量:检查音频传输是否清晰,是否有杂音或噪音干扰语音控制:检查语音控制功能是否正常,是否能够识别用户的语音指令蓝牙范围:检查车载蓝牙的范围是否足够,是否能够在车内外正常使用兼容性:检查车载蓝牙是否能够兼容多种设备,并且能够正常使用自动重连:检查车载蓝牙是否能够自动重连到已经连接过的设备连接稳定性:...
明显, 电路的输出电压非常高。第一级震荡信号的幅度达到了3.6V。由此可见, 不同的反相器, 震荡特性有一定的差异。首先测量第一个反相器的输出信号。下面测量第二级反向的输出信号。可是令人感到惊讶的是, 第二级输出信号的幅度反而比起第一级的信号还小。下面使用手边由的两款CMOS 反相器测试电路。下面对比一下这两款反相器所搭建的晶体震荡期的效果。文测试了基于反相器的晶体震荡电路。发现CD4049可以在
本文主要介绍了RAG技术架构在AI编程中的创新应用及其面临的挑战。文章深入分析了RAG技术架构的兼容性、实时性和智能化水平等方面的问题,并提出了相应的改进措施,如加强标准化建设、引入实时数据处理技术和先进算法模型。同时,文章预测了RAG技术架构在智能化水平持续提升、跨领域融合加速以及数据隐私与安全保障方面的未来发展趋势。最后,文章回顾了RAG技术在AI编程领域的应用成果,并展望了其广阔的应用前景,
如下:使用科大讯飞语音识别
07|如何通过算法自动快速地消除回声?现在将会看看语音交互或者说音频通信领域的另一项不可或缺的技术:声学回声消除(Acoustic Echo Cancellation, 简称 AEC)。回声消除算法在实时音频互动链路中和很多其它模块以及硬件都会有耦合。主要看看实时音频互动链路中回声是如何产生的以及回声消除算法的基本原理。只要理解了原理,就很容易能明白公式的含义,从而能够记住公式的定义。回声产生的原
Entry和橙色状态之间的转换不能删除,一开始就跳到橙色块的状态。如果将橙色块直接设置旋转状态,那么一运行就自动跳到这里了,小球开局即跳,语音指令就没有意义了。这时我们回到Scene窗口,点击cube,在Animation窗口创建Property,我们这里想实现的效果是旋转,所以在Transform里面找Rotation。添加转换条件,当参数Rotating 为true时,发生从idle到Rota
脉冲编码调制:采样、量化、编码详细讲解和计算
前不久有些网友和同行问我关于 usb audio feedback 端点的种种问题,于是笔者在这里总结一下。
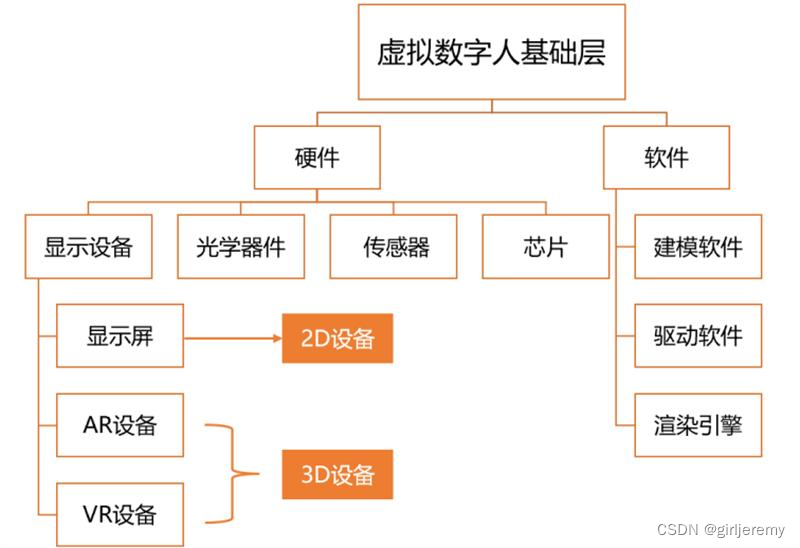
虚拟数字人基础技术架构包括“五横两纵”。“五横”是指用于数字人制作、交互的五大技术模块,即人物生成、人物表达、合成显示、识别感知、分析决策等模块。其中,人物生成,即人物建模方面 2D 数字人较为简单,3D 数字人需要额外使用三维建模技术。人物表达包括语音生成和动画生成。动画生成则包含驱动和渲染两大部分。“两纵”是指 2D、3D 数字人,2D 数字人和 3D 数字人在技术架构方面基本一致。主要介绍L
如果你想添加新的评估指标或者处理不同的输入格式,可以根据需要修改评分脚本。例如,为了计算字符错误率(CER),你可以引入另一个函数,并根据需要调整参数解析逻辑。
它的界面设计简洁,操作起来特别方便,不管是出国旅游还是和外国朋友聊天,都能轻松应对。而且,它还能记录翻译的内容,方便你随时查看,真的是很贴心的设计。它的翻译速度很快,而且准确率也很高,特别适合需要处理多种文件格式的小伙伴。而且,它的界面设计简洁,操作起来也很方便,真的是一个很实用的翻译工具。而且它的操作很简单,打开软件,点击语音翻译,就能多语种翻译了!不管是语音翻译还是文本翻译,都能轻松应对,真的
static int save_audio(int seq, char *audio_buff, int len){char file_name[64] = {0};int ret = 0;snprintf(file_name, sizeof(file_name), "/tmp/audio_file_%d", seq);FILE *fp = fopen(file_name, "w+");if (!
python sox wav音频去噪音频去噪效果很好!首先 你得录一段噪声 就是正常录音下 滋滋滋 的自然噪声命名为2.wav在终端中输入$sox 2.wav noisered noise.profile#会生成noise.profilesox ‘要被处理的音频.wav’‘处理完的输出音频.wav’noiserednoise.profile 0...
使用requests库进行远程文件获取利用io.BytesIO实现内存中的文件操作通过soundfile库解析音频文件信息def get_rec_info(url) : """识别录音文件采样率,声道信息Args:url (str): 音频文件URLReturns:dict: 包含采样率、声道数等信息的字典"""该函数接收一个音频文件的URL作为参数,返回包含音频信息的字典。
单声道音频是指音频信号只有一个音轨,无论播放的声音多少,所有的声音信息都会通过这个单一的音道输出。这意味着,音频的所有成分,如人声、音乐等,都会以同样的方式发送给听众。单声道通常通过一个扬声器播放,或者在耳机中通过两个耳塞传输相同的信号。双声道音频则包含左右两个音轨,可以同时播放两个不同的声音信号。左声道和右声道可以传递不同的声音信息,为听众提供立体声效果。在播放时,音响系统或耳机会通过左右两个扬
文章目录1. 使用 nanopc-T4 开发板采集音频2. 使用 Tyless外置usb麦克风录制声音3. 使用 ffrmpeg 将实时视频与音频合并并推流到 rtmp 服务器中4. 成功实现opencv采集图像与音频合并推送到rtmp1. 使用 nanopc-T4 开发板采集音频使用开发板采集音频时,总是报错,通过查阅很多资料后,逐渐有了一些头绪。使用 arecord -l 命令可以查看当前系统
Standard Intelligence 公司一周前发布了业界首个开源的对话音频生成基础模型 hertz-dev。这个总参数量达到 85 亿的全双工音频模型不仅性能出众,更是完全开源,让我们一起来深入了解它的技术细节。
如今,直播平台如火如荼,无论是游戏主播、音乐直播还是在线教学,清晰的音质和无延迟的传输都是至关重要的。比如,使用专用的AI降噪技术实时滤除背景噪音,保持直播的清晰度。直播中观众和主播的互动性越来越强,音频解决方案专家通过实时音频处理技术,可以实现多路音频信号的即时处理和传输。例如,在多位主播连麦的情况下,实时解决每位主播的声音混合、降噪和优化处理,确保声音不冲突,互动体验顺畅。通过直播音频解决方案
这几天在研究小程序里面使用讯飞语音平台的文字转语音功能,当连接成功后台返回地址后,地址明明是有的,但一直报错,附上错误提示:地址明明是正确的,在浏览器里可以打开,而且在代码里面把地址写死,不通过request获取的话就可以播放,着实让我研究了好几天,最后发现,其实只要在获取到地址后,播放调用音频的那里加个延时函数就好了,我猜测可能是因为程序执行的太快了,莫名其妙的bug,加个1秒的延时函数,就可以
(本文阅读时间:10分钟)易观:今年以来,随着人工智能技术不断实现突破迭代,生成式AI的话题多次成为热门,而人工智能内容生成(AIGC)的产业发展、市场反应与相应监管要求也受到了广泛关注。为了更好地探寻其在各行业落地应用的可行性和发展趋势,易观对AIGC产业进行了探索并将发布AIGC产业研究报告系列。在本期音频生成篇中,报告从音频技术的发展历程展开,回顾了拼接合成、参数合成、端到端合成三个关键阶段
今天和大家聊聊WebRTC中音频的那些事。WebRTC由语音引擎,视频引擎和网络传输三大模块组成,其中语音引擎是WebRTC中最具价值的技术之一,实现了音频数据的采集、前处理、编码、发送、接受、解码、混音、后处理、播放等一系列处理流程。音频引擎主要包含:音频设备模块ADM、音频编码器工厂、音频解码器工厂、混音器Mixer、音频前处理APM。音频工作机制想要系统的了解音频引擎,首先需要了解核心的实现
问题描述:在不同的使用场景,用户会有调节不同音频流音量的需求,APP可以调用接口setStreamVolume(int streamType, int index, int flags)来满足这一需求,但往往开发者并没有将streamType参数与当前场景正在播放的音频流类型设置一致,并且该接口可以截获系统的音量按键,导致用户使用APP时,按音量键调节音量后,当前的声音音量大小却没有变化。建议:由
尽管 SCTK 是一个强大的工具,但它也有一些限制,特别是在平台兼容性、输入格式要求、性能和资源消耗等方面。在使用 SCTK 之前,建议仔细阅读文档,并根据你的具体需求和环境选择合适的配置和使用方法。如果有任何疑问或遇到问题,可以联系 SCTK 的支持团队或查阅相关论坛和社区寻求帮助。
调用百度Api实现音频转写
日常工作学习中,有的朋友需要把音频文件中的语音转成文字,翻译成文稿。那如何能快速把音频转文字呢?下面教你几个在线音频转文字的方法,简单高效。
iphone音频输出The overwhelming majority of audio you listen to uses stereophonic (or stereo) sound. This means there are at least two separate audio channels: one for the right speaker, and one for the le
Adobe Premiere Pro 中提供了丰富的音频效果,帮助用户在视频编辑过程中调整和增强音频质量。这些音频效果涵盖了振幅与压限、延迟与回声、滤波器与 EQ、调制、降噪/恢复、混响、特殊效果、立体声声像、时间与变调等多个类别。通过合理使用这些效果,可以提高音频的清晰度、响度、空间感和整体品质。提示:点击下面的效果组名称或截图,即可访问该组里面的效果的详细说明。振幅与压限Amplitude a
语音分离:语音和非语音(噪音);人声分离:多个说话者的声音分离。Speaker Separation:输入一段声音序号,输出两段声音序号。目前聚焦在两个说话者声音序号混在一起、单一麦克风的情况下,训练和测试是不同的语者;输入和输出的声音长度是一样的,所以一般不用Seq2Seq模型。一、评估1.Signal-to-noise ratio(SNR)模型的输出和真实语音越接近就代表模型的性能越好;E越小
问题在采用PANN或者YAMNet框架进行学习的时候,没有梦话、磨牙等睡眠音频数据,在一些公开数据集上也没有找到(如果有哪位读者知道,麻烦给我在评论区留言,万分感谢)。解决办法针对上面数据缺失问题,拟准备用ShutEye App来采集,该App只能在苹果手机上使用,在应用商城的软件介绍如下:采用该App的主要原因是它可以直接进行分类,其类别有:...
音频处理是一个非常细分的方向,在我做的项目中音频是一个10年经验的工程师在调。比如说先前遇到一个哭声检测算法接入后无效果的问题,音频工程师最终给出的结果是麦克风录音导致失真音视频dsp做的主要是初始化Audio In、Out,在对应channel中接入算法。有些需求如削顶,音量太大导致喇叭发出类似坏了的兹拉兹拉声,就是将音频工程师给出的阈值之上的音量置为阈值音量以免损坏还有就是考虑到设备材料的固有
主动降噪技术与接口扩展、远程语音识别方案
它表示音频信号频谱的复杂程度或不确定性,可以用于识别音频中的不同声音,例如不同乐器的音色。谱熵特征通常与其他特征(如MFCC、零交叉率、能量、谱滚降点和谱通量)结合使用,以提高音频处理任务的性能。色度特征通常与其他特征(如MFCC、零交叉率、能量、谱滚降点、谱通量和谱熵)结合使用,以提高音频处理任务的性能。它表示音频信号频谱的变化程度,可以用于检测音频中的事件,例如音符的开始和结束。它表示音频信号
jdk内置的可以使用,不过呢就是声音太原始了,这是同过输入文字然后识别读出来的。最近在做项目,做外卖的,其中有一个功能就是接单,商家接单就需要用到这个功能。这个是通过文件播报的,可以在网上下载自己需要的音频。
声纹识别,又称说话人识别,是根据语音信号中的声纹特征来识别话者身份的过程,也是一种重要的生物认证手段。历经几十年的研究,当前声纹识别系统已取得了令人满意的性能表现,并在安防、司法、金融、家居等诸多领域中完成部署,有着广阔的应用前景。
大家在学习或办公的时候,总是需要整理大量的笔记,为了提高效率,会把这些内容提前录下来,再将其转换为文字进行使用,那么mp3音频如何转换成文字呢?其实方法很简单,下面就教你几个非常简单实用的mp3转文字方法。